


DeepSeek V3.1-Terminus повышает производительность ИИ


Кит вернулся!
Компания DeepSeek, китайский стартап в сфере искусственного интеллекта, выделившийся из гонконгской высокочастотной торговой фирмы High Flyer Capital Management (и использующий кита в качестве логотипа), возвращается сегодня с обновлением своей большой языковой модели: DeepSeek-V3.1-Terminus, улучшенной версией модели V3.1, выпущенной ровно два месяца назад и призванной повысить производительность и сократить количество ошибок, о которых сообщают пользователи.
Модель доступна незамедлительно через Hugging Face, приложения DeepSeek для iOS и Android, интерфейс программирования приложений (API) DeepSeek, а также оперативно добавляется в сторонние инструменты с открытым исходным кодом — AnyCoder на Hugging Face и бессерверный API NovitaLabs. Terminus демонстрирует заметно более высокую производительность в задачах использования агентских инструментов, включая программирование и оценки на основе поиска, а также снижает склонность предшественника (версии 3.1) вставлять китайские слова в ответы на английском языке.
Предыстория DeepSeek V3, 3.1 и теперь Terminus
Terminus создана на базе семейства моделей DeepSeek V3, первоначально представленного в декабре 2024 года, но быстро оказавшегося в тени уже месяц спустя из-за выхода DeepSeek R1 в январе 2025 года благодаря его высокой производительности на сторонних бенчмарках, особенно в области программирования, математики и задач, требующих многошагового «рассуждения» или обдумывания проблемы перед ответом.
Хотя R1 превосходит другие модели в логике, математике и структурированном решении проблем, он стоит дороже в использовании, чем V3, и может работать медленнее, так как более детально прорабатывает задачи, жертвуя скоростью ради точности. 
DeepSeek‑V3, напротив, является более «рабочей лошадкой» для общих бизнес-задач. Она эффективна, достаточно хороша (обладает высокой производительностью) во многих областях — написании текстов, суммировании, обслуживании клиентов в чате, базовом написании кода и общих рассуждениях. Ее дешевле запускать, она работает быстрее на более простых задачах и более универсальна в различных сценариях. Но когда проблема требует глубокой логики или многошаговых рассуждений, она не достигает такого уровня точности, как R1.
Когда первое обновление семейства V3, DeepSeek V3.1, было выпущено в августе 2025 года, оно быстро попало в заголовки газет благодаря своему масштабу и доступности.
Как сообщал VentureBeat, эта модель с 685 миллиардами параметров соответствовала или превосходила показатели проприетарных систем из США, оставаясь при этом полностью открытой в рамках мягкой и дружественной к бизнесу лицензии MIT, которая допускает коммерческое использование.
Этот релиз был воспринят многими как стратегический вызов подходу закрытых моделей и стал свидетельством растущего влияния Китая в сфере разработки передового ИИ.
Теперь DeepSeek V3.1-Terminus продолжает развивать универсальную языковую модель DeepSeek и предлагает возможности рассуждения, и всё это по-прежнему в рамках коммерчески жизнеспособной лицензии MIT.
Доработки на основе отзывов пользователей
Релиз Terminus сфокусирован на двух ключевых направлениях улучшений: языковой консистентности и эффективности агентских инструментов.
По заявлению DeepSeek, предыдущие модели временами смешивали китайский и английский текст или выдавали нечитаемые символы — проблемы, которые версия Terminus призвана устранить.
Обновление также усиливает собственные «агент кода» (Code Agent) и «агент поиска» (Search Agent) от DeepSeek — оба фреймворка ориентированы на конкретные задачи и позволяют пользователям задействовать лежащую в основе языковую модель Terminus для генерации кода и поиска/синтеза информации из интернета соответственно.
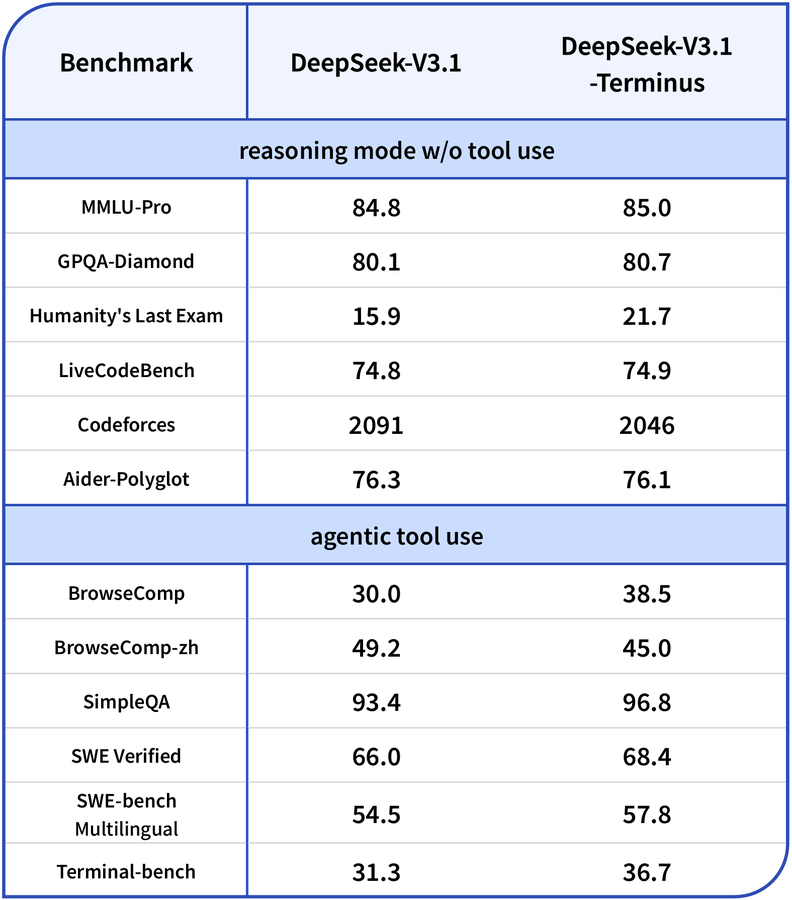
Эти улучшения отражены в результатах бенчмарков, которыми поделилась компания. В задачах использования агентских инструментов Terminus показывает явные улучшения.
Модель превосходит предшественницу в тестах SimpleQA (96.8 против 93.4), BrowseComp (38.5 против 30.0), SWE Verified (68.4 против 66.0), SWE-bench Multilingual (57.8 против 54.5) и Terminal-bench (36.7 против 31.3). Эти приросты свидетельствуют о повышенной производительности в реальных сценариях использования, где модели должны взаимодействовать с инструментами или внешними системами.
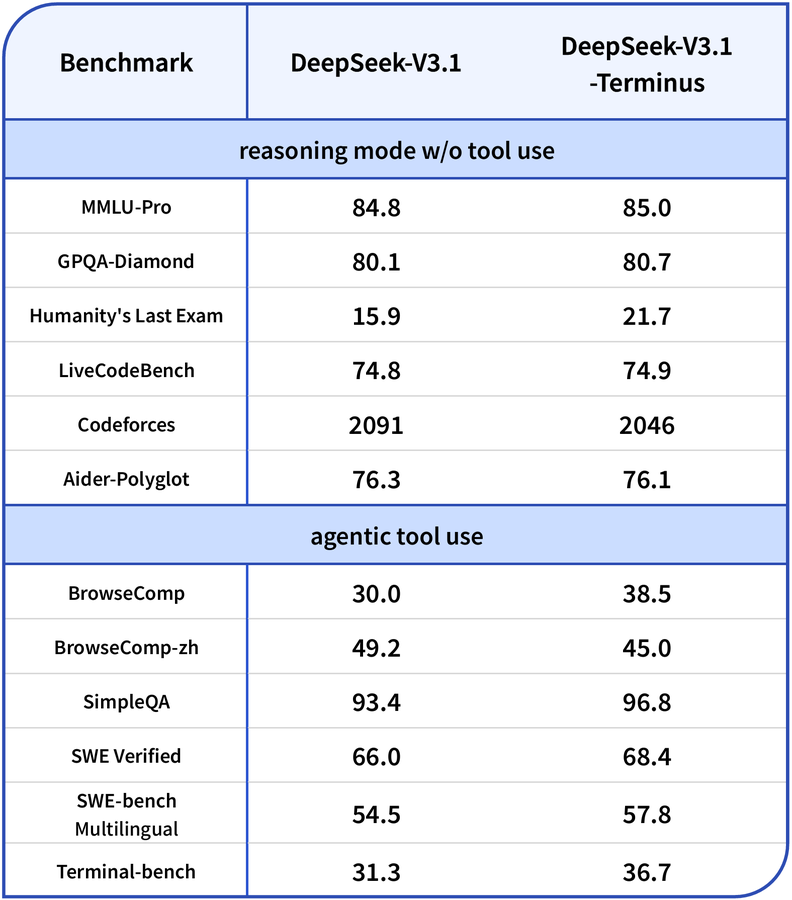
Результаты бенчмарков для DeepSeek-v3.1-Terminus
В чистых задачах на рассуждение без использования инструментов результаты более неоднозначны. Модель демонстрирует скромный рост в GPQA-Diamond (80.7 против 80.1) и Humanity’s Last Exam (21.7 против 15.9), в то время как в остальных тестах разница незначительна.
Интересно, что небольшое падение зафиксировано в бенчмарке Codeforces (2046 против 2091) — тесте, который обычно используется для оценки навыков программирования.
Два режима: чат и рассуждения (Reasoner)
DeepSeek-V3.1-Terminus предлагается в двух режимах работы:
Обе версии поддерживают длину контекста 128 000 токенов — это меньше показателей передовых моделей: 2 миллиона у Grok 4 Fast и 1 миллион у Google Gemini 2.5 Pro, а также 256 000 у GPT-5 от OpenAI, но тем не менее позволяет обрабатывать около 300–400 страниц текста за один цикл ввода/вывода.
Режим чата поддерживает вызов функций, дописывание текста FIM (Fill-in-the-Middle) и вывод в формате JSON, в то время как режим рассуждений (reasoner) исключает вызов функций и FIM, концентрируясь вместо этого на более глубоком контекстном анализе.
Если запрос к модели рассуждений включает использование инструментов, он автоматически перенаправляется на модель чата.
Максимальная длина выходных токенов также различается:
-
Режим чата поддерживает до 8 000 токенов (по умолчанию: 4 000)
-
Режим рассуждений поддерживает до 64 000 токенов (по умолчанию: 32 000)
Структура ценообразования API
Ценообразование для обоих режимов в API DeepSeek основано на использовании токенов и различает попадания и промахи кэша, то есть ситуации, когда система может обратиться к ранее сохраненной информации (попадание в кэш), снижая необходимость ввода новых токенов:
Оплата токенов рассчитывается на основе суммы входных и выходных токенов. Если доступны и пополненный, и предоставленный (бонусный) балансы, в первую очередь используется предоставленный баланс.
Тем не менее, учитывая, что DeepSeek — гонконгская компания, предприятиям в США и странах Запада следует провести юридическую проверку (due diligence), прежде чем полагаться на данный API. Разумеется, модель также доступна для использования, скачивания, изменения и кастомизации с Hugging Face, что могло бы в значительной степени снять любые опасения по поводу безопасности или политики использования данных. Однако в этом случае компании потребуется самостоятельно развернуть модель или арендовать хостинг для обеспечения ее инференса.
Для разработчиков, заинтересованных в самостоятельном хостинге, модель сохраняет ту же архитектуру, что и DeepSeek-V3.1. Обновленный демонстрационный код инференса включен в репозиторий для облегчения локального развертывания.
В текущей контрольной точке сохраняется одна известная техническая проблема: параметр self_attn.o_proj пока не соответствует формату данных шкалы UE8M0 FP8. DeepSeek отмечает, что это будет исправлено в одном из будущих релизов.
Что ждет DeepSeek в будущем?
Выпуск DeepSeek-V3.1-Terminus отражает непрерывные усилия компании по доработке продуктов на основе отзывов сообщества.
Хотя большинство улучшений носят эволюционный характер, возросшая производительность агентов и расширенный набор функций в режиме чата, вероятнее всего, пойдут на пользу разработчикам и исследователям, которым требуются стабильные возможности языковых моделей со встроенными инструментами.
Опираясь на импульс от предыдущего релиза V3.1, DeepSeek продолжает раздвигать границы как технических достижений, так и доступности.
Благодаря непрекращающемуся интересу со стороны мирового исследовательского сообщества и сообщества разработчиков, подход с открытым исходным кодом остается ключевым отличительным признаком компании в меняющемся ландшафте ИИ.
Тем временем в социальных сетях уже появились слухи о том, что в разработке находится DeepSeek V4. И конечно, все мы ждем преемника DeepSeek R1 — предположительно, DeepSeek R2. Тем не менее, некоторые обозреватели ранее заявляли, что постоянное внимание DeepSeek к серии V3 является свидетельством того, что компания столкнулась с трудностями при разработке более мощных моделей — несмотря на этот релиз и выход DeepSeek R1-0528 в мае 2025 года.




