


xMemory сокращает использование токенов LLM на 50%
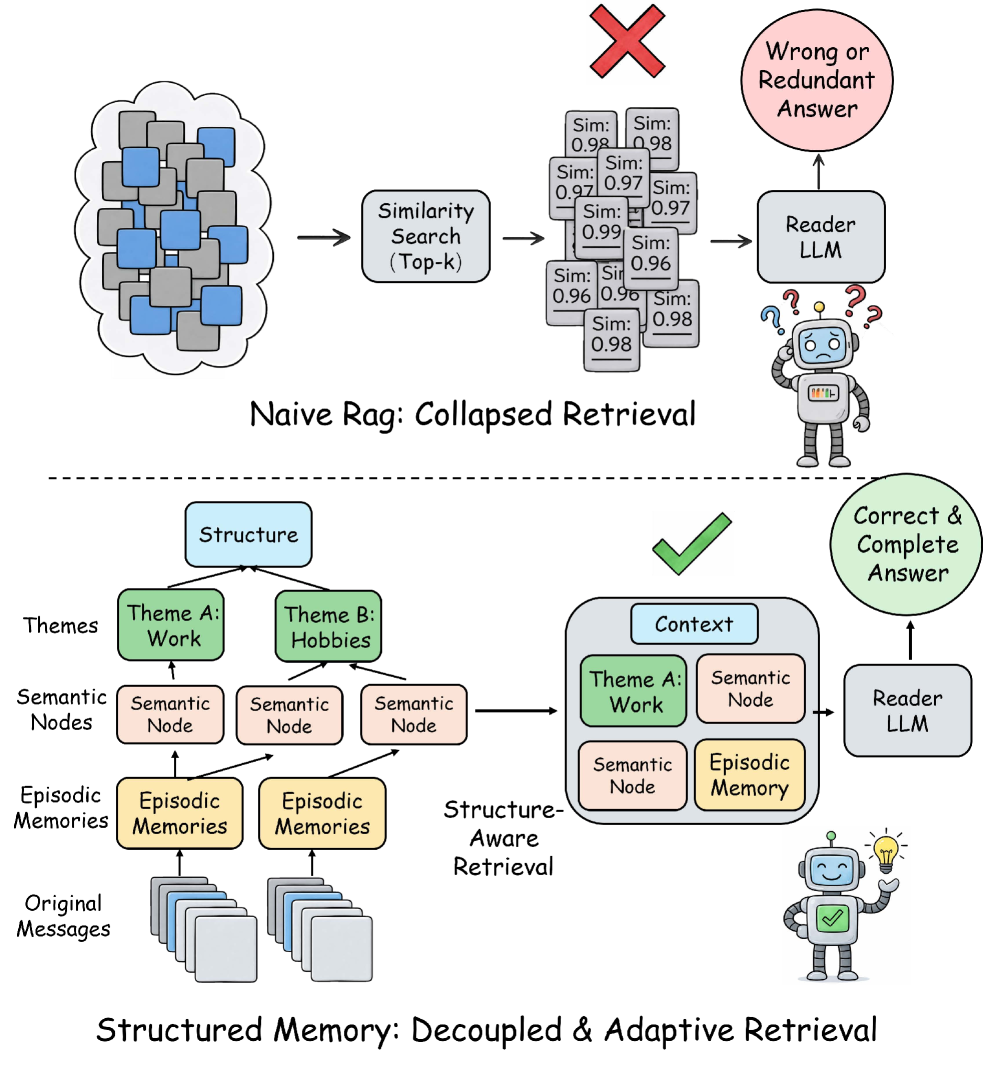


Стандартные пайплайны RAG дают сбой, когда компании пытаются использовать их для долгосрочного развертывания LLM-агентов, работающих в рамках множества сессий. Это критическое ограничение по мере роста спроса на постоянных ИИ-ассистентов.
xMemory, новая техника, разработанная исследователями из Королевского колледжа Лондона и Института Алана Тьюринга, решает эту проблему путем организации диалогов в исковую иерархию семантических тем.
Эксперименты показывают, что xMemory улучшает качество ответов и возможности долгосрочного рассуждения для различных языковых моделей (LLM), одновременно снижая затраты на инференс. По словам исследователей, в некоторых задачах этот подход сокращает использование токенов с более чем 9 000 до примерно 4 700 токенов на запрос по сравнению с существующими системами.
Для реальных корпоративных приложений, таких как персонализированные ИИ-ассистенты и инструменты поддержки принятия решений для множества сессий, это означает, что организации могут развертывать более надежные и контекстно-осведомленные агенты, способные поддерживать связную долгосрочную память без раздувания вычислительных затрат.
RAG не был создан для этого
Во многих корпоративных приложениях на базе LLM ключевое ожидание заключается в том, что эти системы будут поддерживать связность и персонализацию на протяжении долгих взаимодействий, состоящих из множества сессий. Для поддержки такого долгосрочного рассуждения одним из распространенных подходов является использование стандартного RAG: сохранение прошлых диалогов и событий, извлечение фиксированного числа лучших совпадений на основе сходства эмбеддингов и их объединение в контекстное окно для генерации ответов.
Однако традиционный RAG создан для больших баз данных, где извлекаемые документы весьма разнообразны. Главная задача здесь — отсеять совершенно нерелевантную информацию. Память ИИ-агента, напротив, представляет собой ограниченный и непрерывный поток разговора, а это означает, что хранимые фрагменты данных сильно коррелируют и часто содержат почти полные дубликаты.
Чтобы понять, почему простое увеличение контекстного окна не работает, рассмотрите, как стандартный RAG работает с таким понятием, как цитрусовые фрукты.
Представьте, что у пользователя было много разговоров, где он говорил что-то вроде «Я люблю апельсины», «Мне нравятся мандарины», а отдельно — другие разговоры о том, что именно считается цитрусовым фруктом. Традиционный RAG может рассматривать все это как семантически близкое и продолжать извлекать похожие «цитрусоподобные» фрагменты.
«Если извлечение сводится к тому кластеру, который является наиболее плотным в пространстве эмбеддингов, агент может получить множество очень похожих отрывков о предпочтениях, упустив при этом фактические категории, необходимые для ответа на реальный запрос», — рассказал VentureBeat Лин Гуй (Lin Gui), соавтор научной работы.
Распространенным решением для инженерных команд является применение пост-поисковой фильтрации (прунинга) или сжатия для отсеивания шума. Эти методы предполагают, что извлекаемые отрывки сильно различаются и что нерелевантные паттерны шума можно четко отделить от полезных фактов.
Этот подход оказывается неэффективным для памяти разговорных агентов, поскольку человеческий диалог «темпорально переплетен», пишут исследователи. Разговорная память в значительной степени опирается на соотнесения (коференции), эллипсисы и строгие временные зависимости. Из-за такой взаимосвязанности традиционные инструменты прунинга часто случайно удаляют важные части разговора, оставляя ИИ без жизненно важного контекста, необходимого для точных рассуждений.
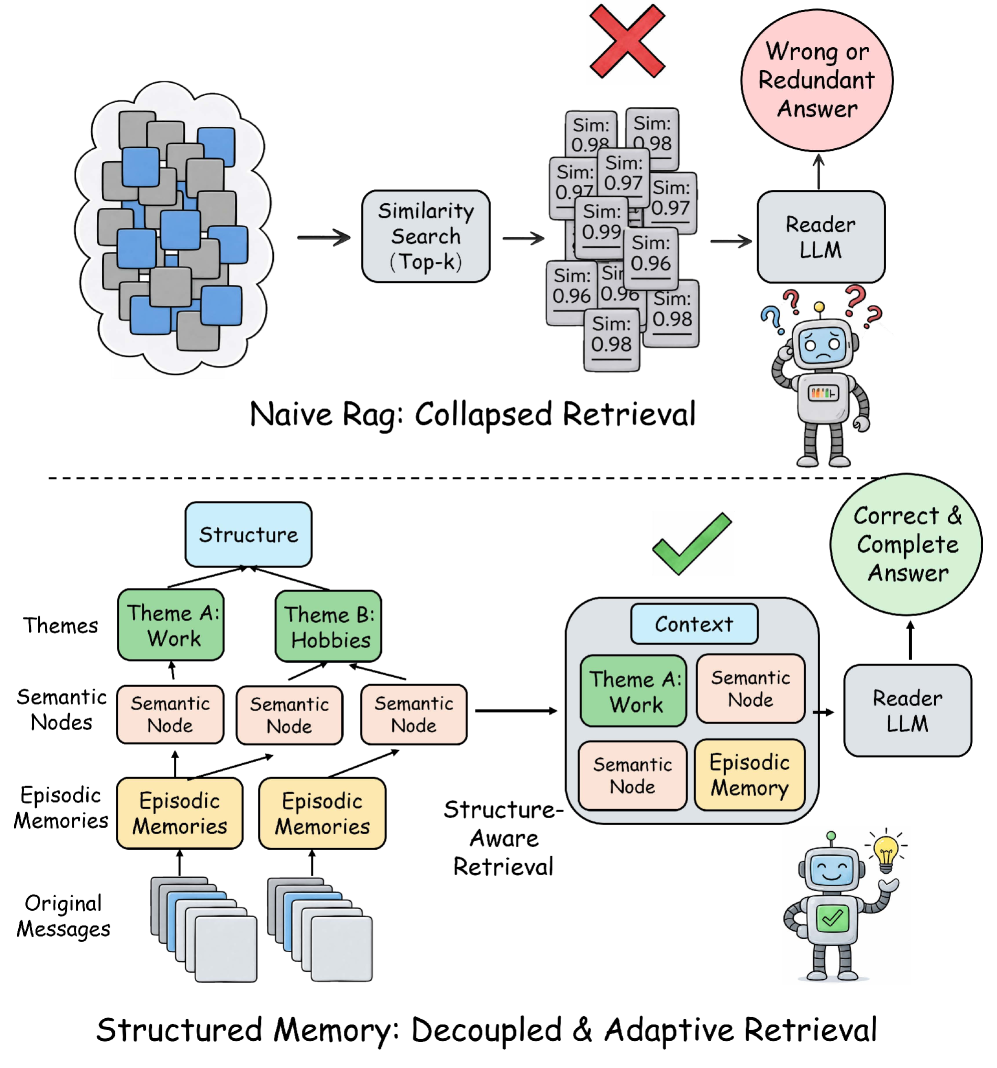
Наивный RAG против структурированной памяти (источник: arXiv)
Почему исправление, к которому прибегает большинство команд, делает ситуацию только хуже
Чтобы преодолеть эти ограничения, исследователи предлагают изменить подход к созданию и поиску в памяти агентов, который они описывают как «разделение с агрегацией» (decoupling to aggregation).
Вместо того чтобы сопоставлять запросы пользователей напрямую с сырыми, перекрывающимися журналами чатов, система организует разговор в иерархическую структуру. Сначала она отделяет поток разговора от различных автономных семантических компонентов. Затем эти отдельные факты агрегируются в структурную иерархию тем более высокого уровня.
Когда ИИ необходимо вспомнить информацию, он осуществляет поиск по иерархии сверху вниз: от тем к семантике и, наконец, к необработанным фрагментам. Такой подход позволяет избежать избыточности. Если два фрагмента диалога имеют похожие эмбеддинги, система вряд ли извлечет их вместе, если они были отнесены к разным семантическим компонентам.
Чтобы эта архитектура была успешной, она должна сбалансировать два жизненно важных структурных свойства. Семантические компоненты должны быть достаточно дифференцированными, чтобы предотвратить извлечение избыточных данных со стороны ИИ. В то же время агрегации более высокого уровня должны оставаться семантически точными по отношению к исходному контексту, чтобы модель могла создавать правильные ответы.
Четырехуровневая иерархия, которая сокращает контекстное окно
Исследователи разработали xMemory — фреймворк, который сочетает в себе управление структурированной памятью со стратегией адаптивного поиска сверху вниз.
xMemory непрерывно организует необработанный поток разговора в структурированную четырехуровневую иерархию. В основе лежат необработанные сообщения, которые сначала суммируются в непрерывные блоки, называемые «эпизодами». Из этих эпизодов система извлекает повторно используемые факты в качестве семантики, отделяя ключевые долгосрочные знания от повторяющихся логов чата. Наконец, связанные между собой семантические элементы группируются в темы высокого уровня, что облегчает их поиск.
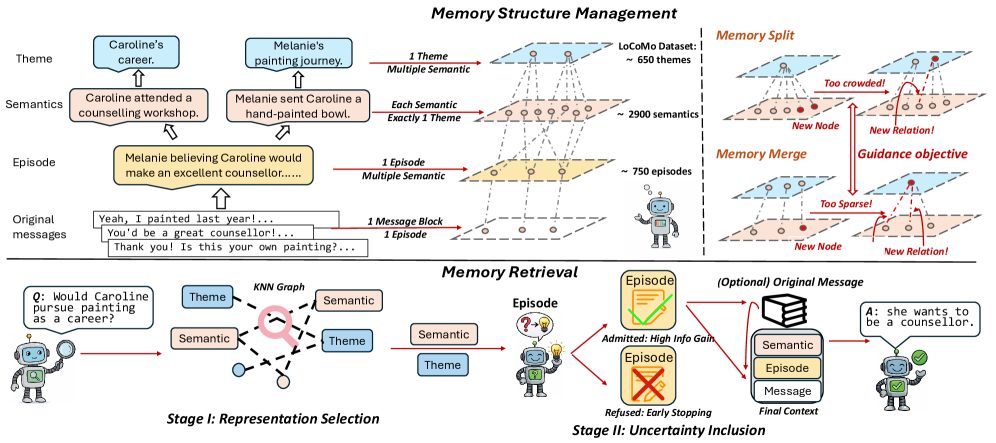
Архитектура xMemory (источник: arXiv)
xMemory использует специальную целевую функцию для постоянной оптимизации того, как она группирует эти элементы. Это предотвращает излишнее разрастание категорий, замедляющее поиск, или их чрезмерную фрагментацию, которая снижает способность модели агрегировать доказательства и отвечать на вопросы.
Получив запрос, xMemory выполняет поиск сверху вниз по этой иерархии. Он начинается на уровне тем и семантики, выбирая разнообразный и компактный набор релевантных фактов. Это крайне важно для приложений реального мира, где пользовательские запросы часто требуют сбора описаний по нескольким темам или объединения связанных фактов для сложных многошаговых (multi-hop) рассуждений.
Получив этот высокоуровневый «скелет» фактов, система контролирует избыточность с помощью метода, который исследователи называют «гейтированием неопределенности» (Uncertainty Gating). Она детализирует информацию вплоть до уровня эпизодов или сообщений только в том случае, если эта конкретная деталь измеримо снижает неопределенность модели.
«Семантическое сходство — это сигнал для генерации кандидатов, а неопределенность — это сигнал для принятия решений», — сказал Гуй. «Сходство подсказывает, что находится поблизости. Неопределенность показывает, за что действительно стоит платить в рамках бюджета промпта». Процесс расширения останавливается, когда система обнаруживает, что добавление новых деталей больше не помогает ответить на вопрос.
Каковы альтернативы?
Существующие системы памяти агентов обычно делятся на две структурные категории: плоские (flat) и структурированные. Обе страдают от фундаментальных ограничений.
Плоские подходы, такие как MemGPT, записывают сырой диалог или минимально обработанные следы (traces). Это позволяет сохранить разговор, но приводит к накоплению огромной избыточности и увеличению затрат на поиск по мере роста истории.
Структурированные системы, такие как A-MEM и MemoryOS, пытаются решить эту проблему путем организации памяти в виде иерархий или графов. Тем не менее, они по-прежнему полагаются на сырой или минимально обработанный текст в качестве основной единицы извлечения, часто захватывая обширные, раздутые контексты. Эти системы также сильно зависят от записей памяти, сгенерированных LLM, которые имеют жесткие ограничения по схеме. Если ИИ немного отклоняется в форматировании, это может привести к сбою памяти.
xMemory устраняет эти ограничения благодаря оптимизированной схеме построения памяти, иерархическому поиску и динамической реструктуризации памяти по мере ее роста.
Когда использовать xMemory
Для корпоративных архитекторов критически важно понимать, когда следует внедрять эту архитектуру вместо стандартного RAG. По словам Гуя, «xMemory наиболее привлекательна там, где системе необходимо сохранять связность в течение недель или месяцев взаимодействия».
Агенты службы поддержки клиентов, например, получают огромную выгоду от такого подхода, поскольку они должны помнить устойчивые предпочтения пользователей, прошлые инциденты и контекст конкретной учетной записи, не подтягивая постоянно дублирующиеся тикеты техподдержки. Персонализированный коучинг — еще один идеальный вариант использования, требующий от ИИ отделения непреходящих черт пользователя от эпизодических повседневных деталей.
И наоборот, если компания создает ИИ для общения с репозиторием файлов, таким как руководства по политике или техническая документация, «более простой стек RAG по-прежнему остается лучшим инженерным выбором», считает Гуй. В таких статических сценариях, ориентированных на документы, корпус достаточно разнообразен, чтобы стандартный поиск ближайших соседей работал отлично без операционных накладных расходов иерархической памяти.
Плата за запись оправдана
xMemory устраняет узкое место в виде задержки, связанное с генерацией окончательного ответа LLM. В стандартных системах RAG языковая модель вынуждена читать и обрабатывать раздутое контекстное окно, полное избыточных диалогов. Поскольку точный иерархический поиск xMemory создает гораздо меньшее и высоко целенаправленное контекстное окно, считывающая LLM тратит значительно меньше вычислительного времени на анализ промпта и генерацию финального результата.
В ходе экспериментов с задачами на длинный контекст как открытые, так и закрытые модели, оснащенные xMemory, превзошли другие базовые показатели, используя значительно меньше токенов и одновременно повышая точность выполнения задач.
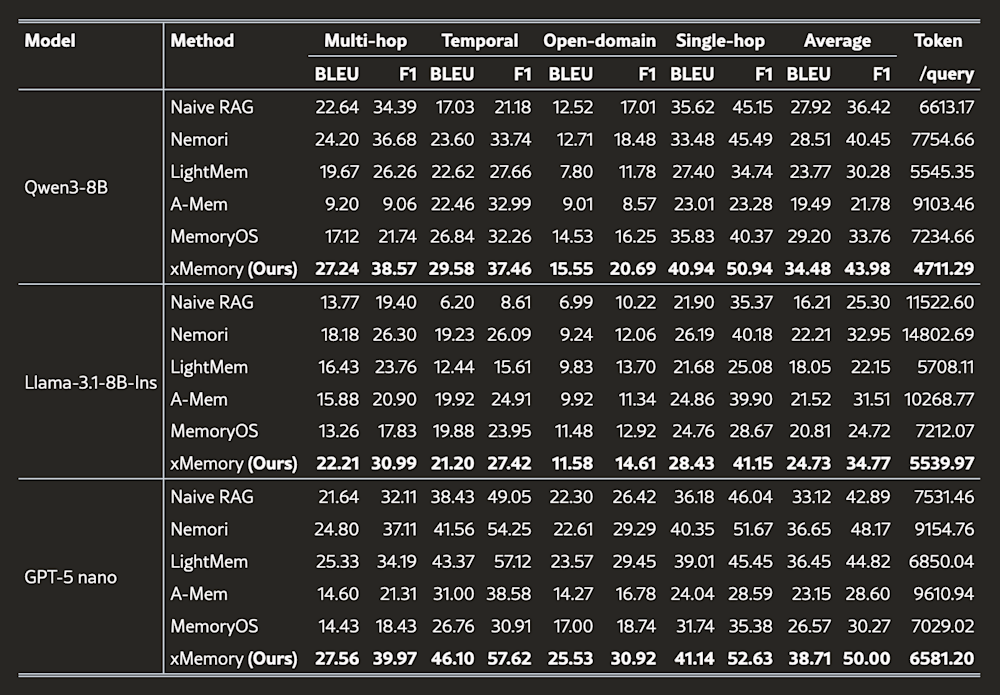
xMemory повышает производительность в различных задачах, снижая затраты на токены (источник: arXiv)
Однако такое эффективное извлечение информации сопряжено с первоначальными затратами. Для корпоративного развертывания подвох с xMemory заключается в том, что она меняет огромную плату за чтение на авансовую плату за запись. Хотя в конечном итоге она делает ответы на запросы пользователей более быстрыми и дешевыми, поддержание ее сложной архитектуры требует значительной фоновой обработки.
В отличие от стандартных конвейеров RAG, которые дешево сбрасывают эмбеддинги необработанного текста в базу данных, xMemory должна выполнять множество вспомогательных вызовов LLM для определения границ разговора, суммирования эпизодов, извлечения долгосрочных семантических фактов и синтеза общих тем.
Кроме того, процесс реструктуризации xMemory предъявляет дополнительные вычислительные требования, поскольку ИИ должен курировать, связывать и обновлять собственную внутреннюю картотеку. Чтобы справиться с этой операционной сложностью в продакшене, команды могут выполнять эту тяжелую реструктуризацию асинхронно или в микробатчах (микропакетах), а не блокировать запрос пользователя синхронно.
Для разработчиков, стремящихся создать прототип, код xMemory находится в открытом доступе на GitHub под лицензией MIT, что делает его пригодным для коммерческого использования. Если вы пытаетесь внедрить это в существующие инструменты оркестрации, такие как LangChain, Гуй советует сначала сосредоточиться на ключевой инновации: «Самое главное, что нужно построить в первую очередь, — это не более навороченный промпт для ритривера. Это слой декомпозиции памяти. Если вам нужно сделать правильно хотя бы что-то одно, сделайте таковой логику индексации и декомпозиции».
Поиск — не последнее узкое место
Хотя xMemory предлагает мощное решение современных ограничений контекстного окна, она прокладывает путь к следующему поколению проблем в агентных воркфлоу. По мере того как ИИ-агенты сотрудничают на более длительных отрезках времени, простого поиска нужной информации будет недостаточно.
«Поиск — это узкое место, но как только поиск улучшится, эти системы быстро столкнутся с управлением жизненным циклом и управлением памятью в качестве следующих узких мест», — сказал Гуй. Навигация по тому, как данные должны «угасать», обработка конфиденциальности пользователей и поддержание общей памяти между несколькими агентами — это именно то, «где я ожидаю появления большой волны следующей работы», отметил он.




