Базовая модель за 1500 долларов, которая соперничает с более крупными языковыми моделями


Обучение базовой большой языковой модели (LLM) с нуля стоит миллионы долларов и требует данных в масштабах интернета — именно поэтому большинство предприятий даже не пытаются этим заниматься. В компании Sapient считают, что нашли более дешевый путь.
Чтобы преодолеть эту догму грубого масштабирования, исследователи из Sapient разработали HRM-Text. Эта система заменяет стандартные трансформеры высокоэффективной в плане использования выборок иерархической рекуррентной моделью (HRM), архитектуру которой они представили в прошлом году.
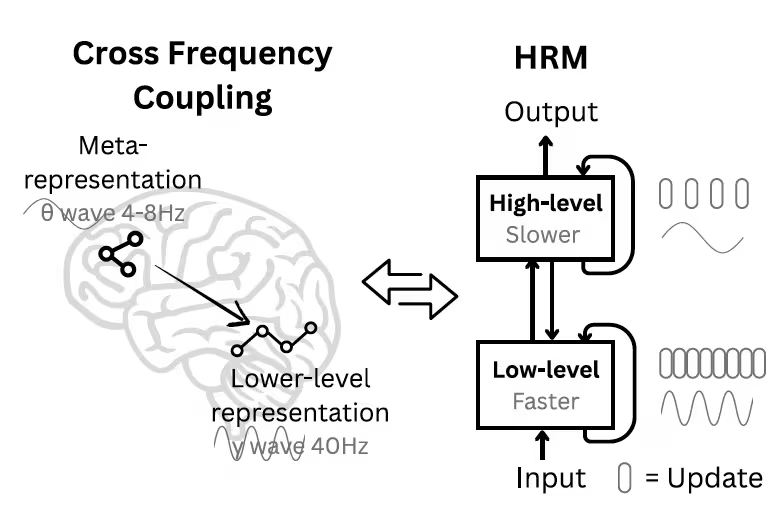
HRM разделяет вычисления на медленно эволюционирующие стратегические слои и быстро эволюционирующие слои исполнения. Вместо прогнозирования следующего токена на основе грубого анализа сырого текста методом перебора, HRM-Text обучается исключительно на парах «инструкция — ответ». Это близко к условиям реального бизнеса, где пользователи обычно ожидают целевой ответ на конкретную задачу.
Исследователи смогли обучить HRM-Text с 1 миллиардом параметров с нуля за малую долю стоимости и объема токенов, необходимых для обычных LLM. Их модель достигла производительности, конкурентоспособной с гораздо более крупными открытыми моделями на ключевых отраслевых бенчмарках.
Для реальных ИИ-приложений это означает, что базовое предварительное обучение больше не является прерогативой исключительно богатых институтов. С помощью HRM-Text организации могут позволить себе недорогое предварительное обучение собственных высокопроизводительных моделей рассуждения с нуля и связывать их с внешними хранилищами знаний.
Бутылочное горлышко обучения
Когда мы обучаем LLM, на самом деле нам все равно, запомнила ли она точную последовательность слов в случайной ветке Reddit за 2014 год. Нам нужно, чтобы модель выработала глубокое, фундаментальное понимание человеческого языка, логики, фактов и рассуждений.
Нынешний подход основан на грубой силе: собрать данные по всему интернету, триллионы раз запустить прогнозирование следующего токена и надеяться, что у модели сформировалась рабочая внутренняя картина мира.
По сути, это означает, что мы тратим миллионы долларов вычислительной мощности, заставляя модели запоминать все подряд из интернета только для того, чтобы они косвенным путем научились мыслить. Например, стандартные модели, состоящие только из декодера, тратят ценные вычислительные ресурсы на расчет потерь для реконструкции самого промпта, хотя запрос пользователя уже известен и предоставляется в момент инференса.
Индустрия должна перестать воспринимать это просто как техническое препятствие и признать серьезным ограничением для бизнеса. В комментариях для VentureBeat Гуан Ван, генеральный директор Sapient Intelligence, охарактеризовал эту проблему как вопрос «экономики итераций».
«Сегодня предприятия сталкиваются с тремя усугубляющими друг друга проблемами: обучение стоит дорого, инфраструктура тяжелая, а циклы экспериментов слишком медленные, — отметил Ван. — Зависимость индустрии от масштабирования сводится к принципу: «Если модель не справляется, сделайте ее больше. Добавьте больше данных. Добавьте больше графических процессоров». Это работало, но сейчас подход достигает точки убывающей отдачи. Больший масштаб часто означает больше запоминания, выше задержки, тяжелее инфраструктуру и сильнее зависимость от поставщиков. Это не обязательно дает предприятию лучший инструмент для рассуждений».
Именно эта архитектурная и вычислительная неэффективность объясняет, почему донастройка (fine-tuning) существующих плотных трансформеров не всегда является волшебной таблеткой для бизнеса. Донастройка с целью сохранения общих возможностей модели часто требует добавления в процесс значительного объема общецелевых данных, что делает его вычислительно тяжелым и сложным в управлении.
«Представьте себе хедж-фонд, страховую компанию или банк, обладающие строго проприетарными данными: внутренними аналитическими записками, логикой транзакций, правилами комплаенса, меморандумами аналитиков, моделями рисков, ограничениями портфеля, — говорит Ван. — Они могут не захотеть отправлять эти данные во внешнюю передовую модель, и им может не потребоваться гигантская модель общего назначения, запомнившая весь интернет. Им нужно компактное ядро рассуждений, способное усваивать структуру их задач, оперировать правилами и цифрами и работать в контролируемой среде».
Поскольку HRM-Text сосредоточена исключительно на выполнении задач и латентных рассуждениях, она позволяет предприятиям начать с меньшей по размеру и более умной модели, а затем адаптировать ее под проприетарную предметную область со значительно меньшими затратами на инфраструктуру.
Переосмысление архитектур с помощью HRM-Text
Модель HRM, представленная в 2025 году, кардинально отличается от традиционных трансформеров. Чтобы создать более эффективный в плане выборок движок, HRM разделяет вычисления на медленно эволюционирующие стратегические и быстро эволюционирующие слои исполнения. Быстрый L-модуль выполняет локальное итеративное уточнение, в то время как медленный H-модуль поддерживает стабильный семантический контекст между циклами. Обработка состоит из двух высокоуровневых циклов, каждый из которых включает три обновления быстрого L-модуля, за которыми следует одно обновление медленного H-модуля.
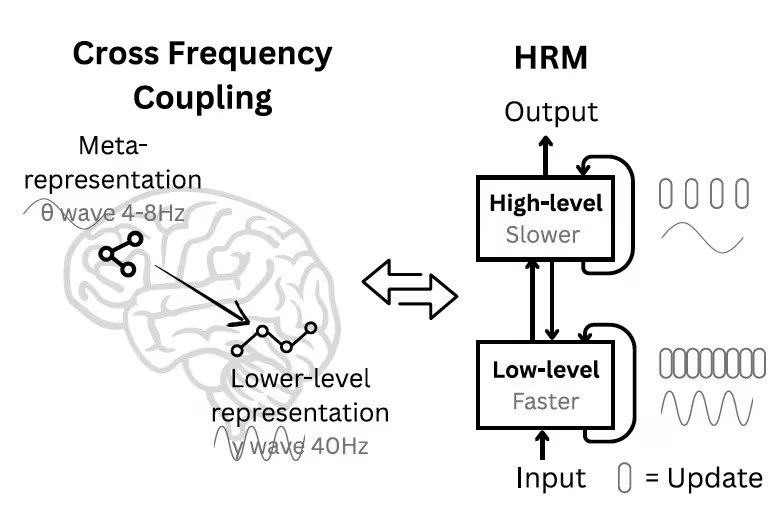
Иерархическая модель рассуждений (HRM) (источник: arXiv)
Стандартные рекуррентные архитектуры с разделением параметров (такие как модель TRM от Samsung AI Researchers) иногда могут справляться с простыми логическими задачами, однако исследователи из Sapient выяснили, что они становятся крайне нестабильными при масштабировании до 1 миллиарда параметров в языковых задачах. Разделение между медленным H-модулем и быстрым L-модулем в HRM обусловлено математической необходимостью, а не эстетическими соображениями. Как отметил Ван: «Для логических сеток иногда можно обойтись крошечным рекурсивным механизмом, потому что мир там чист и ограничен. С языком дело обстоит иначе. Языку нужны как быстрое локальное уточнение, так и медленная семантическая стабильность».
Хотя оригинальная HRM доказала высокую эффективность в решении контролируемых символьных задач, исследователи столкнулись с препятствием при попытке применить ее к масштабным и открытым сложностям генеративного моделирования языка. Циклы HRM делают ее невероятно эффективным мыслителем, но те же самые циклы делают модель математически нестабильной при обучении на разнообразном хаосе человеческого языка. Запуск рекуррентных циклов на языковых данных порождает колоссальную математическую нестабильность, в частности взрыв или затухание градиентов.
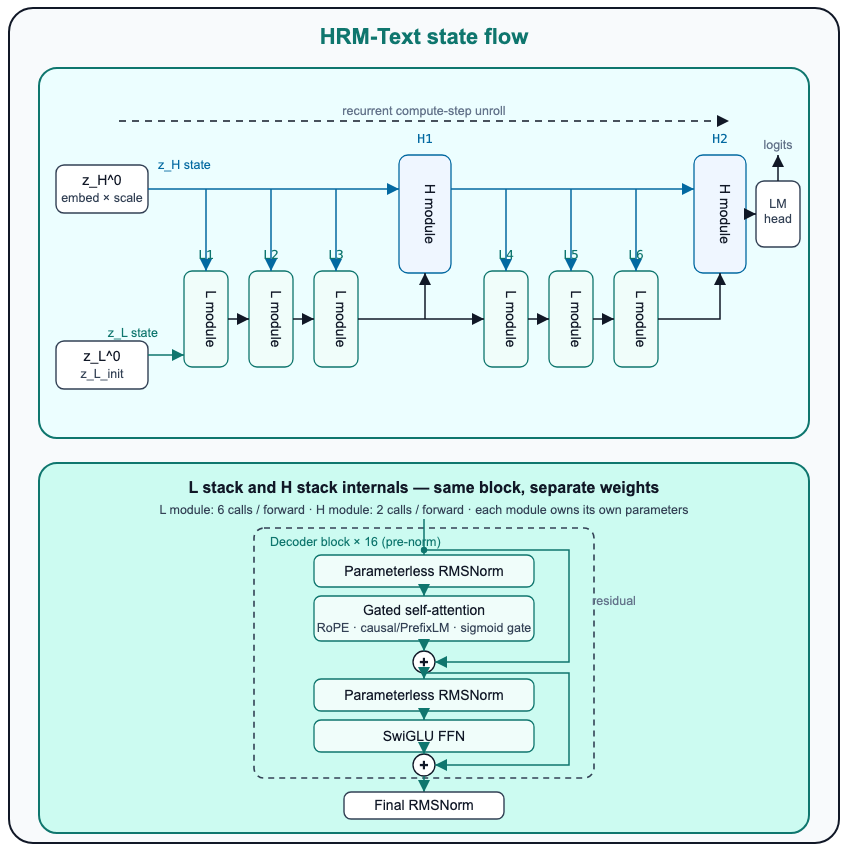
Архитектура HRM-Text (источник: Sapient Inc.)
Чтобы предотвратить возникновение этой обратной связи в нейросети, исследователи внедрили два ключевых архитектурных новшества в HRM-Text. Во-первых, они разработали MagicNorm — специализированный метод нормализации, созданный специально для поддержания стабильности внутренних сигналов независимо от того, сколько раз модель прогоняет свой мыслительный процесс по кругу.
Во-вторых, они спроектировали метод разогрева (warm-up) для стабилизации обучения. На начальном этапе модель оценивается только на коротких и поверхностных цепочках рассуждений. По мере продвижения обучения система «разогревается», постепенно предоставляя модели все более глубокие и длинные последовательности рассуждений.
Они также изменили целевую функцию обучения с прогнозирования следующего токена на выполнение задач, при котором модель получает вознаграждение только за полный ответ, а не за отдельные сгенерированные токены. Для достижения этой цели обучающие данные HRM-Text были переведены с сырого текста исключительно на пары «инструкция — ответ».
HRM-Text в действии
Исследователи создали высококомпактную модель HRM-Text с 1 миллиардом параметров. Вместо стандартного многоэтапного конвейера, требующего переработки триллионов слов сырого интернет-текста, они обучили ее с нуля на тщательно отобранном датасете объемом всего 40 миллиардов токенов. Обучающие данные целиком состояли из пар «инструкция — ответ», охватывающих общие инструкции, математику, символическую логику, учебные упражнения и переписанные материалы из базы знаний.
Модель обучалась с использованием целевой функции выполнения задач. Чтобы заставить модель опираться на собственную внутреннюю иерархическую архитектуру, а не копировать пошаговую логику, они целенаправленно удалили из обучающих данных «мыслительные» токены.
Модель прошла оценку на разнообразном наборе стандартных базовых бенчмарков ИИ с упором на знания, рассуждения, логику, математику и понимание текста. Исследователи протестировали HRM-Text как в сравнении с небольшими моделями, так и с хорошо обеспеченными ресурсами моделями с открытыми весами и полностью открытыми моделями.
Результаты демонстрируют значительный сдвиг границ соотношения вычислений и производительности. Модель HRM-Text с 1 млрд параметров набрала 60,7% на бенчмарке MMLU, 84,5% на GSM8K и 56,2% на MATH. Эти показатели весьма конкурентоспособны (а в ряде случаев превосходят) результаты базовых моделей с числом параметров от 2 до 7 миллиардов, против которых она тестировалась.
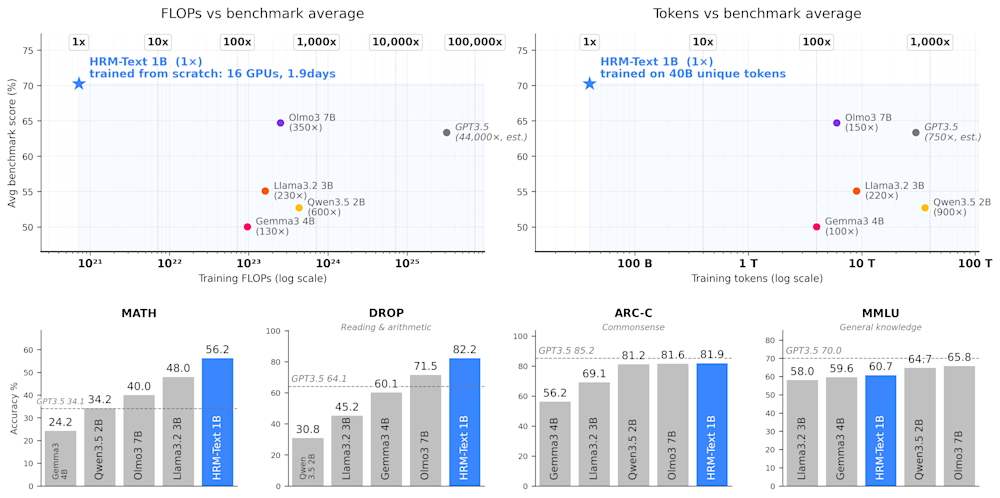
Производительность HRM-Text (источник: arXiv)
Самый важный вывод для корпоративной аудитории заключается в статистике эффективности и практических последствиях. Предварительное обучение базовой модели с нуля обычно представляет собой многомиллионный проект, доступный лишь технологическим гигантам. Модель HRM-Text была обучена всего за 1,9 дня на кластере из 16 графических процессоров. Общая расчетная стоимость вычислений составила около 1500 долларов. Она достигла конкурентоспособных результатов, используя в 100–900 раз меньше обучающих токенов и требуя в 96–432 раза меньше расчетных вычислительных мощностей, чем такие модели, как Qwen, Gemma и Llama.
Еще один важный момент — отделение рассуждений от запоминания фактов. С практической точки зрения успех HRM-Text в задачах, требующих интенсивных рассуждений, несмотря на скромный объем обучения в 40 млрд токенов, доказывает: модели вовсе не обязательно запоминать весь интернет, чтобы стать интеллектуальным движком для логических выводов.
Для корпоративных приложений такое поведение — это достоинство, а не баг. Исследователи видят будущее, в котором компании развертывают сверхкомпактные и невероятно дешевые рекуррентные модели, выступающие в роли «ядра рассуждений», специализированного под бизнес-логику. Вместо того чтобы заставлять модель заучивать базы данных компании во время предварительного обучения, она действует как механизм логических выводов, опираясь на внешние поисковые системы для получения фактических данных.
Критики отмечают, что обучение на парах «инструкция — ответ» делает сравнение с моделями, обученными на сыром тексте, некорректным (сравнение «яблок с апельсинами»). Ван отвергает этот аргумент, подчеркивая, что любая серьезная современная LLM сталкивается с данными в формате инструкций и ответов на этапе обучения или выравнивания. «Так что это сравнение не яблок с апельсинами. Оно ближе к сравнению сердцевин яблок с целыми яблоками. Мы сразу начали с формата базовой задачи, потому что именно так люди реально используют модели: они дают инструкцию и ожидают полезный ответ», — заявил он.
Исследователи также провели строгие тесты на загрязнение данных, чтобы убедиться, что модель просто не запомнила ответы из бенчмарков. На датасете DROP — единственном бенчмарке, показавшем маргинальный сигнал загрязнения в определенных условиях, — модель HRM-Text все равно продемонстрировала впечатляющие 81,1% на абсолютно чистой выборке с 0% загрязнения.
В конечном итоге Ван утверждает, что для бизнеса «правильная оценка — это проверка не на знание тривиальных фактов, а оценка рабочих процессов… Дайте HRM-Text такую задачу, как: многоэтапные финансовые рассуждения, логика комплаенса, автоматизация научных рабочих процессов, структурированное извлечение данных с последующими умозаключениями».
Практическая реализация и будущее корпоративного ИИ
Хотя результаты бенчмарков и показатели экономичности впечатляют, в Sapient четко осознают текущие ограничения модели. Первоначальный релиз лучше всего рассматривать как концептуальное доказательство (proof-of-concept), похожее на ранние версии GPT и призванное продемонстрировать уникальные преимущества архитектуры.
«Честно говоря, HRM-Text пока не является готовой заменой ChatGPT по принципу «подключил и работай», — признал Ван. — Это компактная базовая языковая модель для рассуждений. Для команды корпоративных инженеров операционная работа будет в основном сосредоточена вокруг шаблонов, выбора режимов, маскирования внимания и выравнивания».
Для инженерных ИИ-команд, желающих поэкспериментировать, начало работы требует соблюдения определенной, хотя и стандартной дисциплины генерации текста. Модель заявляет о нативной поддержке в библиотеке Transformers (требуется transformers >= 5.9.0), а пути ее использования для vLLM и SGLang находятся в активной разработке. Основная инженерная задача связана с управлением дизайном PrefixLM: производственные многошаговые чат-приложения потребуют аккуратной логики работы с KV-кешем, чтобы гарантировать полную двунаправленную обработку промптов пользователя, в то время как ответы ассистента должны оставаться каузальными.
«Когда стоимость обучения способной модели для рассуждений падает примерно до 1500 долларов, ИИ перестает быть исключительно вопросом инфраструктуры и превращается в вопрос стратегии, — резюмировал Ван. — Компаниям из списка Fortune 500 больше не придется спрашивать: «Можем ли мы позволить себе базовую модель?» Они будут спрашивать: «Что наша модель должна знать о нашем бизнесе и под какой тип рассуждений ее следует оптимизировать?»»