


Рассуждения LLM в автоматическом режиме: количество токенов сократилось на 69,5%
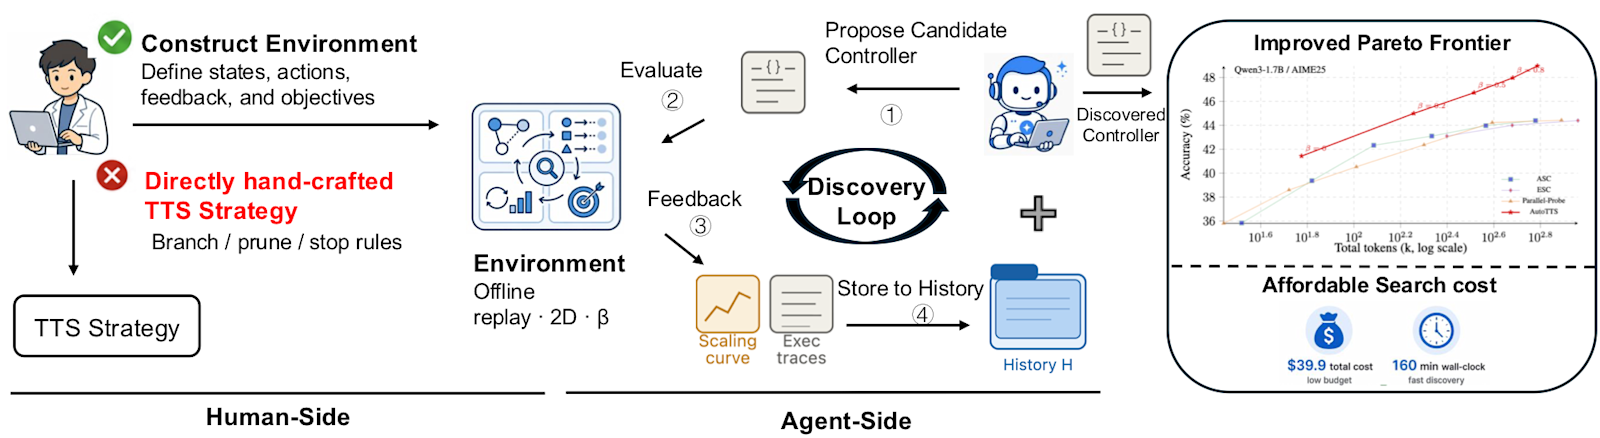


Масштабирование во время тестирования (test-time scaling, TTS) зарекомендовало себя как надежный метод повышения производительности больших языковых моделей в реальных сценариях за счет выделения им дополнительных вычислительных ресурсов на этапе инференса. Однако до сих пор стратегии TTS разрабатывались вручную и в значительной степени опирались на человеческую интуицию при определении правил рассуждения модели.
Чтобы преодолеть это узкое место, исследователи из Meta, Google и ряда университетов представили AutoTTS — фреймворк, который автоматически находит оптимальные стратегии TTS. Такой автоматизированный подход позволяет корпоративным структурам динамически оптимизировать распределение вычислительных ресурсов без ручной настройки эвристик.
Внедряя оптимальные стратегии, обнаруженные с помощью AutoTTS, организации могут напрямую сократить расход токенов и операционные расходы на развертывание передовых моделей рассуждения в производственной среде. В ходе экспериментальных испытаний AutoTTS эффективно управлял бюджетом инференса, успешно снизив потребление токенов почти на 69,5% без потери точности.
Ручное узкое место в масштабировании во время тестирования
Масштабирование во время тестирования расширяет возможности языковых моделей, выделяя им дополнительные вычислительные мощности при генерации ответов. Эти дополнительные ресурсы позволяют модели создавать несколько путей рассуждения или оценивать промежуточные шаги перед формированием окончательного ответа.
Основная сложность при разработке стратегий TTS заключается в определении того, как оптимально распределить эти дополнительные вычисления. Исторически исследователи создавали такие стратегии вручную, полагаясь на догадки при построении жестких эвристик. Инженерам приходится выдвигать гипотезы о правилах и пороговых значениях для ситуаций, когда модель должна разветвляться на новые пути рассуждения, глубже исследовать существующий путь, отсекать бесперспективную ветку или полностью прекращать рассуждения.
Поскольку этот процесс ручной настройки ограничен человеческой интуицией, огромное количество возможных подходов остается неизученным. Это часто приводит к неоптимальному соотношению между точностью модели и затратами на вычисления.
Существующие алгоритмы TTS можно соотнести с пространством управления «ширина-глубина», где «ширина» — это количество исследуемых ветвей рассуждения, а «глубина» — степень детализации каждой из них. Самосогласованность (self-consistency, SC) выполняет выборку фиксированного количества траекторий и определяет ответ голосованием большинства. Адаптивная согласованность (adaptive-consistency, ASC) экономит ресурсы, досрочно останавливая процесс при достижении порогового значения уверенности. Параллельный проход (parallel-probe) использует более детальный подход, отсекая бесперспективные ветви и углубляя остальные. Все три метода созданы вручную, и именно это ограничение призван преодолеть AutoTTS.
Хотя некоторые более продвинутые методы используют более сложные структуры, такие как поиск по дереву или внешние верификаторы, все они имеют одну общую характеристику: они тщательно созданы вручную. Такой ручной подход сужает область поиска стратегий, оставляя нетронутой значительную часть потенциального пространства распределения ресурсов.
Автоматизация поиска стратегий с помощью AutoTTS
AutoTTS меняет подход к оптимизации масштабирования во время тестирования. Вместо того чтобы рассматривать проектирование стратегий как задачу для человека, AutoTTS подходит к ней как к проблеме алгоритмического поиска в контролируемой среде.
Этот фреймворк переопределяет роли как инженера-человека, так и ИИ-модели. Вместо создания вручную конкретных правил для случаев, когда языковая модель должна ветвиться, отсекать ветви или прекращать рассуждения, роль инженера смещается в сторону построения среды обнаружения. Человек определяет границы, включая пространство управления состояний и действий, цели оптимизации, балансирующие точность и затраты, а также конкретные механизмы обратной связи.
Фреймворк AutoTTS (источник: arXiv)
Языковая модель-исследователь (например, Claude Code) разрабатывает саму стратегию. Этот исследователь действует как автономный агент, который итеративно предлагает «контроллеры» TTS. Эти контроллеры представляют собой определяемые кодом политики или алгоритмы, которые диктуют, как ИИ-модель распределяет свой вычислительный бюджет во время инференса. Исследователь тестирует и дорабатывает эти контроллеры на основе обратной связи до тех пор, пока не найдет оптимальную политику распределения ресурсов.
Чтобы сделать этот автоматизированный поиск доступным с точки зрения вычислительных затрат, AutoTTS полагается на «автономную среду воспроизведения» (offline replay environment). Если бы языковой модели-исследователю приходилось вызывать базовую модель рассуждения для генерации новых токенов каждый раз при тестировании новой стратегии, затраты на вычисления были бы астрономическими. Вместо этого система опирается на тысячи траекторий рассуждений, предварительно собранных от базовой языковой модели. Эти траектории включают «сигналы проверки» — промежуточные ответы, которые помогают контроллеру оценивать прогресс в различных ветвях рассуждений.
В ходе цикла поиска агент-исследователь предлагает контроллер и оценивает его на основе этих автономных данных. Агент наблюдает за ходом выполнения предложенного контроллера, который показывает распределение вычислений во времени. Анализируя эти данные, агент может диагностировать конкретные сбои, например, замечая, если контроллер слишком агрессивно отсекал ветви в определенном сценарии. Это дает преимущество по сравнению с простым просмотром финального результата. Затем агент итеративно переписывает свой код для улучшения баланса между точностью и затратами.
Изнутри разработанного ИИ контроллера
Поскольку агент-исследователь не ограничен человеческой интуицией, он может находить высокоскоординированные, сложные правила, которые инженер-человек вряд ли когда-либо запрограммировал бы вручную. Один из оптимальных контроллеров, обнаруженных AutoTTS, получивший название Контроллера импульса уверенности (Confidence Momentum Controller), задействует несколько неочевидных механизмов управления вычислениями:
-
Остановка на основе трендов: Стратегии ручной разработки часто предписывают модели прекратить рассуждения при достижении определенного мгновенного порога уверенности. Агент AutoTTS обнаружил, что мгновенная уверенность может быть обманчивой из-за временных всплесков. Вместо этого контроллер отслеживает экспоненциальное скользящее среднее (EMA) уверенности и останавливает работу только тогда, когда общий уровень уверенности высок, а тренд не демонстрирует активного падения.
-
Связанное управление шириной и глубиной: Алгоритмы ручной разработки обычно рассматривают «расширение» новых путей рассуждения и «углубление» текущих путей как отдельные решения. AutoTTS обнаружил замкнутый контур обратной связи, в котором эти два действия связаны. Если уверенность в текущих ветвях застаивается или снижается, контроллер автоматически инициирует создание новых ветвей.
-
Распределение глубины с учетом согласованности: Вместо того чтобы выделять всем активным ветвям рассуждения равный вычислительный бюджет, контроллер динамически определяет, какие ветви согласуются с текущим лидирующим ответом. Затем он предоставляет этим ветвям приоритетные «всплески» дополнительных вычислений. Это позволяет сосредоточить вычислительный бюджет на формирующемся консенсусе для быстрого подтверждения его правильности.
Экономия затрат и прирост точности на реальных бенчмарках
Чтобы проверить, способен ли искусственный интеллект самостоятельно найти лучшую стратегию масштабирования во время тестирования, исследователи создали строгий каркас для оценки. Основные эксперименты проводились на моделях Qwen3 с количеством параметров от 0,6B до 8B. Исследователи также протестировали способность системы к генерализации на дистиллированной 8-миллиардной версии модели DeepSeek-R1.
Изначально перед агентом-исследователем стояла задача найти оптимальную стратегию с использованием бенчмарка математических рассуждений AIME24. Полученная стратегия была затем протестирована на двух изолированных математических бенчмарках (AIME25 и HMMT25), а также на бенчмарке общих рассуждений уровня аспирантуры GPQA-Diamond.
Контроллер, созданный с помощью AutoTTS, сопоставлялся с четырьмя существующими в индустрии алгоритмами масштабирования во время тестирования, разработанными вручную. В число этих базовых моделей вошли: самосогласованность с 64 параллельными путями рассуждения (SC@64), адаптивная согласованность (ASC), параллельный проход (Parallel-Probe) и самосогласованность с ранней остановкой (ESC). ESC представляет собой гибридный подход, который генерирует траектории параллельно и досрочно прекращает работу, когда ответ кажется стабильным.
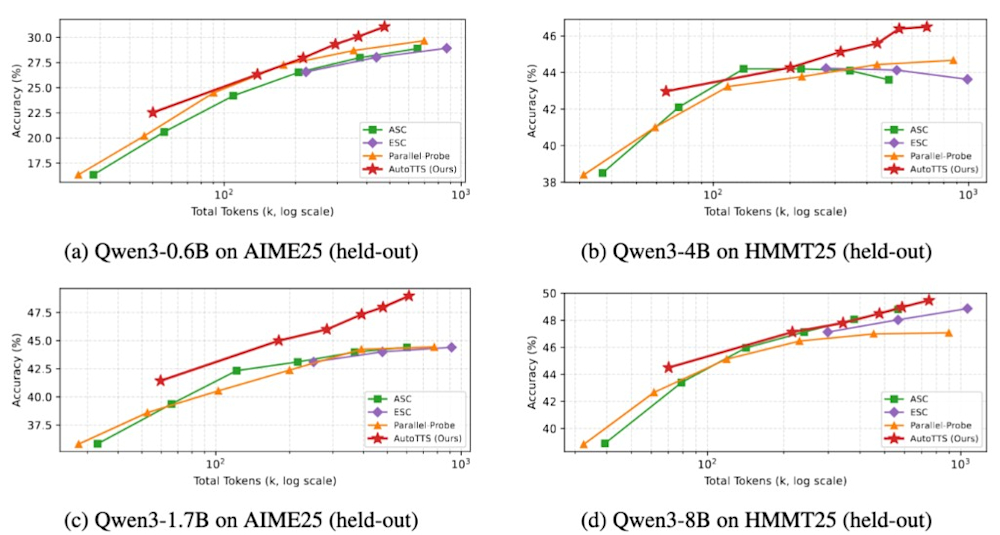
AutoTTS (красная линия) превосходит другие базовые модели на отраслевых бенчмарках (источник: arXiv)
В сбалансированном режиме с ориентацией на экономию средств контроллер, созданный AutoTTS, сократил общее потребление токенов примерно на 69,5% по сравнению с SC@64. В то же время контроллер сохранил ту же среднюю точность на четырех моделях Qwen. При увеличении бюджета инференса AutoTTS поднял пиковую точность выше показателей всех созданных вручную базовых моделей в пяти из восьми тестовых сценариев.
VB Transform · 14–15 июля · Менло-Парк · Агентная оркестровка
Intuit перестроила свою многоагентную систему за 60 дней. Что они изменили и почему?
На конференции Transform технические руководители из Intuit, Target и Instacart расскажут о том, как они перепроектировали свои архитектуры оркестровки для обеспечения надежности, масштабируемости и удобства реальных клиентов.
Эта эффективность проявилась и в других задачах. На бенчмарке GPQA-Diamond сбалансированный вариант AutoTTS сократил расходы на токены при инференсе с 510 тыс. до всего лишь 151 тыс. токенов, при этом немного повысив общую точность. На модели DeepSeek система AutoTTS достигла наивысшей общей точности на бенчмарке HMMT25, сократив расход токенов почти вдвое.
Для специалистов, создающих корпоративные ИИ-приложения, эти эксперименты подчеркивают два основных операционных преимущества:
-
Повышение пиковой производительности: AutoTTS не просто экономит деньги на потреблении токенов. Он активно повышает максимально достижимую производительность базовой модели. Разработанный ИИ контроллер превосходно умеет «на лету» обнаруживать зашумленные или непродуктивные ветви рассуждений и непрерывно перенаправлять вычислительный бюджет на ветви, генерирующие наиболее полезные сигналы.
-
Экономически эффективная заказная разработка: Поскольку фреймворк опирается на автономную среду воспроизведения, весь процесс поиска обошелся всего в 39,90 долларов и занял 160 минут. Для корпоративных команд это означает, что оптимизированные стратегии рассуждений, адаптированные под проприетарные модели и внутренние задачи, теперь стали доступны без выделения специального бюджета на исследования.
И фреймворк AutoTTS, и Контроллер импульса уверенности доступны на GitHub; CMC может использоваться в качестве прямой замены других контроллеров TTS.




