


Как создавать кастомные агенты рассуждений с минимальными затратами вычислительных ресурсов


Обучение моделей рассуждения с помощью искусственного интеллекта требует ресурсов, которых нет у большинства корпоративных команд. Инженерным командам часто приходится выбирать между дистилляцией знаний из крупных дорогостоящих моделей или использованием методов обучения с подкреплением, которые обеспечивают разреженную обратную связь.
Исследователи из JD.com и ряда академических институтов недавно представили новую парадигму обучения, которая позволяет обойти эту дилемму. Метод, названный обучением с подкреплением и проверяемыми наградами с помощью самодистилляции (RLSD, Reinforcement Learning with Verifiable Rewards with Self-Distillation), объединяет надежное отслеживание производительности обучения с подкреплением и детальную обратную связь самодистилляции.
Эксперименты показывают, что модели, обученные с помощью RLSD, превосходят модели, созданные на основе классических алгоритмов дистилляции и обучения с подкреплением. Для корпоративных команд этот подход снижает технические и финансовые барьеры на пути создания пользовательских моделей рассуждений, адаптированных под конкретную бизнес-логику.
Проблема обучения моделей рассуждений
Стандартным методом обучения моделей рассуждений является обучение с подкреплением и проверяемыми наградами (RLVR, Reinforcement Learning with Verifiable Rewards). В этой парадигме модель учится методом проб и ошибок, руководствуясь конечным результатом из своей среды. Автоматический верификатор проверяет, правилен или нет ответ модели, выдавая бинарную награду, например 0 или 1.
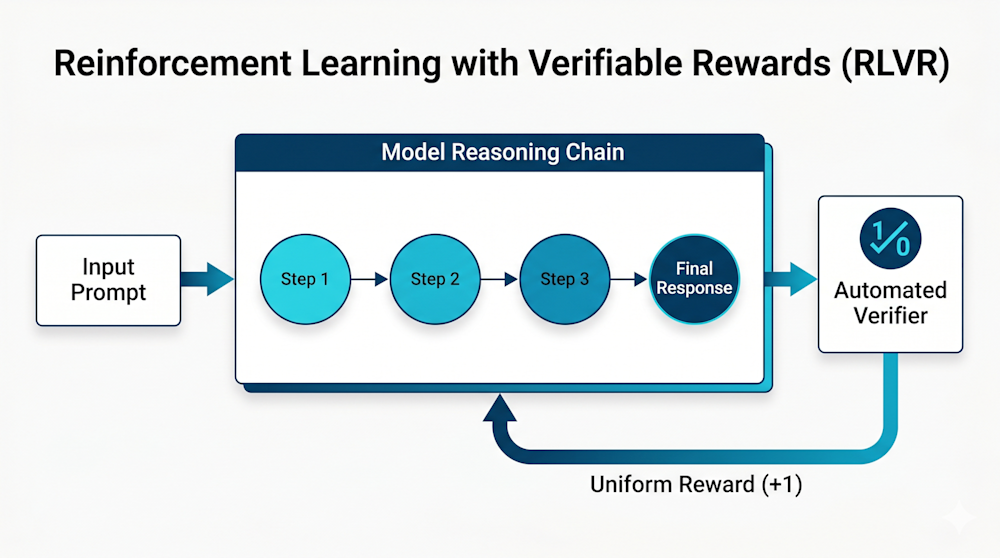
Обучение с подкреплением и проверяемыми наградами (RLVR)
RLVR страдает от разреженной и однородной обратной связи. «Стандартный GRPO имеет проблему плотности сигналов, — рассказал VentureBeat Чэньсю Ян (Chenxu Yang), соавтор научной работы. — Трассировка рассуждений длиной в несколько тысяч токенов получает одну бинарную награду, и каждый токен внутри этой трассировки получает одинаковую оценку, будь то ключевой логический шаг или проходная фраза». В результате модель так и не узнает, какие именно промежуточные шаги привели ее к успеху или неуспеху.
Дистилляция на основе актуальной политики (OPD, On-Policy Distillation) использует другой подход. Вместо того чтобы ждать конечного результата, разработчики объединяют меньшую модель-ученик с более крупной и мощной моделью-учителем. Для каждого учебного примера ученик сравнивает свой ответ с ответом учителя токен за токеном. Это обеспечивает ученика детальной обратной связью по всей цепочке рассуждений и процессу генерации ответа.
Развертывание и запуск отдельной массивной модели-учителя параллельно с учеником на протяжении всего процесса обучения влечет за собой огромные вычислительные затраты. «Вам приходится держать более крупную модель-учитель постоянно активной во время обучения, что примерно удваивает ваши потребности в графических процессорах», — отметил Ян. Кроме того, модели учителя и ученика должны использовать абсолютно одинаковую структуру словаря, что, по словам Яна, «тихо исключает большинство межмодельных, кросс-модальных или многоязычных конфигураций, которые фактически используют предприятия».
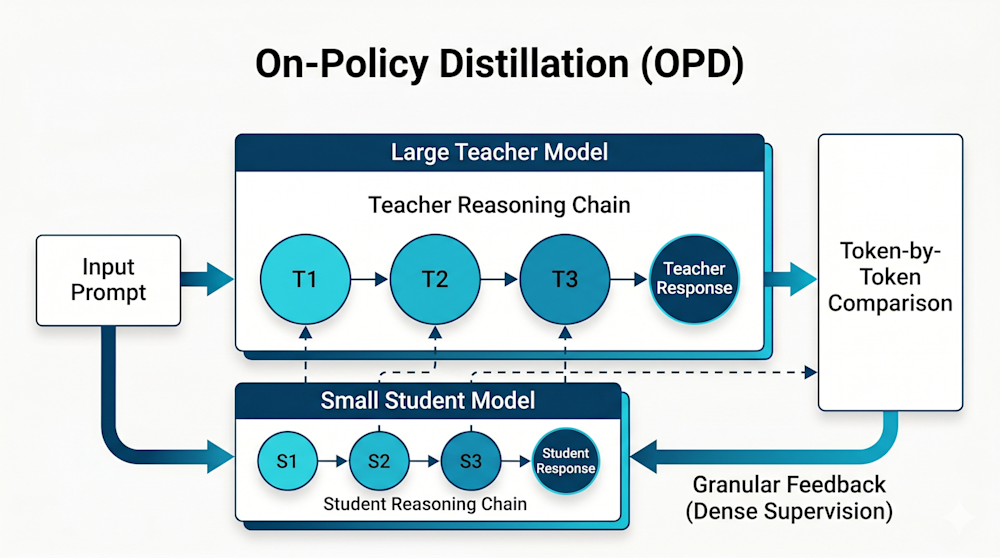
Дистилляция на основе актуальной политики (OPD)
Перспективы и недостатки самодистилляции
Самодистилляция на основе актуальной политики (OPSD, On-Policy Self-Distillation) появилась как решение, призванное преодолеть недостатки двух других подходов. В OPSD одна и та же модель выполняет роль как ученика, так и учителя.
Во время обучения ученик получает стандартный промпт, в то время как учитель получает привилегированную информацию, такую как проверенный пошаговый ключ к ответу. Эта хорошо осведомленная версия модели в роли учителя затем оценивает версию ученика, предоставляя пошаговую обратную связь по мере того, как ученик пытается решить задачу, используя только стандартный промпт.
OPSD кажется идеальным компромиссом для корпоративного бюджета. Она обеспечивает детальное пошаговое руководство, свойственное OPD. Поскольку она устраняет необходимость в внешней модели-учителе, она работает с высокой вычислительной эффективностью и низкой стоимостью RLVR, требуя лишь дополнительного прямого прохода для учителя.
Тем не менее исследователи обнаружили, что OPSD страдает от феномена, называемого «утечкой привилегированной информации».
«Целевая функция структурно некорректна, — сказал Ян. — Существует неустранимый разрыв взаимной информации, который ученик никогда не сможет закрыть… Когда самодистилляция настраивается как сопоставление распределений, от ученика требуется имитировать полное распределение выходных данных учителя в условиях привилегированного контекста».
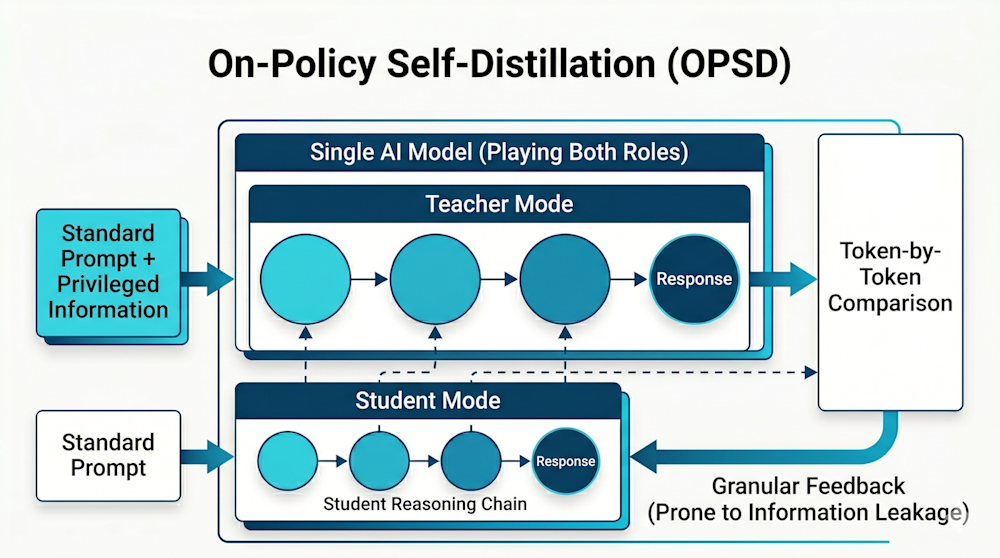
Самодистилляция на основе актуальной политики (OPSD)
Поскольку учитель оценивает ученика на основе скрытого ключа ответа, цель обучения заставляет модель-ученик заучивать точную формулировку или шаги учителя, а не лежащую в их основе логику рассуждений. В результате модель-ученик начинает галлюцинировать, ссылаясь на невидимое решение, к которому у нее не будет доступа при развертывании в реальных условиях.
На практике модели OPSD демонстрируют быстрый всплеск производительности в начале обучения, но их возможности рассуждения вскоре выходят на плато и постепенно деградируют со временем.
Отделение направления от величины с помощью RLSD
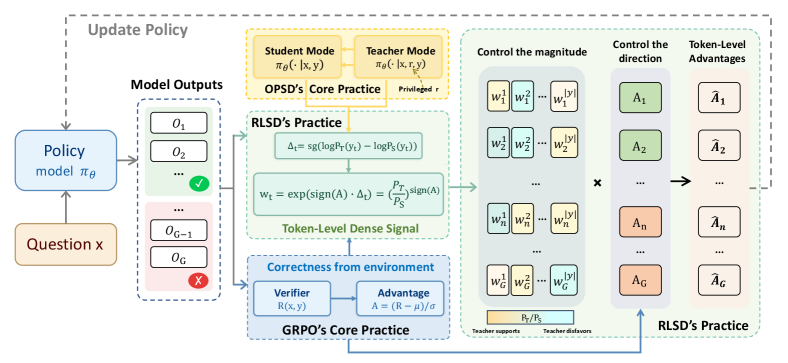
Исследователи, стоящие за созданием RLSD, осознали, что сигналы, управляющие обновлением параметров модели, имеют принципиально асимметричные требования. Они определили, что сигнал, определяющий направление обновления (то есть, нужно ли подкреплять или штрафовать поведение), может быть разреженным, но должен быть абсолютно надежным, поскольку направление модели в неверную сторону разрушает ее стратегию рассуждений.
С другой стороны, сигнал, определяющий величину обновления (то есть, какого относительного кредита или порицания заслуживает конкретный шаг), выигрывает от того, что является чрезвычайно плотным, чтобы обеспечить детальные пошаговые исправления.
RLSD опирается на этот принцип, отделяя направление обновления от величины обновления. Этот фреймворк позволяет проверяемой обратной связи из внешней среды от сигнала RLVR строго определять направление обучения. Модель получает общее подкрепление только в том случае, если окончательный ответ является объективно верным.
Обучение с подкреплением с помощью самодистилляции (RLSD) (источник: arXiv)
Учитель-модель лишается права диктовать, что именно должна генерировать модель. Вместо этого пошаговая оценка учителя используется повторно для определения величины обновления. Она просто распределяет общий объем поощрений или штрафов по отдельным шагам пути рассуждения модели.
Это меняет то, как модель обучается по сравнению с классической парадигмой OPSD. В стандартном OPSD цель обучения действует как поведенческое клонирование, при котором модель вынуждена напрямую копировать точную формулировку и фразы учителя. Это заставляет ученика галлюцинировать и выдавать ссылки на данные, которых у него нет.
Вместо того чтобы заставлять модель копировать скрытое решение, RLSD предоставляет естественный и практически бесплатный источник информации о кредите для каждого токена.
«Интуиция заключается в том, что мы не учим модель рассуждать так же, как учитель, — пояснил Ян. — Мы говорим модели, какие именно ее собственные токены на выбранном ею пути действительно выполняли работу. Распределение путей исследования модели остается ее собственным. Уточняется только распределение заслуг».
Если конкретный вывод сильно поддерживает правильный результат, он получает более высокий балл. Если это просто бесполезное слово-паразит, оно получает базовый балл. RLSD устраняет необходимость обучать сложные вспомогательные сети вознаграждения, вручную аннотировать пошаговые данные или поддерживать громоздкие внешние модели-учителя.
Проверка RLSD на практике
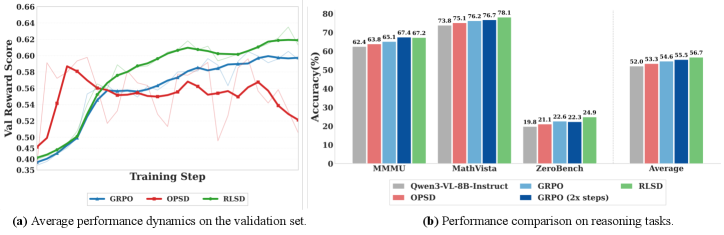
Чтобы протестировать RLSD, исследователи обучили мультиязычную визуальную модель с открытыми весами Qwen3-VL-8B и оценили ее на нескольких бенчмарках визуальных рассуждений. К ним относятся MMMU для многопредметных вопросов уровня колледжа, MathVista, MathVision, WeMath и ZeroBench — стресс-тест, специально разработанный таким образом, чтобы быть практически невыполнимым для нынешних передовых моделей.
Они сравнили модель RLSD с базовой моделью без посторкнирования, со стандартным RLVR с помощью алгоритма GRPO, со стандартным OPSD и с их гибридной комбинацией.
RLSD значительно превзошла все остальные методы, достигнув наибольшей средней точности в 56,18% по всем пяти бенчмаркам. Она опередила базовую модель на 4,69% и превзошла стандартный RLVR на 2,32%. Наиболее выраженными улучшения оказались в задачах со сложными математическими рассуждениями, где RLSD превзошла стандартный RLVR на 3,91% в бенчмарке MathVision.
RLSD превосходит другие методы на ключевых бенчмарках (источник: arXiv)
Помимо точности, фреймворк предлагает колоссальный прирост эффективности. «Конкретно: RLSD за 200 шагов обучения уже превосходит GRPO, обученный за 400 шагов, что дает примерно двукратное ускорение сходимости, — сказал Ян. — Что касается затрат, единственными накладными расходами помимо нормального пайплайна GRPO является один дополнительный прямой проход на каждый ответ для получения логитов учителя. По сравнению с генерацией траекторий… это практически бесплатно».
В отличие от OPSD, в которой производительность сначала взлетала, а затем полностью падала из-за утечки информации, RLSD поддерживала долгосрочную стабильность обучения и сошлась на более высоком уровне производительности по сравнению со стандартными методами.
Качественные результаты подчеркивают, как модель меняет свое поведение в процессе обучения. Например, в сложной задаче на визуальный подсчет стандартный RLVR смотрит на конечный правильный ответ и дает всему абзацу токенов рассуждения одинаковую награду. RLSD хирургически точно применяла награды к конкретным шагам математического вычитания, которые решили проблему, одновременно снижая значимость общего текста-заполнителя, такого как «Глядя на изображение, я вижу…».
В другом примере модель выполнила неверный математический вывод на основе столбчатой диаграммы. Вместо того чтобы пометить весь ответ как сбой, RLSD сосредоточила самый тяжелый штраф именно на той точке, где модель неверно истолковала соотношение из диаграммы. Она осталась нейтральной к остальной логической структуре, признавая, что первоначальная схема была верной.
Это особенно важно для запутанных сценариев корпоративного использования в реальном мире. Если модель совершает ошибку при анализе 50-страничного квартального отчета о прибылях и убытках, разработчики не хотят, чтобы она разучивала всю свою аналитическую структуру. Они хотят лишь исправить конкретное предположение, в котором она ошиблась. RLSD позволяет модели узнать, какие именно логические скачки являются ценными, а какие — ошибочными, токен за токеном. Поскольку RLSD делает это за счет перепрофилирования самой модели, она наделяет модели детальными возможностями рассуждения, сохраняя при этом затраты на обучение на разумном уровне.
С чего начать предприятиям
Для дата-инженеров и команд оркестровки ИИ интеграция RLSD проста, но требует правильной настройки. Самым критическим требованием является проверяемый сигнал вознаграждения, такой как компиляторы кода, средства проверки математических формул, выполнение SQL или валидаторы схем. «Задачи без проверяемой награды (диалоги с открытым концом, написание текстов в тональности бренда) относятся к пайплайнам на основе предпочтений», — пояснил Ян.
Тем не менее RLSD обладает высокой гибкостью в отношении требуемой привилегированной информации. В то время как OPSD структурно требует полных промежуточных цепочек рассуждений, вынуждая предприятия либо нанимать аннотаторов, либо применять дистилляцию с передовой модели, RLSD этого не требует.
«Если у вас есть полные проверенные цепочки рассуждений — отлично, RLSD будет их использовать, — сказал Ян. — Если все, что у вас есть, — это окончательный эталонный ответ, это тоже работает… У OPSD нет такой гибкости».
Интеграция этого метода в существующие открытые многомодальные фреймворки RL, такие как veRL или EasyR1, невероятно проста. По словам Яна, она не требует переписывания фреймворка и легко встраивается в стандартный стек. Замена кода сводится к простой правке нескольких десятков строк для настройки целевой функции GRPO и синхронизации учителя с учеником.
Заглядывая в будущее, RLSD предлагает предприятиям мощный способ максимизировать отдачу от имеющихся у них внутренних активов.
«Проприетарные данные, которые предприятия хранят внутри своего периметра (соответствие нормативам, внутренняя документация, исторические тикеты, проверенные фрагменты кода), по сути, представляют собой бесплатную привилегированную информацию, — подытожил Ян. — RLSD позволяет предприятиям использовать этот тип данных напрямую в качестве привилегированного контекста, что повышает точность сигнала обучения на меньших моделях без необходимости привлечения внешнего учителя и без передачи чего-либо за пределы сети».




