


HDPO от Alibaba сокращает избыточное использование инструментов ИИ-агентами с 98% до 2%


Одной из ключевых трудностей при создании эффективных ИИ-агентов является обучение их выбору между использованием внешних инструментов и опорой на собственные внутренние знания. Однако большие языковые модели часто настраивают на слепой вызов инструментов, что приводит к задержкам, ненужным затратам на API и ухудшению логического мышления из-за шума в окружающей среде.
Чтобы преодолеть эту проблему, исследователи из Alibaba представили иерархическую оптимизацию разделенной политики (Hierarchical Decoupled Policy Optimization, HDPO) — фреймворк обучения с подкреплением, который обучает агентов находить баланс между эффективностью выполнения и точностью решения задач.
Metis, мультимодальная модель, обученная ими с использованием этого фреймворка, сокращает избыточные вызовы инструментов с 98% всего до 2% и одновременно устанавливает новые стандарты точности логического вывода на ключевых отраслевых бенчмарках. Этот фреймворк помогает создавать ИИ-агентов, которые не склонны к импульсивным действиям и знают, когда стоит воздержаться от использования инструментов, что позволяет разрабатывать отзывчивые и экономичные агентные системы.
Метакогнитивный дефицит
Современные агентные модели сталкиваются с тем, что исследователи называют «глубоким метакогнитивным дефицитом». Моделям трудно решить, когда следует использовать свои внутренние параметрические знания, а когда — делать запрос к внешним утилитам. В результате они вслепую вызывают инструменты и API (например, веб-поиск или выполнение кода), даже если промпт пользователя уже содержит всю необходимую информацию для решения задачи.
Такое импульсивное поведение при вызове инструментов создает серьезные операционные препятствия для приложений реального мира. Поскольку модели обучены фокусироваться практически исключительно на выполнении задачи, они равнодушны к задержкам. Эти агенты часто достигают заоблачных показателей вызовов инструментов. Каждый ненужный внешний вызов API создает узкое место последовательной обработки, превращая технически способный ИИ в неповоротливую систему, которая разочаровывает пользователей и истощает бюджеты на инструменты.
В то же время расходование вычислительных ресурсов на чрезмерное использование инструментов не приводит к улучшению логического мышления. Избыточные взаимодействия с инструментами вносят шум в контекст модели. Этот шум может отвлечь модель, нарушить в остальном правильную цепочку рассуждений и активно ухудшить конечный результат.
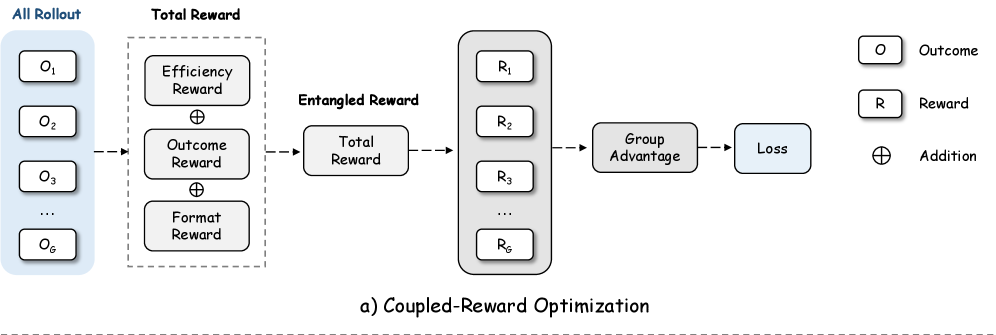
Чтобы решить проблемы с задержками и стоимостью слепого вызова инструментов, предыдущие методы обучения с подкреплением пытались штрафовать за чрезмерное использование инструментов, объединяя точность решения задачи и эффективность выполнения в один сигнал вознаграждения. Однако такой запутанный подход создает неразрешимую дилемму оптимизации. Если штраф за эффективность слишком агрессивен, модель становится чрезмерно консервативной и подавляет необходимое использование инструментов, жертвуя правильностью в сложных задачах. И наоборот, если штраф мягок, сигнал оптимизации теряет свою ценность и не предотвращает избыточное использование инструментов в более простых задачах.
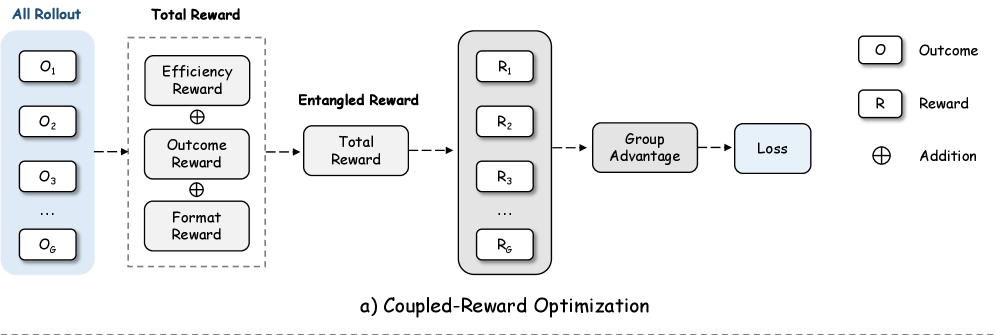
Классические алгоритмы обучения используют составные награды, сочетающие точность и эффективность (источник: arXiv)
Кроме того, эта общая награда создает семантическую двусмысленность, при которой неточная траектория с нулевым количеством вызовов инструментов может принести ту же награду, что и точная траектория с чрезмерным использованием инструментов. Поскольку сигналы обучения для точности и эффективности переплетаются, модель не может научиться контролировать использование инструментов без ухудшения своих основных способностей к рассуждению.
Иерархическая оптимизация разделенной политики
Чтобы решить дилемму оптимизации связанных наград, исследователи представили HDPO. HDPO разделяет точность и эффективность на два независимых канала оптимизации. Канал точности фокусируется на максимизации правильности выполнения задач по всем этапам работы модели. Канал эффективности оптимизирует экономичность выполнения.
HDPO вычисляет сигналы обучения для этих двух каналов независимо и объединяет их только на финальном этапе расчета потерь. Сигнал эффективности ставится в зависимость от канала точности. Это означает, что некорректный ответ никогда не вознаграждается просто за скорость или меньшее использование инструментов. Такое разделение позволяет избежать ситуаций, когда градиенты точности и эффективности нейтрализуют друг друга, обеспечивая ИИ чистые сигналы обучения для обеих целей.
Самым мощным эмерджентным свойством такого разделенного дизайна является то, что он создает неявную учебную программу (когнитивную программу). На ранних этапах обучения, когда модель все еще испытывает трудности с задачей, в оптимизации доминирует цель точности, заставляя модель уделять приоритетное внимание освоению правильных рассуждений и знаний. По мере того как возможности модели к рассуждению зреют и она стабильно приходит к правильным ответам, сигнал эффективности плавно возрастает. Этот механизм заставляет модель сначала освоить решение задач, и только после этого повышать свою самостоятельность, избегая избыточных и дорогостоящих вызовов API.
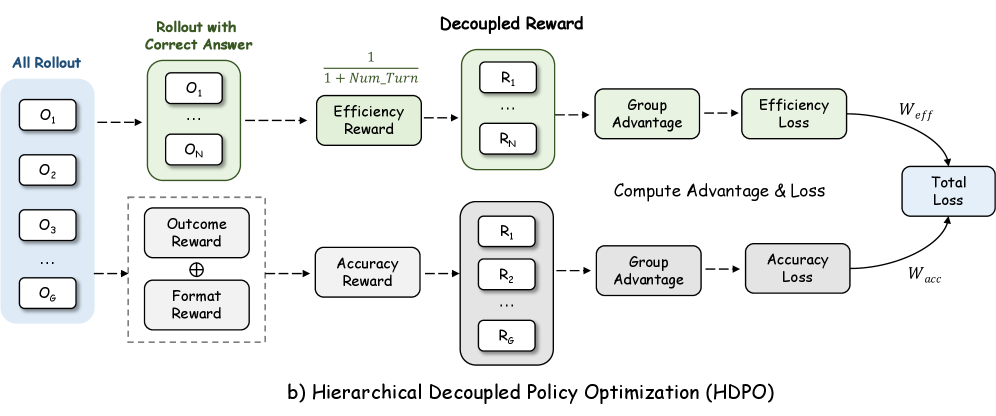
HDPO разделяет эффективность и точность (источник: arXiv)
В дополнение к HDPO исследователи разработали строгий многоэтапный режим кураторства данных, который устраняет серьезные недостатки существующих мультимодальных датасетов с поддержкой инструментов. Их конвейер отбора данных охватывает этапы контролируемого тонкой настройки (SFT) и обучения с подкреплением (RL).
Для фазы SFT они собрали данные из общедоступных мультимодальных траекторий с поддержкой инструментов и отфильтровали их, чтобы удалить низкокачественные примеры, содержащие сбои выполнения или несоответствия в обратной связи. Они также агрессивно отфильтровали любые обучающие выборки, которые базовая модель могла решить напрямую без инструментов. Наконец, используя Gemini 3.1 Pro от Google в качестве автоматического судьи, они отфильтровали корпус SFT, чтобы сохранить только те примеры, которые демонстрируют стратегическое использование инструментов.
Для фазы RL отбор был сосредоточен на обеспечении стабильного сигнала оптимизации. Они отфильтровали промпты с поврежденными визуальными элементами или семантической двусмысленностью. Алгоритм HDPO основан на сравнении правильных и неправильных ответов. Если задача тривиально проста, и модель всегда справляется с ней правильно, или непомерно сложна, и модель всегда терпит неудачу, то нет значимой математической дисперсии, на которой можно было бы учиться. Команда строго сохраняла только те промпты, которые демонстрировали нетривиальное сочетание успехов и неудач, чтобы гарантировать эффективный градиентный сигнал.
Агент Metis: HDPO в действии
Чтобы протестировать HDPO в деле, исследователи использовали этот фреймворк для разработки Metis — мультимодального агента рассуждений, оснащенного инструментами для написания кода и поиска. Metis построен на базе зрения-языковой модели Qwen3-VL-8B-Instruct. Исследователи обучали ее в два этапа. Сначала они применили SFT, используя отобранные данные для инициализации «холодного старта». Затем они применили RL, используя фреймворк HDPO, предоставив модели многоходовые взаимодействия, в которых она могла вызывать такие инструменты, как выполнение кода на Python, текстовый и визуальный поиск.
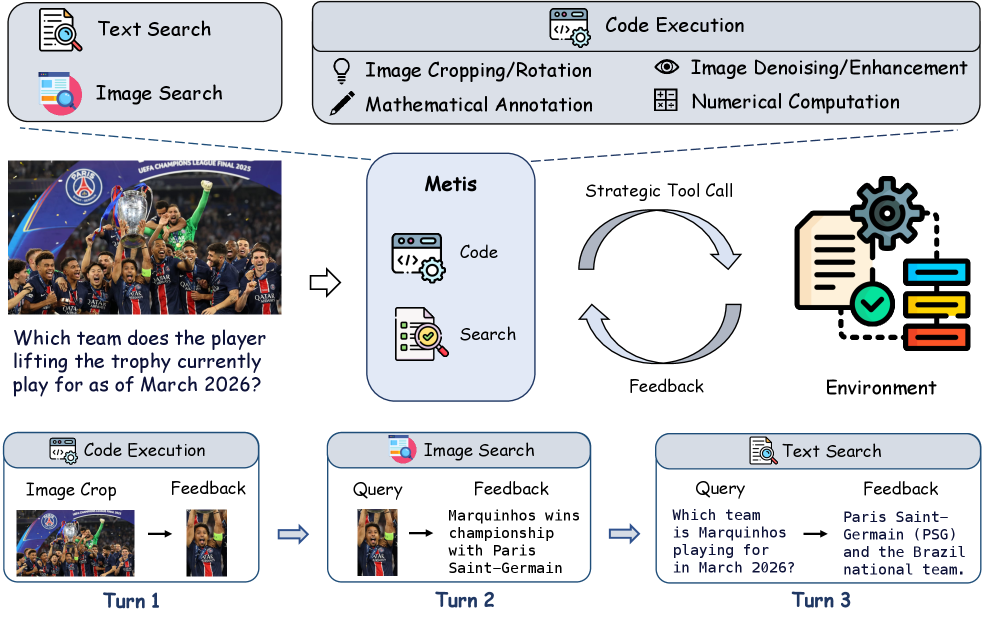
Обзор агентной модели Metis (источник: arXiv)
Исследователи противопоставили Metis стандартным открытым визуальным моделям, таким как LLaVA-OneVision, текстовым решателям и современным агентным моделям, включая DeepEyes V2 и Skywork-R1V4 с 30 миллиардами параметров. Оценка охватывала две основные области: датасеты визуального восприятия и понимания документов, такие как HRBench и V*Bench, а также строгие задачи математического и логического характера, такие как WeMath и MathVista.
Во всех задачах Metis продемонстрировала передовую или крайне конкурентоспособную производительность, опередив существующие агентные модели — в том числе значительно превосходящую ее по размеру Skywork-R1V4 с 30 миллиардами параметров — как в задачах визуального восприятия, так и в задачах рассуждения.
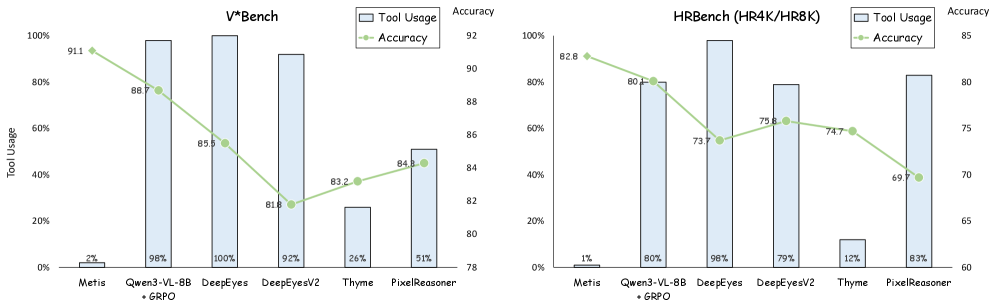
Metis повышает производительность на ключевых бенчмарках, значительно сокращая использование инструментов (источник: arXiv)
Не менее важно и то показательное поведение, которое Metis продемонстрировала в ходе экспериментов. Например, когда модели показали изображение вывески в музее и попросили прочитать текст в центре, стандартные агентные модели тратят время на слепое написание скриптов на Python для кадрирования изображения исключительно ради чтения. Metis же распознает, что текст вполне разборчив на исходном изображении. Она полностью пропускает инструменты и использует один-единственный проход инференса.
В другом эксперименте модели был дан сложный график с просьбой определить вторую по высоте линию в определенной точке данных на крошечном подграфике. Metis осознала, что детальный визуальный анализ превышает ее возможности исходного разрешения и не позволяет точно различить пересекающиеся линии. Вместо того чтобы гадать по полному изображению, она вызвала Python, чтобы вырезать и увеличить исключительно эту область конкретного подграфика, что позволило ей верно идентифицировать линию. Она относится к коду как к точному инструменту, применяемому только тогда, когда визуальные данные действительно неоднозначны, а не как к дефолтному запасному варианту.
Исследователи опубликовали Metis вместе с кодом для HDPO под либеральной лицензией Apache 2.0.
«Наши результаты показывают, что стратегическое использование инструментов и высокая эффективность рассуждений — это не компромисс; напротив, устранение зашумленных, избыточных вызовов инструментов напрямую способствует превосходной точности, — резюмируют исследователи. — В более широком смысле наша работа предполагает смену парадигмы в обучении с поддержкой инструментов: от простого обучения моделей использованию инструментов к воспитанию метакогнитивной мудрости понимания того, когда от них следует воздерживаться».




