


Первые впечатления о Google Gemini 3.1 Pro: «Deep Think Mini» с регулируемыми возможностями рассуждения по запросу


Последние три месяца модель Gemini 3 Pro от Google удерживала позиции одной из самых мощных доступных передовых моделей. Но в стремительном мире искусственного интеллекта три месяца — это целая вечность, и конкуренты не стояли на месте.
Ранее сегодня Google выпустила Gemini 3.1 Pro — обновление, которое привносит ключевое нововведение в основную рабочую модель компании: три уровня настраиваемого мышления, фактически превращающие её в облегченную версию специализированной системы рассуждений Deep Think от Google.
Этот выпуск знаменует собой первый случай, когда Google выпускает минорное («point one») обновление для модели Gemini, что сигнализирует об изменении стратегии релизов компании: переход от периодических запусков полноценных версий к более частым инкрементальным улучшениям. Что еще важнее для корпоративных команд по ИИ, оценивающих свой стек моделей, новая трехуровневая система мышления 3.1 Pro (низкий, средний и высокий уровни) предоставляет разработчикам и ИТ-лидерам единую модель, способную динамически масштабировать глубину рассуждений — от быстрых ответов на рутинные запросы до многоминутных сеансов глубоких размышлений над сложными задачами.
Модель уже развертывается в режиме предварительного просмотра через Gemini API на базе Google AI Studio, Gemini CLI, платформы агентской разработки Google Antigravity, Vertex AI, Gemini Enterprise, Android Studio, потребительского приложения Gemini и NotebookLM.
Эффект «Deep Think Mini»: настраиваемые рассуждения по требованию
Самой значимой функцией в Gemini 3.1 Pro является вовсе не какой-то отдельный показатель в бенчмарках, а внедрение трехуровневой системы мышления, которая дает пользователям детальный контроль над тем, сколько вычислительных ресурсов модель направляет на каждый ответ.
Gemini 3 Pro предлагала всего два режима мышления: низкий и высокий. Новая версия 3.1 Pro добавляет средний параметр (аналогичный прежнему высокому) и, что критически важно, полностью переосмысляет значение «высокого» уровня. При выборе высокого уровня 3.1 Pro ведет себя как «мини-версия Gemini Deep Think» — специализированной модели рассуждений компании, которая была обновлена буквально на прошлой неделе.
Последствия для корпоративного развертывания могут быть значительными. Вместо того чтобы перенаправлять запросы на разные специализированные модели в зависимости от сложности задачи — распространенный, но трудоемкий в управлении подход, — организации теперь могут использовать единую конечную точку модели и регулировать глубину рассуждений в зависимости от текущей задачи. Рутинное создание кратких выдержек из документов может выполняться в режиме низкого уровня мышления с высокой скоростью отклика, в то время как сложные аналитические задачи можно переводить на высокий уровень для рассуждений уровня Deep Think.
Производительность в бенчмарках: более чем двукратное увеличение эффективности рассуждений по сравнению с 3 Pro
Опубликованные Google результаты бенчмарков свидетельствуют о драматическом улучшении, особенно в областях, связанных с рассуждениями и агентными возможностями.
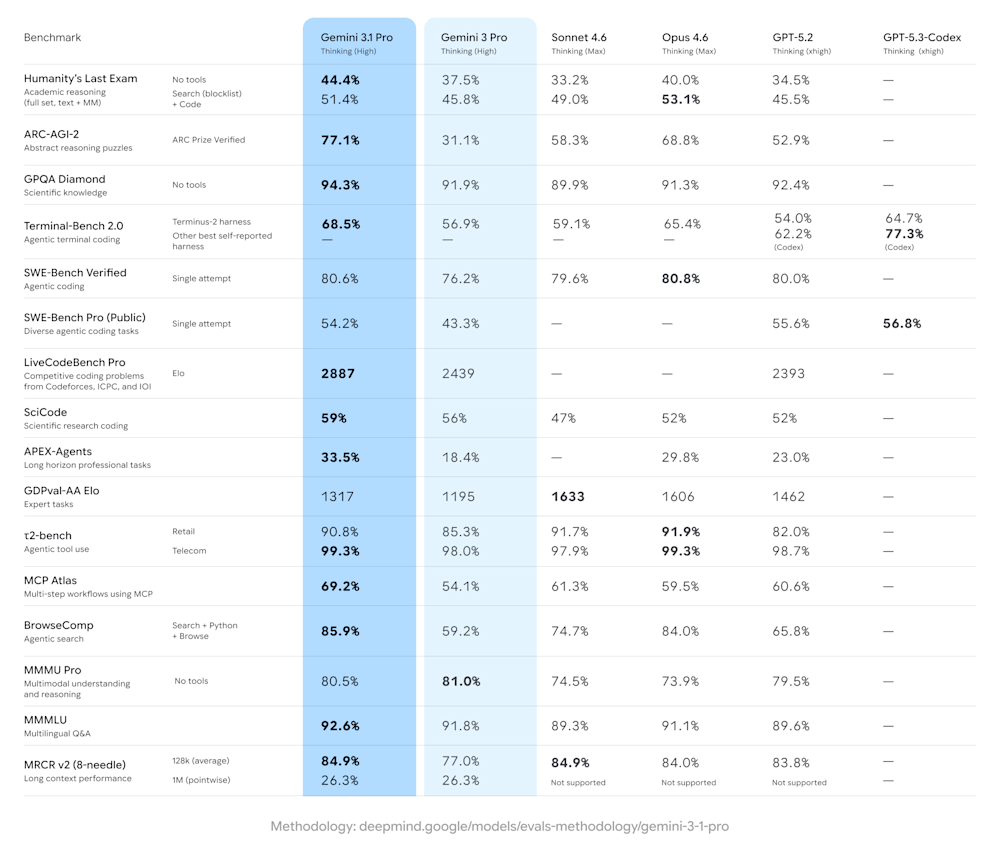
График бенчмарков Google Gemini 3.1 Pro. Источник: Google
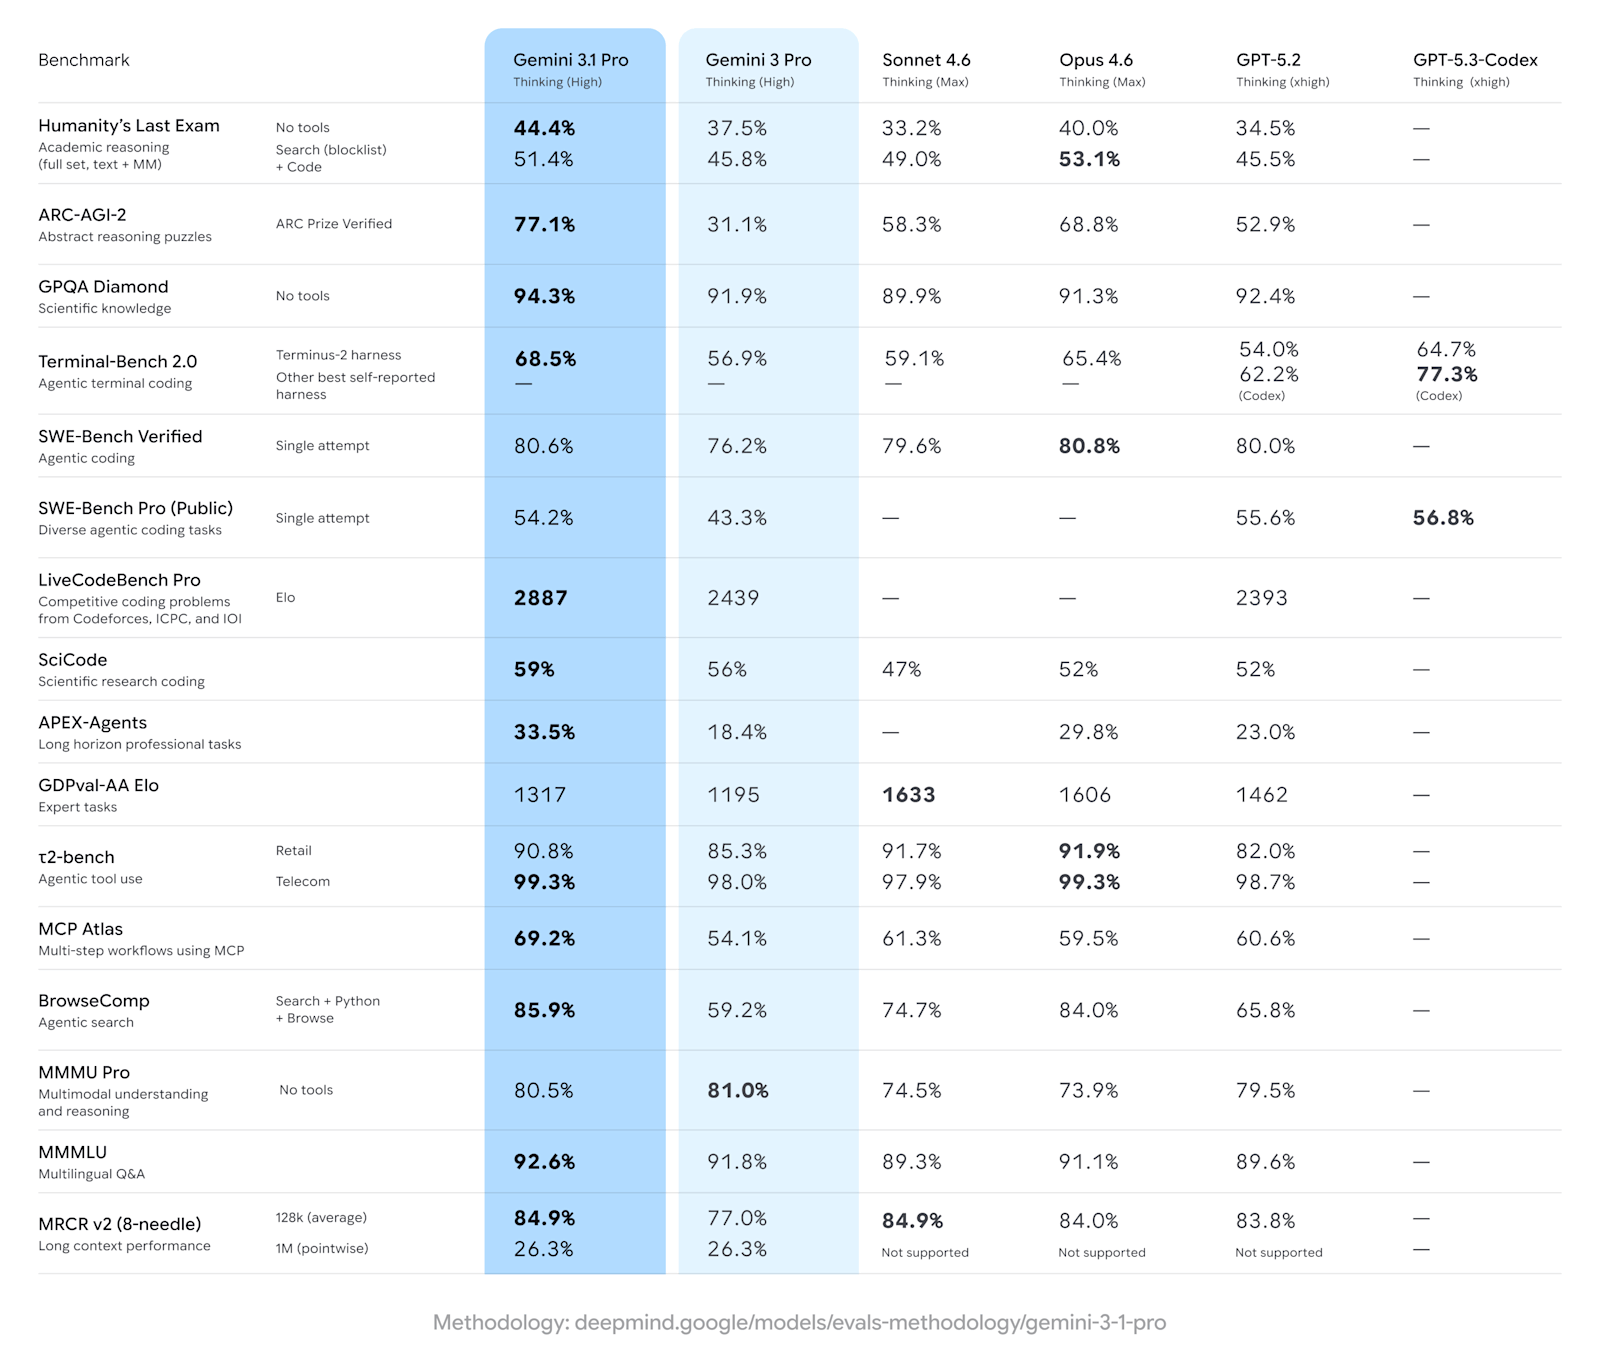
В бенчмарке ARC-AGI-2, оценивающем способность модели решать новые задачи на абстрактное мышление, 3.1 Pro набрала 77,1% — более чем в два раза больше по сравнению с 31,1% у Gemini 3 Pro, и существенно опередила модели Sonnet 4.6 (58,3%) и Opus 4.6 (68.8%) от Anthropic. Этот результат также превосходит GPT-5.2 от OpenAI (52,9%).
Прирост наблюдается по всем направлениям. В Humanity’s Last Exam, строгом академическом бенчмарке на проверку рассуждений, 3.1 Pro показала результат 44,4% без использования инструментов (по сравнению с 37,5% у 3 Pro), опередив как Claude Sonnet 4.6 (33,2%), так и Opus 4.6 (40,0%). В тесте научных знаний GPQA Diamond модель 3.1 Pro достигла 94,3%, превзойдя всех указанных конкурентов.
Результаты становятся особенно актуальными для корпоративных команд по ИИ в агентных бенчмарках — тестах, измеряющих эффективность работы моделей при использовании инструментов и многоэтапных задач, то есть в тех сценариях, которые всё чаще определяют внедрение ИИ на производстве.
В бенчмарке Terminal-Bench 2.0, оценивающем агентное написание кода в терминале, 3.1 Pro набрала 68,5% по сравнению с 56,9% у предшественницы. В MCP Atlas — бенчмарке, измеряющем многоэтапные рабочие процессы с использованием протокола Model Context Protocol, — 3.1 Pro достигла 69,2%, что на 15 пунктов превосходит показатель 3 Pro (54,1%) и почти на 10 пунктов опережает Claude и GPT-5.2. А в BrowseComp, проверяющем возможности агентного веб-поиска, 3.1 Pro набрала 85,9%, резко обойдя 59,2% модели 3 Pro.
Почему Google выбрала релиз «0.1» и о чем это говорит
Само решение о нумерации заслуживает внимания. Предыдущие релизы Gemini следовали схеме датированных превью — например, несколько предварительных версий 2.5 перед выходом в общий доступ. Решение обозначить это обновление как 3.1, а не как очередное превью 3 Pro, предполагает, что в Google считают улучшения достаточно существенными для инкремента версии, в то время как добавление «микро-версии» (point one) задает ожидания, что это эволюция, а не революция.
В записи в блоге Google отмечается, что 3.1 Pro напрямую опирается на опыт серии Gemini Deep Think, включая методы как из более ранних, так и из недавних версий. Бенчмарки убедительно свидетельствуют о том, что обучение с подкреплением сыграло ключевую роль в достижении таких результатов, особенно в таких задачах, как ARC-AGI-2, бенчмарки кодирования и агентные оценки — ровно в тех областях, где среды обучения на основе RL могут предоставить четкие сигналы вознаграждения.
Модель выпускается в предварительной версии, а не в общем доступе (GA). При этом в Google заявляют, что продолжат совершенствовать такие направления, как агентные рабочие процессы, прежде чем переходить к полноценному релизу GA.
Влияние на конкурентную борьбу в вашем корпоративном стеке ИИ
Для ИТ-директоров, оценивающих поставщиков передовых моделей, выход Gemini 3.1 Pro заставляет не только пересмотреть выбор моделей, но и задуматься о том, как адаптироваться к столь стремительным темпам изменений в собственных продуктах и сервисах.
Теперь возникает вопрос, вызовет ли этот релиз ответную реакцию у конкурентов. Первоначальный запуск Gemini 3 Pro в ноябре прошлого года спровоцировал волну выпусков моделей как в экосистемах с закрытым исходным кодом, так и с открытыми весами.
Поскольку 3.1 Pro возвращает лидерство в бенчмарках в нескольких критически важных категориях, давление на Anthropic, OpenAI и сообщество разработчиков моделей с открытыми весами возрастает — и в нынешнем ландшафте ИИ эта ответная реакция, вероятнее всего, будет измеряться неделями, а не месяцами.
Доступность
Gemini 3.1 Pro уже доступна в режиме превью через Gemini API в Google AI Studio, Gemini CLI, Google Antigravity и Android Studio для разработчиков. Корпоративные клиенты могут получить к ней доступ через Vertex AI и Gemini Enterprise. Обычные пользователи с подписками Google AI Pro и Ultra могут воспользоваться моделью через приложение Gemini и NotebookLM.




