


Гиперагенты Meta развивают самосовершенствующийся ИИ


Создание самосовершенствующихся систем ИИ — это важный шаг на пути к внедрению агентов в динамичные среды, особенно в корпоративные производственные условия, где задачи не всегда предсказуемы или однородны.
Существующие самосовершенствующиеся системы ИИ сталкиваются с серьезными ограничениями, поскольку они полагаются на фиксированные механизмы улучшения, созданные вручную, которые работают только в строгих условиях, таких как разработка программного обеспечения.
Чтобы преодолеть эту практическую проблему, исследователи из Meta и нескольких университетов представили «гиперагенты» (hyperagents) — самосовершенствующуюся систему ИИ, которая непрерывно переписывает и оптимизирует свою логику решения задач и лежащий в ее основе код.
На практике это позволяет ИИ самосовершенствоваться в областях, не связанных с программированием, таких как робототехника и проверка документов. Агент самостоятельно изобретает возможности общего назначения, такие как постоянная память и автоматическое отслеживание производительности.
В более широком смысле, гиперагенты не просто лучше справляются с задачами — они учатся совершенствовать сам цикл самосовершенствования для ускорения прогресса.
Эта структура может помочь в разработке высокоадаптируемых агентов, которые автономно создают структурированные, многоразовые механизмы принятия решений. Такой подход со временем наращивает возможности, снижая потребность в постоянном ручном проектировании промптов и специфичной для домена ручной настройке.
Текущий самосовершенствующийся ИИ и его архитектурные узкие места
Основная цель самосовершенствующихся систем ИИ заключается в постоянном расширении собственных возможностей обучения и решения задач. Однако большинство существующих моделей самосовершенствования полагаются на фиксированного «метаагента». Эта статический высокоуровневый надзорный модуль предназначен для модификации базовой системы.
«Главное ограничение созданных вручную метаагентов заключается в том, что они могут совершенствоваться только с той скоростью, с какой люди могут их проектировать и поддерживать», — рассказала VentureBeat Дженни Чжан (Jenny Zhang), соавтор научной работы. «Каждый раз, когда что-то меняется или ломается, человеку приходится вмешиваться и обновлять правила или логику».
Вместо абстрактного теоретического предела это создает практическую «стену обслуживания».
Текущая парадигма связывает улучшение системы напрямую со скоростью итераций человека, замедляя прогресс, поскольку она сильно зависит от ручного инженерного труда, а не от масштабирования за счет опыта, собираемого агентом.
Чтобы преодолеть это ограничение, исследователи утверждают, что система ИИ должна быть «полностью самореферентной». Такие системы должны уметь анализировать, оценивать и переписывать любую свою часть без ограничений, заложенных при первоначальной настройке. Это позволяет системе ИИ вырваться из структурных ограничений и стать саморазгоняющейся.
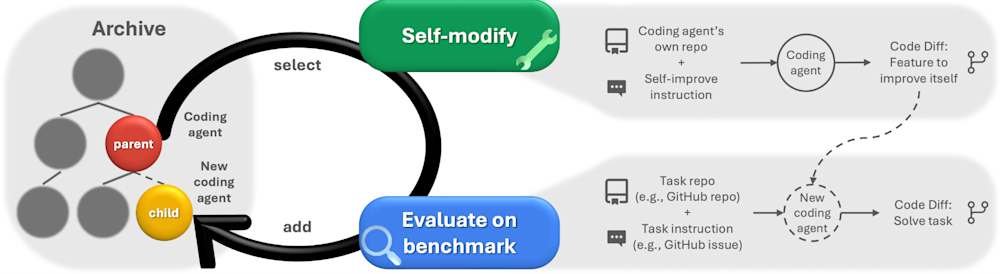
Машина Дарвина — Гёделя (источник: Sakana AI)
Одним из примеров самореферентной системы ИИ является Машина Дарвина — Гёделя (Darwin Gödel Machine, DGM) от Sakana AI — система ИИ, которая совершенствует себя путем перезаписи собственного кода.
В DGM агент итеративно генерирует, оценивает и модифицирует свой собственный код, сохраняя успешные варианты в архиве, который служит отправной точкой для будущих улучшений. DGM доказала, что открытое рекурсивное самосовершенствование вполне достижимо на практике в сфере программирования.
Тем не менее, DGM не справляется при применении к реальным задачам за пределами разработки программного обеспечения из-за критического разрыва в навыках. В DGM система улучшается, поскольку и оценка, и самомодификация являются задачами программирования. Повышение способностей агента к кодированию естественным образом улучшает его способность переписывать собственный код. Но если вы развернете DGM для непрограммистской корпоративной задачи, это соответствие нарушится.
«Для таких задач, как математика, поэзия или рецензирование статей, улучшение производительности задач не обязательно повышает способность агента изменять собственное поведение», — отметила Чжан.
Навыки, необходимые для анализа субъективного текста или бизнес-данных, кардинально отличаются от навыков, требуемых для анализа сбоев и написания нового кода на Python для их исправления.
DGM также опирается на фиксированный механизм, созданный человеком, для генерации инструкций по самосовершенствованию. На практике, если корпоративные разработчики хотят использовать DGM для чего-то помимо программирования, им приходится серьезно дорабатывать и вручную настраивать промпты инструкций для каждого нового домена.
Фреймворк гиперагентов
Чтобы преодолеть ограничения предыдущих архитектур, исследователи представляют гиперагентов. Эта концепция предлагает «самореферентных агентов, которые в принципе могут самосовершенствоваться для любой вычислимой задачи».
В этой структуре агент представляет собой любую вычислимую программу, которая может вызывать языковые модели, внешние инструменты или обученные компоненты. Традиционно такие системы разделяются на две разные роли: «агент задачи», который выполняет конкретную поставленную проблему, и «метаагент», который анализирует агентов и вносит в них изменения. Гиперагент объединяет как агента задачи, так и метаагента в единую, самореферентную и редактируемую программу.
Поскольку всю программу можно переписать, система способна модифицировать сам механизм самосовершенствования — процесс, который исследователи называют метакогнитивной самомодификацией.
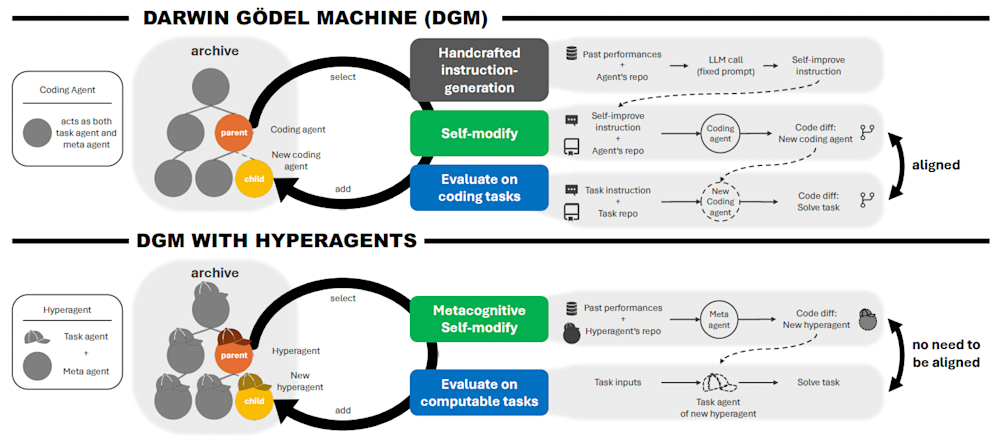
DGM с гиперагентами (источник: arXiv)
«Гиперагенты не просто учатся лучше решать поставленные задачи, но и учатся совершенствоваться», — сказала Чжан. «Со временем это приводит к накоплению. Гиперагентам не нужно заново изобретать способы улучшения в каждой новой области. Вместо этого они сохраняют и развивают улучшения самого процесса самосовершенствования, позволяя прогрессу накапливаться от задачи к задаче».
Исследователи расширили Машину Дарвина — Гёделя, создав гиперагенты DGM (DGM-Hyperagents, DGM-H). DGM-H сохраняет мощную структуру открытого исследования оригинальной DGM, которая предотвращает слишком раннюю сходимость ИИ или попадание в тупики за счет поддержания растущего архива успешных гиперагентов.
Система непрерывно ответвляется от выбранных кандидатов в этом архиве, позволяет им самомодифицироваться, оценивает новые варианты на заданных задачах и добавляет успешные обратно в пул в качестве ступеней для будущих итераций.
Сочетая этот эволюционный поиск открытого типа с метакогнитивной самомодификацией, DGM-H устраняет фиксированный шаг инструкций исходного DGM, созданный человеком. Это позволяет агенту самосовершенствоваться в любой вычислимой задаче.
Гиперагенты в действии
Исследователи использовали бенчмарк кодирования Polyglot для сравнения фреймворка гиперагентов с предыдущими ИИ, ориентированными исключительно на программирование. Они также оценили гиперагенты в областях, не связанных с программированием, которые включают субъективные рассуждения, использование внешних инструментов и сложную логику.
Среди них были рецензирование научных статей для имитации решений рецензентов об их принятии или отклонении, разработка модели вознаграждения для обучения четвероногого робота и оценка математических олимпиадных задач. Оценка математических задач служила отложенным тестом, чтобы проверить, может ли ИИ, который научился самосовершенствоваться при рецензировании статей и проектировании роботов, перенести эти метанавыки на совершенно неизученную область.
Исследователи сравнили гиперагенты с несколькими базовыми моделями, включая узкоспециализированные модели, такие как AI-Scientist-v2 для рецензирования статей и ProofAutoGrader для математики. Они также провели тестирование против классического DGM и вручную настроенного DGM для новых доменов.
В бенчмарке кодирования гиперагенты не уступили по производительности DGM, несмотря на то, что не были специально разработаны для программирования. При рецензировании статей и в робототехнике гиперагенты превзошли базовые модели с открытым исходным кодом и функции вознаграждения, созданные людьми.
Когда исследователи взяли гиперагент, оптимизированный для рецензирования статей и робототехники, и применили его к неизученной задаче оценки по математике, он достиг метрики улучшения 0,630 за 50 итераций. Базовые показатели, опирающиеся на классические архитектуры DGM, остались на нулевом уровне (0,0). Гиперагент даже обошел узкоспециализированный ProofAutoGrader.
Эксперименты также выявили интересное автономное поведение гиперагентов. При оценке статей агент сначала использовал стандартные приемы инженерии промптов, такие как принятие строгой роли. Когда это оказалось ненадежным, он переписал собственный код для создания многоэтапного конвейера оценки с явными контрольными списками и жесткими правилами принятия решений, что привело к гораздо более высокой согласованности.
Гиперагенты также автономно разработали инструмент памяти, чтобы не повторять прошлых ошибок. Кроме того, система написала средство отслеживания производительности для регистрации и мониторинга результатов архитектурных изменений между поколениями. Модель даже разработала поведение, учитывающее вычислительный бюджет: она отслеживала оставшиеся итерации для корректировки своего планирования. Ранние поколения выполняли амбициозные архитектурные изменения, в то время как более поздние поколения сосредоточились на консервативных, поэтапных доработках.
Корпоративным командам по работе с данными, которые раздумывают, с чего начать, Чжан рекомендует сосредоточиться на задачах, где успех не вызывает сомнений. «Рабочие процессы, которые четко определены и легко поддаются оценке, часто называемые верифицируемыми задачами, являются лучшей отправной точкой», — говорит она. «В целом это открывает новые возможности для более исследовательского прототипирования, более исчерпывающего анализа данных, более глубокого А/Б-тестирования [и] ускоренной разработки фич». Для более сложных, не верифицированных задач команды могут использовать гиперагенты для первоначальной разработки обученных судей, которые лучше отражают человеческие предпочтения, создавая мост к более сложным доменам.
Исследователи поделились кодом гиперагентов, хотя он был выпущен под некоммерческой лицензией.
Предостережения и будущие угрозы
Преимущества гиперагентов порождают очевидные компромиссы. Исследователи выделяют несколько соображений безопасности в отношении систем, которые могут модифицировать себя все более непредсказуемыми способами.
Эти системы ИИ создают риск эволюционирования гораздо быстрее, чем люди успевают их проверять или интерпретировать. Хотя исследователи удерживали DGM-H в рамках границ безопасности, таких как изолированные среды (песочницы), предназначенные для предотвращения непредвиденных побочных эффектов, эти первоначальные средства защиты на самом деле являются практическими чертежами развертывания.
Чжан советует разработчикам устанавливать ресурсные лимиты и ограничивать доступ к внешним системам на этапе самомодификации. «Ключевой принцип заключается в отделении экспериментов от развертывания: позволить агенту исследовать и совершенствоваться в контролируемой песочнице, гарантируя при этом, что любые изменения, затрагивающие реальные системы, тщательно проверяются перед применением», — отметила она. Только после того, как вновь измененный код пройдет определенные разработчиком проверки на корректность, его можно переводить в рабочую среду.
Другая значительная опасность — это манипуляции с оценкой (evaluation gaming), когда ИИ улучшает свои метрики без реального прогресса в достижении намеченной цели в реальном мире. Поскольку гиперагенты руководствуются эмпирическими сигналами оценки, они могут автономно обнаруживать стратегии, которые эксплуатируют слепые зоны или слабости самой процедуры оценки для искусственного завышения своих баллов. Предотвращение такого поведения требует от разработчиков внедрения разнообразных, надежных и периодически обновляемых протоколов оценки наряду с постоянным контролем со стороны человека.
В конечном счете эти системы изменят повседневные обязанности инженеров-людей. Подобно тому, как мы не пересчитываем каждую операцию, выполняемую калькулятором, будущие инженеры по оркестрации ИИ не будут писать логику улучшений напрямую, считает Чжан.
Вместо этого они будут проектировать механизмы аудита и стресс-тестирования системы. «По мере того как самосовершенствующиеся системы становятся все более способными, вопрос заключается уже не просто в том, как улучшить производительность, а в том, какие цели стоят того, чтобы их преследовать», — сказала Чжан. «В этом смысле роль эволюционирует от создания систем к формированию их направления».




