Стэнфорд: ИИ с одним агентом превосходит многоагентные системы
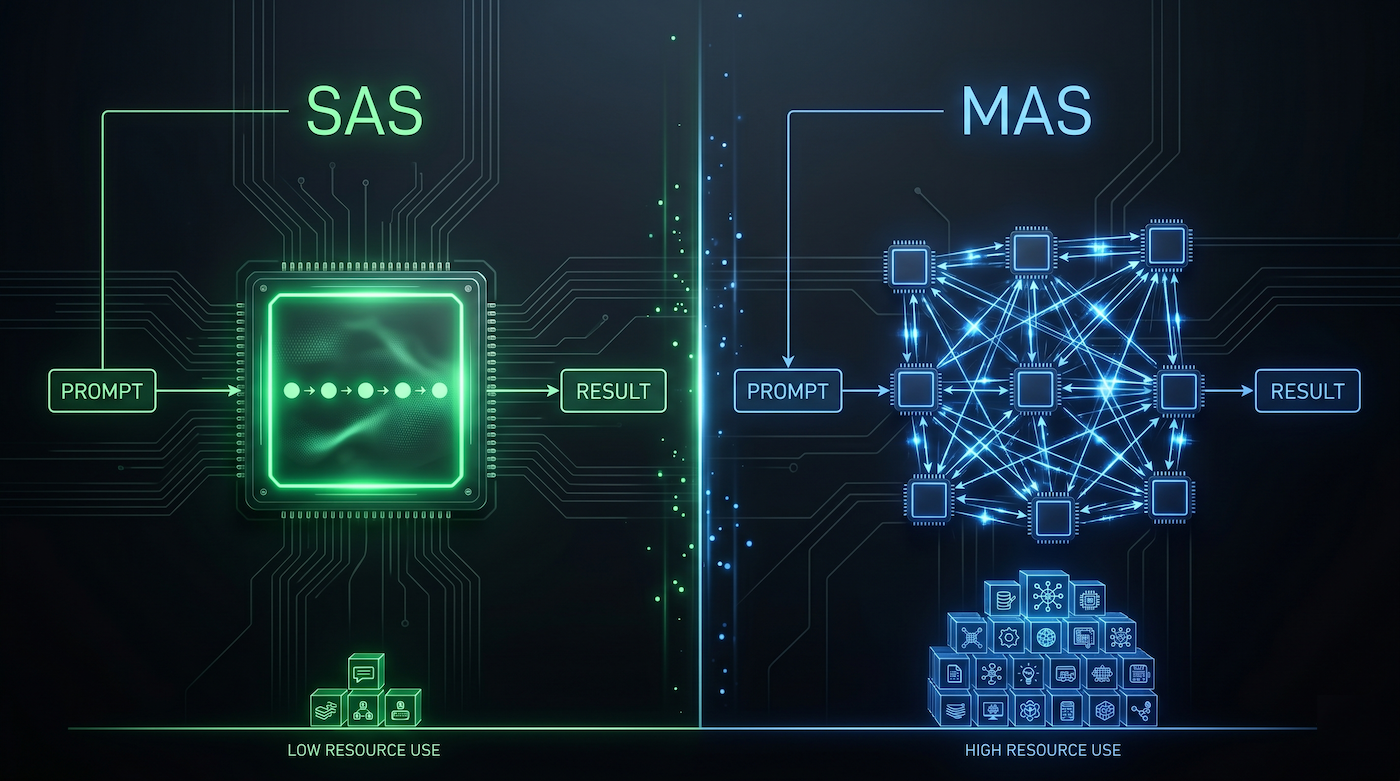


Корпоративные команды, создающие многоагентные системы искусственного интеллекта, возможно, переплачивают за вычислительные ресурсы ради преимуществ, которые не подтверждаются в условиях равных бюджетов. Новое исследование Стэнфордского университета показывает, что одноагентные системы не уступают или превосходят многоагентные архитектуры при решении задач на сложные логические выводы, если обеим выделен одинаковый бюджет токенов для размышлений.
Тем не менее, многоагентные системы сопряжены с дополнительным бременем в виде вычислительных затрат. Поскольку они обычно используют более длинные цепочки рассуждений и множество взаимодействий, часто остается неясным, проистекают ли заявленные ими улучшения из архитектурных преимуществ или просто из потребления большего объема ресурсов.
Чтобы выделить истинный драйвер производительности, исследователи из Стэнфордского университета сравнили одноагентные системы с многоагентными архитектурами при выполнении задач на многошаговый логический вывод в условиях равных бюджетов «токенов размышления».
Их эксперименты показывают, что в большинстве случаев одноагентные системы не уступают или превосходят многоагентные при равных вычислительных затратах. Многоагентные системы получают конкурентное преимущество тогда, когда контекст отдельного агента становится слишком длинным или искаженным.
На практике это означает, что модель с одним агентом и адекватным бюджетом на размышления способна обеспечить более эффективный, надежный и экономичный многошаговый логический вывод. Инженерным командам следует использовать многоагентные системы лишь для тех сценариев, где одиночные агенты достигают своего предельного уровня производительности.
Понимание различий между одноагентными и многоагентными системами
Многоагентные фреймворки — такие как агенты-планировщики, системы с ролевыми играми или дискуссионные рои — разбивают задачу на части, заставляя несколько моделей работать с частичными контекстами. Эти компоненты общаются друг с другом, передавая свои ответы.
Хотя многоагентные решения демонстрируют высокие эмпирические результаты, их сравнение с базовыми одноагентными моделями зачастую оказывается неточным. Сопоставления сильно искажаются различиями в объемах вычислений на этапе тестирования. Многоагентные конфигурации требуют взаимодействия нескольких агентов и генерируют более длинные цепочки рассуждений, а значит, потребляют значительно больше токенов.
Одноагентные системы (SAS) против многоагентных систем (MAS)
В результате, когда многоагентная система сообщает о более высокой точности, сложно определить, достигнут ли этот прирост за счет лучшего архитектурного дизайна или благодаря расходу дополнительных вычислений.
Недавние исследования показывают, что при фиксированном бюджете вычислений сложные многоагентные стратегии часто проигрывают сильным одноагентным базовым моделям. Тем не менее, в основном это очень широкие сравнения, не учитывающие такие нюансы, как различные многоагентные архитектуры или разницу между токенами промпта и токенами рассуждений.
«Центральная идея нашей работы заключается в том, что многие сравнения между одноагентными системами (SAS) и многоагентными системами (MAS) некорректны», — рассказали авторы исследования Дат Чан (Dat Tran) и Доуве Кила (Douwe Kiela) изданию VentureBeat. — «MAS часто получают более эффективные вычисления на этапе тестирования за счет дополнительных вызовов, более длинных цепочек рассуждений или большего количества шагов координации».
Пересмотр проблемы многоагентности в условиях жестких бюджетов
Чтобы обеспечить честное сравнение, исследователи из Стэнфорда установили строгий бюджет «токенов размышления». Этот показатель контролирует общее число токенов, используемых исключительно для промежуточных рассуждений, исключая исходный промпт и финальный ответ.
В ходе исследования оценивались одно- и многоагентные системы на задачах многошагового логического вывода — то есть вопросах, требующих соединения нескольких разрозненных фрагментов информации для получения ответа.
Во время экспериментов исследователи заметили, что настройки с одним агентом иногда преждевременно останавливают свои внутренние рассуждения, оставляя доступный вычислительный бюджет неиспользованным. Чтобы противостоять этому, они внедрили метод под названием SAS-L (single-agent system with longer thinking — одноагентная система с более продолжительными размышлениями).
Вместо того чтобы прибегать к многоагентной оркестровке при раннем отказе модели, исследователи предлагают простое изменение промпта и бюджетирования.
«Инженерная идея проста, — говорят Чан и Кила. — Сначала переструктурируйте промпт для единственного агента так, чтобы модель явно поощрялась расходовать доступный бюджет на рассуждения для предварительного анализа перед формированием ответа».
Инструктируя модель явно выявлять неопределенности, перечислять возможные интерпретации и тестировать альтернативы перед принятием окончательного ответа, разработчики могут вернуть преимущества совместной работы в рамках настройки с одним агентом.
Результаты экспериментов подтверждают, что одиночный агент является наиболее надежной архитектурой по умолчанию для задач многошагового вывода. Она обеспечивает ответы с наивысшей точностью при меньшем потреблении токенов рассуждений. В сочетании с конкретными моделями, такими как Gemini 2.5 от Google, вариант с более долгим размышлением дает еще лучшие общие показатели.
Исследователи опираются на концепцию под названием «Информационное неравенство обработки данных» (Data Processing Inequality), чтобы объяснить, почему одиночный агент превосходит рой. Многоагентные фреймворки привносят присущие им коммуникационные узкие места. Каждый раз, когда информация суммируется и передается между разными агентами, возникает риск потери данных.
Напротив, одиночный агент, рассуждающий в рамках единого непрерывного контекста, избегает этой фрагментации. Он сохраняет доступ к наиболее полному представлению задачи и, следовательно, более информационно эффективен при фиксированном бюджете.
Авторы также отмечают, что компании часто упускают из виду второстепенные издержки многоагентных систем.
«Компании часто недооценивают тот факт, что оркестровка не бесплатна, — отмечают они. — Каждый дополнительный агент привносит накладные расходы на коммуникацию, больше промежуточного текста, больше возможностей для суммирования с потерями и больше точек для накопления ошибок».
С другой стороны, они обнаружили, что многоагентная оркестровка превосходит другие методы, когда окружение одиночного агента становится хаотичным. Если корпоративное приложение должно работать с сильно деградировавшими контекстами — такими как зашумленные данные, длинные входные данные, наполненные отвлекающими факторами, или искаженная информация, — одиночный агент испытывает трудности. В таких сценариях структурированная фильтрация, декомпозиция и верификация многоагентной системы позволяют более надежно извлекать релевантную информацию.
Исследование также предупреждает о скрытых ловушках оценки, которые искусственно завышают производительность многоагентных систем. Опора исключительно на количество токенов, отчитываемое API, серьезно искажает объем вычислений, который архитектура фактически тратит. Исследователи обнаружили эти артефакты учета при тестировании таких моделей, как Gemini 2.5, доказав, что это актуальная проблема для современных корпоративных приложений.
«Для моделей через API ситуация сложнее, потому что учет бюджета может быть непрозрачным», — говорят авторы. Чтобы надежно оценивать архитектуры, они советуют разработчикам «логировать всё, измерять видимые цепочки рассуждений там, где это доступно, использовать показатели токенов рассуждений от провайдеров, если они предоставляются, и относиться к этим цифрам с осторожностью».
Что это значит для разработчиков
Если одноагентная система соответствует производительности нескольких агентов при равных бюджетах рассуждений, она побеждает по совокупной стоимости владения (TCO) за счет меньшего числа вызовов моделей, более низкой задержки и более простой отладки. Чан и Кила предупреждают, что без этой базовой линии «некоторые компании могут переплачивать крупный «налог на рой» за архитектуры, чье кажущееся преимущество на самом деле проистекает из расходования больших вычислительных ресурсов, а не из более эффективного мышления».
Другой способ взглянуть на границу принятия решений заключается не в оценке сложности всей задачи в целом, а в понимании того, где именно кроется узкое место.
«Если речь идет главным образом о глубине рассуждений, SAS зачастую вполне достаточно. Если же проблема в фрагментации или деградации контекста, MAS становится более обоснованной», — говорит Чан.
Инженерным командам следует оставаться на едином агенте, когда задача может быть решена в рамках одного связного контекстного окна. Многоагентные системы становятся необходимыми, когда приложение работает с сильно деградировавшими контекстами.
Заглядывая в будущее, отметим, что многоагентные фреймворки не исчезнут, но их роль будет эволюционировать по мере того, как передовые модели улучшают свои внутренние возможности рассуждения.
«Главный вывод нашей работы заключается в том, что многоагентную структуру следует рассматривать как целевой инженерный выбор для устранения конкретных узких мест, а не как предположение по умолчанию, что большее количество агентов автоматически означает лучший интеллект», — резюмирует Чан.