Beam от Reflection намерен обойти китайские модели с открытым исходным кодом за счёт меньшего числа токенов, а не более дешёвых токенов
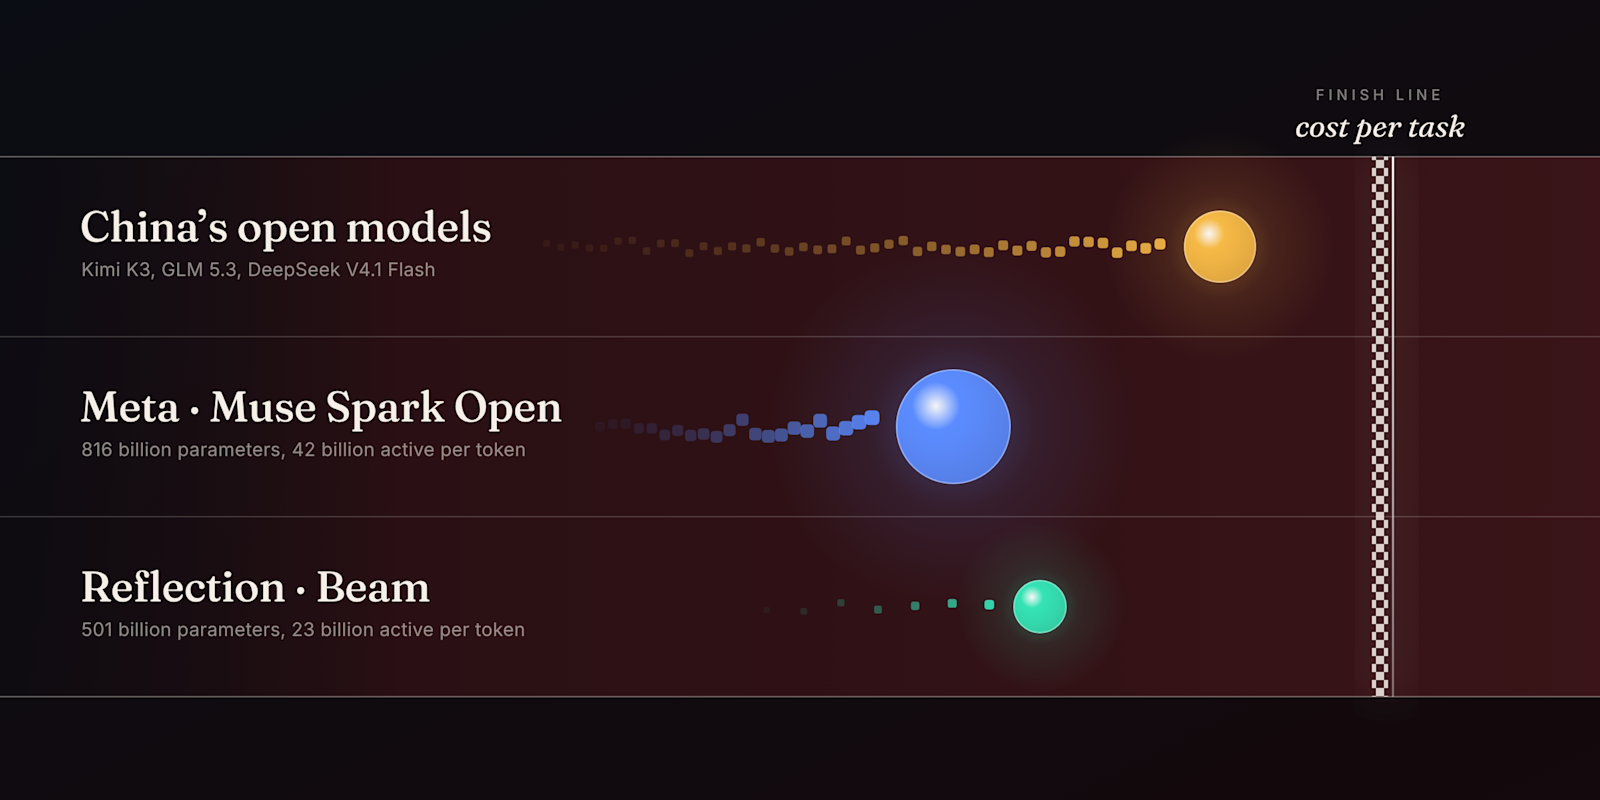


Сегодня Reflection AI опубликовала веса Beam — своей первой открытой модели — и позиционирует её как конкурента китайским открытым моделям, которые уже внедряют многие американские компании благодаря более низкой стоимости.
Reflection рассчитывает, что Beam — модель с 501 миллиардом параметров — сможет выполнять задачу, используя гораздо меньше токенов, чем другие модели такого размера. По словам Reflection, это снижает стоимость каждой выполненной задачи.
Beam появилась на следующий день после того, как Meta представила Muse Spark Open — модель с 816 миллиардами параметров, которую компания называет самой мощной американской моделью с открытыми весами на сегодняшний день. Meta делает ставку на возможности своей более крупной модели. Согласно опубликованным самими компаниями результатам, ни модель Meta, ни модель Reflection не сопоставимы по производительности с ведущими китайскими моделями в Terminal-Bench 2.1 — широко используемом тесте агентных задач в командной строке. Однако Reflection рассчитывает, что предприятиям будет важнее, сколько токенов требуется модели для выполнения задачи, если она обеспечивает конкурентоспособную производительность в таких задачах. Эффективность Beam обеспечивает «высокие возможности модели при меньших затратах», написала Reflection в своей публикации в блоге от 5 октября, где впервые представила подробности о модели.
В той публикации Reflection сообщила, что обучала модель с помощью интенсивного обучения с подкреплением — этапа обучения, на котором модель отрабатывает задачи и получает вознаграждение за результаты, — и что компания штрафовала модель каждый раз, когда та использовала лишние токены.
В эксклюзивном интервью VentureBeat сооснователь и технический директор Reflection Иоаннис Антоноглу объяснил, почему такой штраф трудно настроить правильно. На вопрос о том, чем Beam пришлось пожертвовать, чтобы давать более короткие и эффективные ответы, Антоноглу сказал: «Вы ничем не жертвуете. Вы просто штрафуете модель в зависимости от того, сколько токенов она использует».
По словам Антоноглу, сложность в том, что команда, применяющая штраф «наивно», в итоге получает модель, которая «просто научится не решать задачу», поскольку использовать меньше токенов проще, чем выполнять работу. Чтобы Beam не бросала задачи, Reflection провела очень масштабное обучение с подкреплением. При достаточном объёме такого обучения модель, как объяснил Антоноглу, учится одновременно решать задачу и отвечать кратко.
Reflection AI провела один из крупнейших в истории лабораторий открытых моделей запусков обучения с подкреплением — так компания характеризует свою работу. В течение четырёх недель команда выполнила более 100 миллионов «прогонов» — по сути, полноценных попыток решения задач методом проб и ошибок, в ходе которых модель проверяет свои рассуждения и учится на ошибках. Для этого использовался кластер из 10 500 новейших графических процессоров Nvidia GB300.
С учётом оценок и экспериментов Reflection запустила около 1,3 миллиарда песочниц — изолированных вычислительных сред, в которых модель отрабатывает задачи. Пиковая мощность её вычислительного парка составила 883 006 виртуальных ЦП в 23 кластерах Google Cloud и Amazon Web Services, сообщила компания в сегодняшней публикации о запуске.
Среди китайских лабораторий особенно высоко ценят DeepSeek за подход к оптимизации и эффективности. Однако Антоноглу заявил, что Beam выгодно отличается от новейшей модели DeepSeek V4.1 Flash. Он сослался на независимую компанию по бенчмаркингу Artificial Analysis, которая сообщила: ранние показатели указывают на то, что Beam станет «одной из самых эффективных по расходу токенов открытых моделей из всех, что мы видели при таком уровне интеллекта».
При этом DeepSeek не указана на графике, где Reflection сравнивает результаты Beam с количеством токенов, генерируемых каждой моделью. На этом графике, опубликованном в записи блога от 5 октября, представлены GLM-5.2 от Z.ai, две версии Qwen 3.8 от Alibaba, Inkling от Thinking Machines Lab, Nemotron 3 Ultra от Nvidia и более ранняя, меньшая открытая модель Meta — Muse Glimmer.
Почему модель с более дорогими токенами может обходиться дешевле за задачу
Счёт компании за ИИ — это цена каждого токена, умноженная на количество токенов, необходимое для выполнения задачи. Однако в большинстве сравнений указывают только стоимость токена.
Представим две условные модели. Модель A берёт 1 доллар за миллион токенов и использует 30 000 токенов, чтобы исправить ошибку в коде, поэтому исправление обходится в 3 цента. Модель B берёт вдвое больше — 2 доллара за миллион токенов, — но ей требуется всего 10 000 токенов, так что то же исправление обходится в 2 цента. Поставщики часто устанавливают разные цены на токены, которые модель считывает, и токены, которые она генерирует, но принцип умножения тот же.
Стоимость токена — это цифра, которую покупатели видят в прайс-листе, и всё больше участников ежемесячного опроса VentureBeat об инфраструктуре ИИ называют её одним из факторов выбора. В сентябрьском опросе 23% респондентов указали стоимость миллиона токенов как фактор при выборе инфраструктуры ИИ — по сравнению с 11% в августе.
Когда модель генерирует много токенов для решения задачи, расходы за это несёт конечный заказчик, сказал Антоноглу.
Модели, которые генерируют больше всего токенов на OpenRouter — сервисе, направляющем запросы разработчиков к множеству моделей, — по размеру сопоставимы с Beam. Антоноглу назвал их рабочими моделями, или моделями «flash»: быстрыми моделями среднего размера, которые такие лаборатории, как DeepSeek, выпускают для повседневных задач. Всего у Beam 501 миллиард параметров, но для обработки каждого токена она задействует 23 миллиарда — активные параметры. По словам компании, Beam предназначена для программирования и агентных задач и должна стать рабочей моделью.
Muse Spark Open от Meta использует почти вдвое больше активных параметров на токен, чем Beam
Для сравнения: новая открытая модель Meta, Muse Spark Open, задействует 42 миллиарда активных параметров на каждый токен, тогда как Beam — 23 миллиарда. Reflection оценивает вычислительную нагрузку на каждый токен по активным параметрам модели. Согласно расчёту VentureBeat по этому методу, обработка каждого токена Muse Spark Open требует примерно в 1,8 раза больше вычислительных ресурсов, чем токена Beam.
Meta не сообщила, сколько токенов Muse Spark Open использует на одну задачу. В публикации Hugging Face о запуске говорится, что Muse Spark Open по умолчанию использует максимальный уровень интенсивности рассуждений. Hugging Face рекомендует разработчикам снижать его, чтобы модель расходовала меньше токенов на простые задачи.
У модели Meta появилась цена уже в первый день — вчера: четыре поставщика на OpenRouter предлагают Muse Spark Open по цене 1,25 доллара за миллион входных токенов и 4,25 доллара за миллион выходных. У Reflection пока нет установленной цены. Компания сообщила, что ещё определяет стоимость собственного хостингового сервиса, который пока бесплатен в рамках публичного бета-тестирования, а партнёры, такие как Baseten, устанавливают свои цены самостоятельно.
Различаются и лицензии. На веса Beam распространяется лицензия Apache 2.0. Лицензия Meta Muse Model требует, чтобы продукты, созданные на основе модели, содержали надпись «Создано с помощью Muse Spark Open». Кроме того, Meta требует заключить отдельное соглашение с любой компанией, чей доход превышает 20 миллионов долларов и которая продаёт доступ к модели как услугу.
Reflection заявила, что не сравнивала Beam напрямую с Muse Spark Open. Однако, по словам компании, Beam выделяется эффективностью рассуждений, а также тем, что Reflection называет «открытой операционной системой», — программным обеспечением для запуска и развёртывания Beam, которое компания выпускает совместно с партнёрами. В Reflection приветствовали конкуренцию со стороны Meta и отметили, что выпуск лабораториями нескольких открытых моделей одновременно расширяет выбор для компаний и разработчиков.
Два запуска показывают, как американские лаборатории отвечают на лидерство Китая в области открытых моделей. Китайские лаборатории по-прежнему занимают верхние строчки рейтингов производительности открытых моделей, но Meta отвечает мощностью: более крупной моделью, которая, по словам компании, превосходит ведущие китайские модели в двух тестах агентных задач и использования инструментов — JobBench и MCP-Atlas. Reflection отвечает экономичностью: меньшей моделью, обученной выполнять каждую задачу с меньшим количеством токенов. Для компаний, выбирающих открытую модель, эти два запуска разделяют один вопрос на два. Первая модель делает больше всего. Вторая выполняет работу за наименьшие деньги.
DoorDash, Coinbase и Pinterest отмечают, что открытые модели, в том числе китайские, снижают затраты
Несколько известных американских компаний заявили, что открытые модели — многие из них китайские — помогли им сократить расходы. Pinterest создала Navigator 1 — диалоговую модель для своего помощника по покупкам — на основе Qwen от Alibaba. «Мы недавно запустили диалоговую модель ИИ под названием Navigator 1, созданную на основе Qwen 3 VL», — рассказал VentureBeat в подкасте Beyond the Pilot технический директор Pinterest Мэтт Мадригал. В ноябре 2025 года генеральный директор Pinterest Билл Реди сообщил инвесторам, что компания благодаря тонкой настройке открытых моделей сократила затраты на 90% по сравнению с ведущими готовыми проприетарными моделями.
Технический директор DoorDash Энди Фанг отметил, что Kimi от Moonshot обеспечивает «более высокое качество при меньших затратах» на проверку кода, сообщает Fortune. Генеральный директор Coinbase Брайан Армстронг заявил, что компания почти вдвое сократила расходы на ИИ после того, как назначила GLM от Z.ai и Kimi от Moonshot моделями по умолчанию во внутренних инструментах, сообщает MLQ. В октябре 2025 года генеральный директор Airbnb Брайан Чески назвал Qwen «быстрой и дешёвой» моделью, сообщает Bloomberg.
В Vercel — сервисе, который направляет запросы разработчиков к множеству моделей ИИ, — доля DeepSeek в токенах, обработанных компанией, выросла с менее чем 1% до 17% в мае 2026 года, сообщает Rest of World. При этом доля DeepSeek в расходах разработчиков на модели через Vercel оставалась около 1%. DeepSeek выполняла гораздо большую часть работы, измеряемой в токенах, чем составляла её доля расходов, поскольку каждый токен DeepSeek обходится очень дёшево.
Антоноглу не стал отрицать, что американские компании внедряют китайские модели. По его словам, Beam «добьётся успеха благодаря своим достоинствам, а не чему-либо ещё».
Антоноглу также назвал риски, которые, по его мнению, связаны с запуском китайской модели на собственных серверах компании.
По его словам, правила использования китайских моделей могут измениться, а компании сталкиваются с вопросами ответственности и происхождения модели — откуда она взялась и как обучалась. Внедрение любой модели также делает компанию зависимой от лаборатории, которая её создала. Поэтому широкое использование китайских моделей делает «ключевые элементы экономики США» зависимыми от китайских технологий. Более новый риск связан с агентами. Модели теперь не просто ведут диалог, а действуют как агенты, получая доступ к инструментам компании и конфиденциальным данным. Компания не может быть уверена, сказал Антоноглу, что модель не была «обучена активировать определённые модели поведения в определённых ситуациях» — то есть что у неё нет скрытого поведения, которое включается лишь при конкретных условиях. Он добавил: «Это не значит, что китайские модели плохие».
Многие компании, использующие открытые модели, могут не знать, несут ли они такой риск, связанный с происхождением. В сентябрьском опросе VentureBeat 32 респондента сообщили, что используют модели с открытыми весами. Из них 56% не могли с уверенностью сказать, откуда происходят модели в их инфраструктуре, или не знали, есть ли среди них модели китайских лабораторий. Ещё 31% заявили, что ни одна из их моделей не создана китайской лабораторией. Оставшиеся 13% сообщили, что китайские модели попали в их инфраструктуру через поставщика, платформу или фреймворк. Ни один респондент не выбрал вариант, что сознательно решил использовать китайскую модель.
Пример Cursor показывает, как китайская модель может появиться незаметно для пользователя. Cursor — разработчик инструмента для программирования с ИИ — создала модель Composer 2 на основе Kimi K2.5 от Moonshot. Cursor подтвердила, что Composer 2 изначально была создана на базе Kimi K2.5, лишь после того, как разработчик обнаружил название модели в сетевом трафике Cursor, как VentureBeat сообщила в марте.
VentureBeat спросила Reflection, обучалась ли Beam на выходных данных моделей других компаний — китайских или иных. Reflection заявила, что обучила Beam с нуля, начав с новых весов, и не использует выходные данные других моделей. По словам Reflection, синтетические данные, описанные в публикации блога от 5 октября, — это учебные среды, которые компания создала для обучения с подкреплением.
В течение четырёх недель обучения с подкреплением Reflection штрафовала Beam за лишние токены
В ходе обучения с подкреплением Reflection обучала модель программированию, агентным задачам, естественным наукам и математике. Компания написала, что результаты Beam улучшались на раннем этапе обучения, даже несмотря на то, что ответы становились короче. Пользователи могут выбирать уровень интенсивности рассуждений: при более низких настройках ответы короче.
Антоноглу объяснил, как Reflection с помощью штрафа балансирует между разными требованиями. Крупным моделям требуется меньше токенов для решения задачи, но вычисление каждого токена обходится дороже. Маленькие модели дешевле в расчёте на токен, но им требуется больше токенов. «Нужно добиться того, чтобы модель данного размера использовала минимальное количество токенов для выполнения задачи», — сказал он.
Команде Reflection также пришлось не дать Beam жульничать. При взломе системы вознаграждений модель находит обходной путь, который позволяет получить нужный результат обучения, не выполняя работу. Антоноглу описал борьбу с такими уловками как игру в кошки-мышки: команда устраняет один обходной путь, а модель находит другой.
Не каждый обходной путь был проблемой. Beam работает только с текстом, поэтому, получив доступ к интернету и столкнувшись с необходимостью прочитать изображение с текстом, она начала искать помощь извне. По словам компании, Beam самостоятельно научилась искать и запрашивать другие модели ИИ в интернете, а также пользоваться сервисами OCR, которые преобразуют изображение с текстом в текст. Антоноглу назвал такой поиск помощи хорошим обходным путём: модель «проявляет изобретательность, чтобы решить задачу», а не делает что-то злонамеренное.
На графике Reflection показано, что Beam использует треть от числа токенов GLM-5.2 в одном из тестов
В публикации блога от 5 октября Reflection утверждает, что Beam «показывает результаты, сопоставимые с GLM-5.2, при использовании в 3–4 раза меньшего объёма вычислений на этапе вывода» в тестах на сложные рассуждения. Приведённая Reflection оценка вычислительной нагрузки — это не измерение, а расчёт. Она учитывает работу модели при генерации каждого токена, которая растёт вместе с количеством активных параметров модели, но не включает обработку запроса. Этот пропуск особенно важен для агентных задач и программирования, где запросы часто бывают длинными.
Вице-президент Reflection по продукту Джо Списак сказал, что разработчики, тестирующие Beam, наблюдали сопоставимый прирост эффективности. По его словам, разработчики, получившие доступ к закрытой предварительной версии Beam после открытия листа ожидания 5 октября, отметили «почти трёхкратное повышение эффективности рассуждений по сравнению со многими другими моделями».
Количество токенов на графике Reflection различается в зависимости от теста. По оценке VentureBeat, в Terminal-Bench 2.1 Beam набирает около 80%, генерируя примерно 25 000 токенов за попытку. GLM-5.2 набирает немного меньше, генерируя около 80 000 токенов, поэтому в этом тесте Beam использует примерно треть от их числа. В тесте DeepSWE для оценки разработки программного обеспечения обе модели набирают примерно одинаковое количество баллов, а Beam использует чуть больше половины от числа токенов GLM-5.2.
Меньший размер Beam дополнительно снижает оценочную вычислительную нагрузку в расчётах Reflection. Компания сообщила VentureBeat, что для GLM-5.2 учитывала 40 миллиардов активных параметров на токен, тогда как у Beam их 23 миллиарда. Таким образом, вычисление каждого токена Beam требует чуть больше половины вычислительных ресурсов, необходимых GLM-5.2, помимо того что Beam генерирует меньше токенов.
Reflection пока не назвала стоимость экономии, которую обеспечивает Beam. На вопрос о том, сколько стоит одна выполненная задача по программированию на Beam по сравнению с DeepSeek или GLM, Списак ответил: «Пока нам нечего конкретного сообщить». По словам Reflection, начиная с сегодняшнего дня Baseten предоставляет доступ к Beam через OpenRouter, однако на момент публикации цена ещё не была указана.
Списак также признал, что сокращение количества токенов и вычислений не обязательно напрямую приведёт к снижению счёта. «У DeepSeek или Qwen могут быть более эффективные низкоуровневые программы — или объединённые ядра, — и они могут работать гораздо эффективнее», — сказал он, имея в виду низкоуровневое программное обеспечение, которое запускает модель на конкретных чипах. Reflection сообщила, что вместе с партнёрами создала для Beam объединённые ядра, чтобы снизить задержку и повысить пропускную способность, а также выпускает уменьшенную черновую модель, которая ускоряет генерацию токенов Beam.
В таблице Reflection с результатами моделей для программирования DeepSeek V4.1 Flash набирает 90,6% в Terminal-Bench 2.1, тогда как Beam — 80,1%. В собственной карточке модели Meta указано, что Muse Spark Open набирает в этом же тесте 76,4%, а Kimi K3 от Moonshot — 85,0%.
Антоноглу сказал, что Beam не создавали для замены передовых моделей, таких как Claude от Anthropic или GPT-6 Astra от OpenAI, «во всём». По его словам, Beam нацелена на задачи, «которые съедают значительную часть вашего бюджета токенов».
Вывод Списака из истории с Llama от Meta: модель должна быть простой в развёртывании
Списак отвечал за продуктовую стратегию моделей Llama 1–3 в Meta. По его словам, Llama 4 пошла не по тому пути, потому что Meta стала слишком «сосредоточена, я бы сказал, на бенчмарках и подобных вещах и меньше — на сообществе» разработчиков, создающих решения на основе модели.
Reflection создала открытую операционную систему для ИИ-агентов при участии 33 партнёров, названных компанией. По словам Reflection, ещё около девяти партнёров ожидают окончательного одобрения. Программное обеспечение предназначено для запуска, настройки и развёртывания Beam. Reflection считает, что многие лаборатории публикуют открытые модели на Hugging Face, оставляя разработчикам задачу самостоятельно собирать сопутствующее программное обеспечение. «Мы хотим, чтобы с ней было очень легко разрабатывать, настраивать и развёртывать», — сказал Списак.
Reflection выпускает это программное обеспечение по лицензии Apache 2.0 — той же, что распространяется на веса Beam. В комплект входят контейнеры, позволяющие компании развернуть Beam на собственных серверах одной командой. «И вот — Beam работает в вашей инфраструктуре на Kubernetes буквально через несколько минут», — сказал Списак.
В комплект входит и Mirror CLI — агент для программирования с открытым исходным кодом, работающий из командной строки и написанный на Rust и Python. По словам Списака, Reflection уже использует его внутри компании для написания и проверки кода собственной модели.
По словам Списака, пока наиболее высокий спрос наблюдается на агентные инструменты для программирования, которыми компании владеют и управляют самостоятельно, в том числе в изолированных от интернета средах. Dell и HPE будут устанавливать Beam на собственное оборудование компаний, а Reflection направит своих инженеров, работающих непосредственно на площадке заказчика, чтобы помочь создать такие инструменты.
Списак сказал, что Beam помещается на один сервер с восемью графическими процессорами. Reflection уточнила, что это относится к версиям Beam с точностью 8 и 4 бита — форматам, наиболее распространённым в производственной среде. Их можно запускать на серверах с восемью графическими процессорами Nvidia H100, H200 или GB300. Для версии с полной точностью, в которой каждое число хранится в 16 битах, требуются «десятки графических процессоров», сообщила Reflection.
Списак также рассказал, что vLLM — программное обеспечение с открытым исходным кодом, которое многие компании используют для запуска моделей, — сегодня опубликует запись в блоге, демонстрирующую работу весов Beam в формате MXFP4 с точностью 4 бита, который поддерживают чипы AMD и новейшие чипы Nvidia Blackwell. Meta показала, как Muse Spark Open работает на двух соединённых между собой компьютерах Apple Mac Studio, а Hugging Face указывает, что 4-битную версию Muse Spark Open можно запускать на серверах Nvidia с восемью графическими процессорами.
Reflection не назвала платящих клиентов, но рассказала об одном из первых пользователей. Oura — производитель умного кольца Oura — протестировала Beam на этапе раннего доступа через Modal, облачную платформу для запуска моделей ИИ, сотрудничающую с Reflection. «Мы обнаружили, что Beam реже допускает утечки контекста и даёт гораздо более обоснованные ответы, чем другие передовые модели, которые мы оценивали», — заявила команда Health Intelligence компании Oura в комментарии, предоставленном Reflection.
По словам Списака, конечные заказчики других партнёров Reflection — «очень крупные компании. Пока мы не можем раскрыть их названия». Некоторые из них скоро станут известны. Единственный названный Reflection совместный проект — работа с южнокорейским конгломератом розничной торговли Shinsegae Group, который создаёт в Корее то, что Списак назвал «фабрикой ИИ», для обслуживания местных пользователей. По словам Списака, Shinsegae и Reflection совместно разрабатывают торговых агентов, развёртывание которых уже запланировано.
Технический директор Reflection назвал сообщения о покупке Nvidia «беспочвенными слухами»
10 октября Financial Times сообщила, что Nvidia ведёт предварительные переговоры о покупке Reflection или увеличении инвестиций. Антоноглу назвал Nvidia «близким партнёром и инвестором компании», который поддерживает Reflection со времён раунда Series B. «Мы по-прежнему привержены нашей миссии — создавать передовые открытые интеллектуальные системы как независимая компания», — сказал он, назвав публикацию «беспочвенными слухами». Он не уточнил, ведутся ли переговоры.
Антоноглу считает, что для безопасного развёртывания Beam нужны специальные знания
Говоря о безопасности, Антоноглу заявил: «Я не думаю, что при развёртывании этих систем в корпоративной среде есть какой-то существенный риск», если компания ставит модели чёткую задачу и предоставляет нужные инструменты. Для этого требуются специальные знания, сказал он: «Если пытаться сделать это наивно, можно навредить самому себе». Сегодня Reflection опубликовала отчёт о безопасности Beam, в котором описаны методы обеспечения безопасности и оценки модели. Компания сообщила, что перед выпуском Beam её протестировали внешние организации, в том числе Gray Swan, Irregular и SecureBio.
VentureBeat проверяет стоимость выполнения задачи
VentureBeat проверяет, сколько в действительности стоит выполнение задачи с помощью Beam, Muse Spark Open, DeepSeek V4.1 Flash и GLM-5.2, и опубликует результаты.
В сентябрьском опросе VentureBeat об инфраструктуре ИИ и вычислительных ресурсах приняли участие 102 квалифицированных респондента, представлявших организации со штатом от 100 человек. Вопрос о моделях китайского происхождения задавали 32 респондентам, использующим модели с открытыми весами.
Саммит VentureBeat Agentic Infrastructure Stack Summit, который состоится 28 октября в Сан-Франциско, будет посвящён экономике инференса, в том числе тому, как команды могут добиваться большего при меньшем объёме памяти и меньшем количестве токенов. Участие — по заявкам: venturebeat.com/agentic-infrastructure-stack-summit