


Передовые модели ИИ портят 25% содержимого документов


По мере того как большие языковые модели становятся все более способными, у пользователей возникает соблазн перекладывать на них задачи, связанные с обработкой знаний, когда модели работают с документами от имени пользователя и выдают готовый результат. Но насколько можно доверять модели в том, что она останется верной содержанию ваших документов, когда ей приходится работать с ними в течение нескольких циклов?
Новое исследование, проведенное учеными из Microsoft, показывает, что большие языковые модели незаметно портят документы, с которыми работают, допуская ошибки. Исследователи разработали бенчмарк, который симулирует многоэтапные автономные рабочие процессы в 52 профессиональных областях, используя метод, автоматически измеряющий степень деградации контента с течением времени.
Полученные ими данные показывают, что даже лучшие передовые модели портят в среднем 25% содержимого документов к концу таких рабочих процессов. А предоставление моделям агентских инструментов или реалистичных отвлекающих документов (дистракторов) на самом деле ухудшает их производительность.
Это служит предупреждением о том, что, несмотря на растущее стремление к автоматизации интеллектуального труда, современные языковые модели пока не до конца надежны для выполнения подобных задач.
Механика делегированной работы
Исследование Microsoft сосредоточено на «делегированной работе» — зарождающейся парадигме, в рамках которой пользователи позволяют языковым моделям выполнять задачи по работе с данными от их имени, анализируя и изменяя документы.
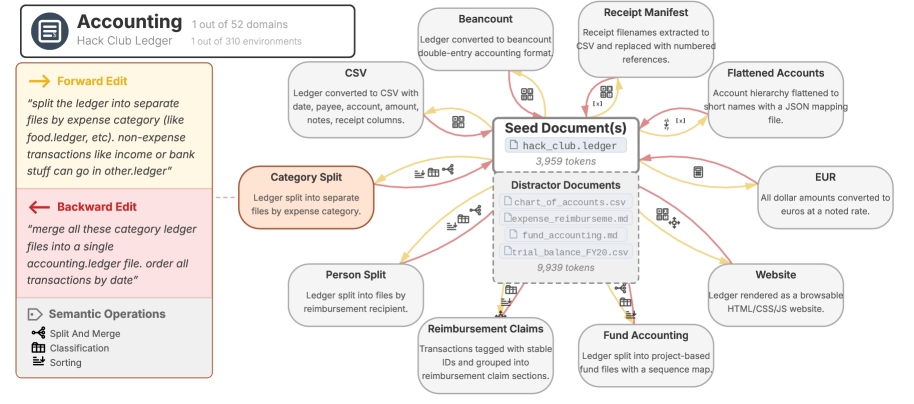
Ярким примером этой парадигмы является вайб-кодинг (vibe coding), когда пользователь делегирует разработку ПО и редактирование кода искусственному интеллекту. Но делегированные рабочие процессы выходят далеко за рамки программирования и охватывают другие сферы. Например, в бухгалтерии пользователь может предоставить плотную книгу учета и поручить модели разделить документ на отдельные файлы, организованные по конкретным категориям расходов.
Поскольку у пользователей может не хватать времени или специальной квалификации для ручной проверки каждой модификации, внедряемой ИИ, делегирование часто держится на доверии. Пользователи ожидают, что модель добросовестно выполнит задачи, не допуская неконтролируемых ошибок, несанкционированных удалений или галлюцинаций в документах.
Чтобы оценить, насколько можно доверять системам ИИ в расширенных, итеративных делегированных рабочих процессах, исследователи разработали бенчмарк DELEGATE-52. Он состоит из 310 рабочих сред, охватывающих 52 различные профессиональные области, включая финансовый учет, разработку программного обеспечения, кристаллографию и музыкальную нотацию.
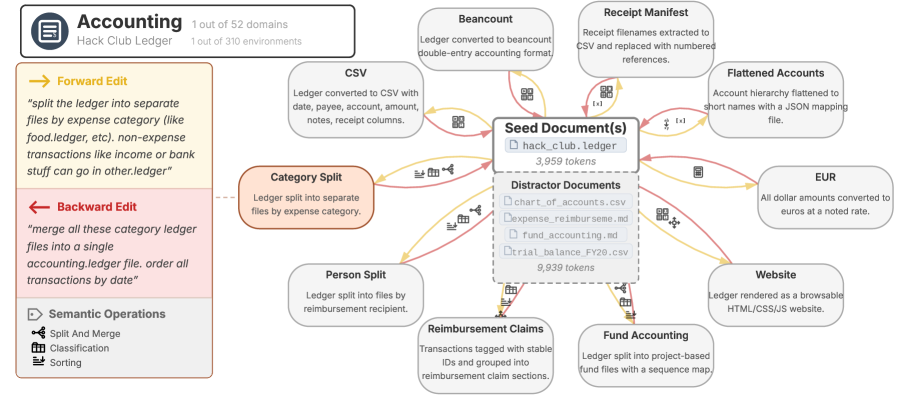
Пример задачи из DELEGATE-52 (источник: arXiv)
Каждая рабочая среда опирается на реальные исходные текстовые документы объемом от 2000 до 5000 токенов. Помимо исходного документа, среды включают от пяти до десяти сложных задач редактирования.
Оценка сложного многоэтапного процесса редактирования обычно требует дорогостоящей проверки человеком. DELEGATE-52 обходит это ограничение с помощью метода симуляции «туда и обратно» (round-trip relay), который оценивает ответы без необходимости привлечения размеченных человеком эталонных решений. Этот подход вдохновлен методом обратного перевода, используемым при оценке машинного перевода, когда модели ИИ дают указание перевести документ с одного языка на другой и обратно, чтобы проверить, насколько идеально она воспроизводит оригинал.
Соответственно, каждая задача редактирования в DELEGATE-52 спроектирована так, чтобы быть полностью обратимой: прямая инструкция сочетается с ее точным инверзом. Например, инструкция разделить бухгалтерскую книгу на отдельные файлы по категориям расходов дополняется инструкцией объединить все файловые категории обратно в единый реестр.
В комментариях для VentureBeat Филипп Лабан (Philippe Laban), старший научный сотрудник Microsoft Research и соавтор работы, уточнил, что это не просто проверка того, может ли ИИ нажать кнопку «отменить». Поскольку живых работников нельзя заставить мгновенно «забыть» только что выполненную задачу, такая двусторонняя оценка уникально подходит именно для ИИ. Запуская новую сессию диалога, исследователи заставляют модель попытаться выполнить обратную задачу совершенно независимо.
Модели в их экспериментах «не знают, является ли задача шагом вперед или назад, и не осведомлены об общем дизайне эксперимента», пояснил Лабан. «Они просто стараются выполнить каждую задачу как можно тщательнее на каждом этапе».
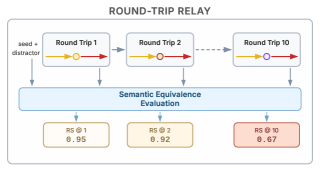
Пример двусторонней задачи-эстафеты (источник: arXiv)
Эти двусторонние задачи объединяются в непрерывную эстафету для имитации долгосрочных рабочих процессов, охватывающих 20 последовательных взаимодействий. Чтобы сделать среду более реалистичной, бенчмарк добавляет в контекст каждой задачи файлы-дистракторы (отвлекающие факторы). Они содержат от 8000 до 12000 токенов тематически связанных, но абсолютно нерелевантных документов. Дистракторы позволяют проверить, способна ли ИИ сохранять концентрацию или же она путается и привлекает неверные данные.
Тестирование передовых моделей в эстафете
Чтобы понять, как различные архитектуры и масштабы справляются с делегированной работой, исследователи протестировали 19 различных языковых моделей от OpenAI, Anthropic, Google, Mistral, xAI и Moonshot. В ходе основного эксперимента эти модели были подвергнуты симуляции 20 последовательных взаимодействий по редактированию.
Во всех моделях документы к концу симуляции пострадали в среднем на 50%. Даже лучшие передовые модели в эксперименте, а именно Gemini 3.1 Pro, Claude 4.6 Opus и GPT 5.4, испортили в среднем 25% содержимого документов.
Из 52 профессиональных областей Python оказался единственной сферой, где большинство моделей достигли статуса готовности с результатом 98% или выше. Модели преуспевают в программных задачах, но испытывают серьезные трудности в естественном языке и нишевых областях, таких как художественная литература, финансовые отчеты или рецепты. Главный победитель среди моделей, Gemini 3.1 Pro, был признан готовым к делегированной работе лишь в 11 из 52 областей.
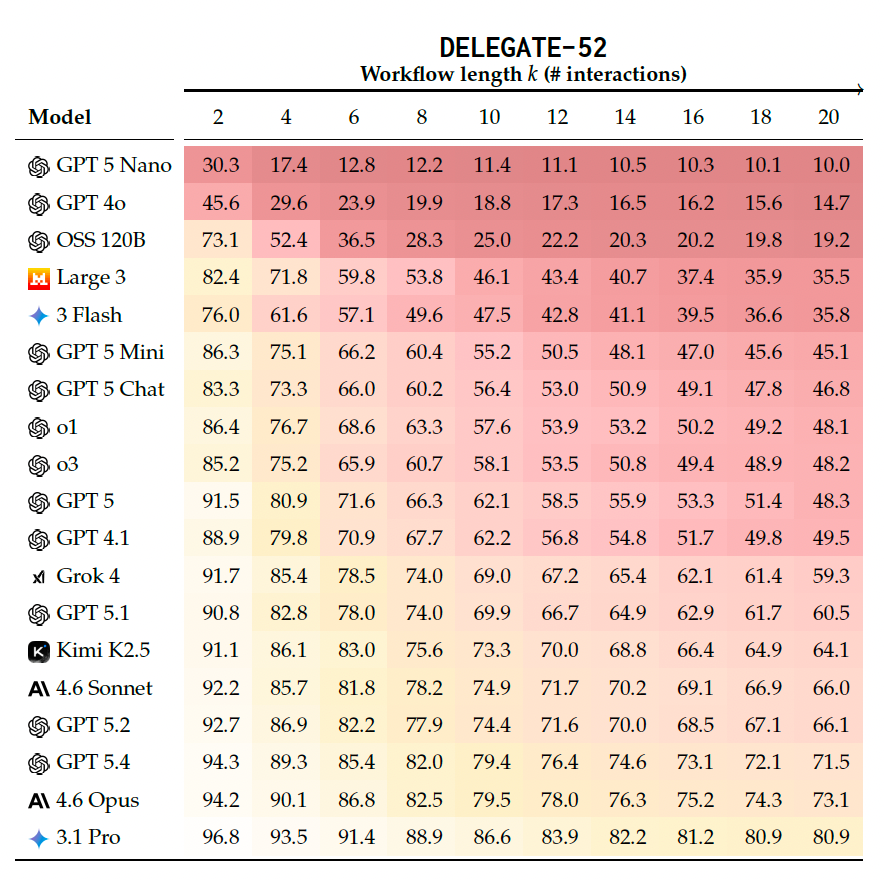
Все модели испытывают трудности с задачами делегирования (источник: arXiv)
Интересно, что порча данных была вызвана не «смертью от тысячи порезов», когда модели постепенно накапливают мелкие ошибки. Напротив, около 80% общей деградации приходится на редкие, но массивные критические сбои — отдельные взаимодействия, в ходе которых модель внезапно теряет по меньшей мере 10% содержимого документа. Передовые модели не обязательно лучше избегают мелких ошибок. Они просто откладывают эти катастрофические сбои на более поздние раунды.
Другое важное наблюдение заключается в том, что при сбоях у более слабых моделей деградация проистекает в основном из удаления контента. Однако когда дают сбой передовые модели, они активно портят существующий контент. Текст остается на месте, но он тонко искажен или сгенерирован в виде галлюцинации, из-за чего человеку-контролеру гораздо труднее обнаружить ошибку.
Любопытно, что наделение моделей агентской обвязкой (harness) с универсальными инструментами для выполнения кода и доступа к чтению/записи файлов на самом деле ухудшило их производительность, добавив в среднем еще 6% деградации. Лабан пояснил, что проблема заключается в опоре на универсальные инструменты, а не на специализированные для конкретной предметной области.
«У моделей нет возможности «на лету» писать эффективные программы, которые могли бы манипулировать файлами в различных сферах без ошибок», — отметил он. «Когда они не могут сделать что-то программным путем, они прибегают к чтению и перезаписи целых файлов, что менее эффективно и более подвержено ошибкам». Решением для разработчиков является создание четко ограниченных по области применения инструментов (таких как специфические функции для расчета или перемещения записей внутри файлов .ledger), чтобы агенты не сбивались с пути.
Деградация также лавинообразно нарастает по мере увеличения документов или добавления в рабочее пространство большего количества отвлекающих файлов. Для корпоративных команд, активно инвестирующих в генерацию с дополненной выборкой (RAG), эти отвлекающие документы служат прямым предупреждением о кумулятивной стоимости загроможденного контекста. Если зашумленное контекстное окно может вызвать минимальное падение производительности на 1% всего после двух взаимодействий, то в ходе длительной симуляции эта деградация накапливается до колоссального падения на 2–8%.
«Для сообщества разработчиков систем поиска: конвейеры RAG следует оценивать на основе многоэтапных рабочих процессов, а не только одноразовых поисковых бенчмарков», — сказал Лабан. «Одноразовые измерения систематически недооценивают вред неточного поиска».
Проверка реальностью для автономного предприятия
Результаты бенчмарка DELEGATE-52 представляют собой критическую проверку реальностью для нынешней шумихи вокруг полностью автономных агентов ИИ.
Дизайн бенчмарка также подразумевает практическое ограничение: поскольку модели могут поддерживать чистоту записей в течение нескольких шагов перед внезапным катастрофическим сбоем, необходима пошаговая проверка человеком, а не единовременная финальная ревизия. Лабан рекомендует создавать приложения на базе ИИ вокруг коротких, прозрачных задач, а не сложных долгосрочных агентов.
Для организаций, желающих безопасно развернуть автономных агентов уже сегодня, методология DELEGATE-52 предоставляет практический план тестирования внутренних конвейеров данных. Лабан пояснил, что «… корпоративной команде, желающей принять эту структуру, необходимо создать три компонента: (a) набор обратимых задач редактирования, репрезентативных для их рабочих процессов; (б) парсер, который преобразует их доменные документы в структурированное представление; и (в) функцию сходства, которая сравнивает два распарсенных представления». Командам даже не нужно писать парсеры с нуля. Исследовательская группа Microsoft успешно перепрофилировала существующие библиотеки парсинга для 30 из 52 протестированных областей.
Лабан с оптимизмом смотрит на темпы улучшений. «Прогресс реален и идет быстро. Если посмотреть только на семейство GPT, модели за 18 месяцев поднялись с результатов ниже 20% примерно до 70%», — говорит Лабан. «Если такая траектория сохранится, модели вскоре смогут достичь максимальных баллов в DELEGATE-52».
Тем не менее Лабан предостерег, что DELEGATE-52 намеренно невелик по сравнению с массивными корпоративными средами. Даже когда базовые модели неизбежно освоят этот бенчмарк, бесконечный длинный хвост уникальных корпоративных данных и рабочих процессов означает, что организациям всегда придется инвестировать в собственные специализированные инструменты, чтобы поддерживать надежность своих автономных агентов.




