


Фреймворк памяти ИИ MeMo обходится без дообучения LLM


Обеспечение возможности для больших языковых моделей (LLM) усваивать новые знания после обучения остается серьезным препятствием для корпоративного ИИ: текущие решения либо слишком дороги, либо слишком медленны, либо ограничены размером контекстного окна.
MeMo — фреймворк, разработанный исследователями из нескольких университетов, который кодирует новые знания в специализированную модель памяти меньшего размера, функционирующую отдельно от основной LLM.
Модульная архитектура работает как с моделями с открытым, так и с закрытым исходным кодом, а также позволяет избежать сложности конвейеров RAG и полного переобучения модели.
Эксперименты показывают, что MeMo надежно обрабатывает сложные запросы даже в условиях зашумленных поисковых конвейеров. Он позволяет избежать катастрофического забывания, связанного с прямой доработкой (fine-tuning), и представляет собой экономически эффективный путь для непрерывного обновления знаний.
Проблема обновления памяти LLM
Большие языковые модели «замораживаются» после завершения обучения, и их внутренние знания остаются статичными до тех пор, пока они не пройдут последующие, чрезвычайно ресурсоемкие обновления.
Сравнение различных фреймворков памяти LLM (источник: arXiv)
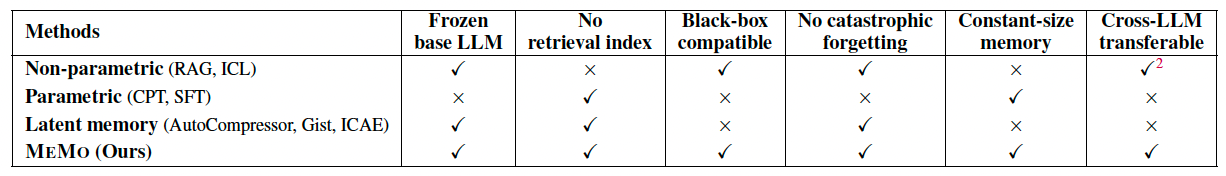
В настоящее время разработчики полагаются на три основных подхода к интеграции внешних знаний в LLM, каждый из которых имеет свои существенные недостатки:
Непараметрические методы, такие как генерация с дополнением извлечением (RAG) и контекстное обучение (in-context learning), извлекают релевантные документы из внешней базы данных и вставляют их непосредственно в промпт модели. Несмотря на свою популярность, эти методы ограничены размером контекстного окна.
Как рассказал VentureBeat Армандо Солар-Лесама (Armando Solar-Lezama), соавтор научной работы: «Перед векторными базами данных стоит фундаментально сложная задача: закодировать всю семантику фрагмента текста в единый вектор, а затем сопоставить этот вектор с запросом, даже если релевантность фрагмента… может быть очевидна только в контексте других фрагментов».
Исследователи отмечают, что семантическая схожесть эмбеддингов часто не соответствует тому, что на самом деле требуется в запросе пользователя. Обработка тысяч извлеченных токенов также создает значительные вычислительные затраты и задержку инференса. Самое главное, что системы RAG крайне чувствительны к шуму. Неактуальные или плохо извлеченные фрагменты часто ухудшают итоговый ответ модели.
Параметрические методы, такие как непрерывное предварительное обучение или дообучение с учителем, пытаются внедрить новые знания непосредственно в веса LLM. Обновление современных массивных LLM стоит непомерно дорого и, как правило, невозможно для проприетарных моделей с закрытым исходным кодом, скрытых за API. Дообучение также подвержено риску катастрофического забывания. Принудительная адаптация модели к новым корпоративным данным часто разрушает ее ранее приобретенные способности к рассуждению и защитные механизмы.
Методы латентной памяти, такие как сжатие контекста, представляют собой компромиссный вариант. Они сжимают знания в компактные «мягкие токены» (soft tokens) или представления, которые добавляются в контекст модели во время инференса. Фатальным недостатком здесь является «связывание представлений» (representation coupling). Сжатая память строго привязана к архитектуре модели, которая ее создала; вы не можете перенести латентную память, обученную на модели с открытым исходным кодом, на модель с закрытым кодом.
Как работает MeMo
Фреймворк MeMo (Memory as a Model) представляет модульную архитектуру, состоящую из двух отдельных компонентов. Модель MEMORY — это небольшая языковая модель, обученная специально для кодирования новых знаний в своих параметрах. Модель EXECUTIVE — это замороженная готовая LLM, которая выполняет роль механизма рассуждения. Когда пользователь задает вопрос, модель EXECUTIVE рассматривает модель MEMORY как внешний оракул, отправляя целенаправленные подзапросы для сбора фактов и синтезируя их в окончательный ответ.
В основе принципа проектирования MeMo лежит концепция «рефлексий» (reflections). Рефлексии представляют собой целевые пары «вопрос-ответ» (QA), созданные для охвата каждого возможного аспекта массива знаний. Вместо того чтобы заставлять ИИ обрабатывать огромный неструктурированный массив документов во время обучения, MeMo использует модель GENERATOR для извлечения из сырого текста тысяч целевых пар QA. Затем модель MEMORY дообучается на этом наборе данных, чтобы отвечать на вопросы, используя исключительно свои параметрические знания без необходимости читать извлеченный контекст.
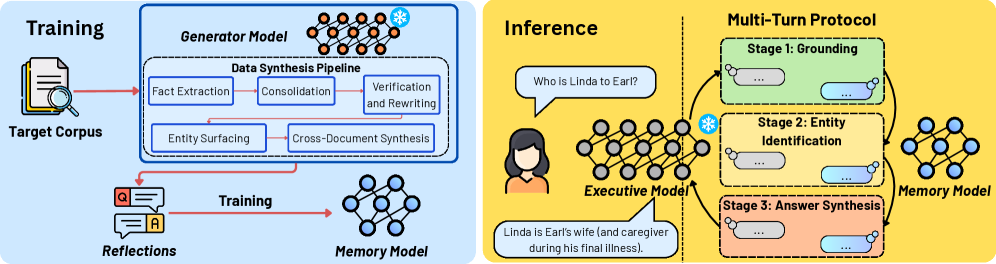
Фреймворк MeMo (источник: arXiv)
На этапе инференса взаимодействие между двумя моделями подчиняется структурированному трехэтапному протоколу:
1. Модель EXECUTIVE декомпозирует сложный запрос пользователя на набор атомарных подзапросов. Модель MEMORY независимо отвечает на каждый из них для установления базовых фактов.
2. Используя эти начальные подсказки, модель EXECUTIVE отправляет повторные запросы для сужения круга возможных сущностей, пока не придет к уверенному результату.
3. Наконец, модель EXECUTIVE запрашивает у модели MEMORY подтверждающие факты о целевой сущности и синтезирует извлеченные фрагменты в связный ответ.
Эта архитектура объединяет сильные стороны трех существующих парадигм памяти ИИ, обходя при этом их подводные камни. Она использует готовые передовые модели, разделяя хранилище памяти и механизм рассуждений, что гарантирует совместимость как с моделями с открытыми весами, так и с закрытыми API. Она внедряет знания непосредственно в параметры, но изолирует обновления в меньшей специализированной модели MEMORY для защиты механизма рассуждений. Наконец, она создает запрашиваемый артефакт памяти, который не привязан к какой-либо конкретной модели и может использоваться с различными семействами LLM.
Обработка непрерывных обновлений знаний
Управление памятью ИИ требует постоянных обновлений по мере изменения корпоративных политик и публикации новых отчетов. Как правило, обновление параметров модели требует ее повторного обучения с нуля на комбинации старых и новых данных. По мере роста базы знаний стоимость такого кумулятивного переобучения становится непосильной.
Для эффективной обработки непрерывных обновлений MeMo полагается на метод, называемый «слиянием моделей» (model merging). Вместо масштабной фазы совместного переобучения MeMo обучает новую независимую модель MEMORY исключительно на вновь добавленных документах. Система формирует «вектор задачи», отражающий изменения параметров, изученные на свежих данных. Затем эти обновления математически объединяются с весами исходной модели MEMORY.
Этот подход сокращает количество вычислительных часов, необходимых для поддержания системы в актуальном состоянии, и в то же время позволяет избежать интерференции, вызывающей катастрофическое забывание.
За эту эффективность приходится платить: слияние моделей приводит к снижению точности на 11–19% по сравнению с полным переобучением, в зависимости от используемой модели рассуждений.
MeMo в действии
Чтобы оценить эффективность в реальных условиях, исследовательская группа сравнила MeMo с несколькими отраслевыми бенчмарками, требующими сложных многошаговых рассуждений по множеству документов.
Исследователи использовали Qwen2.5-32B-Instruct в качестве модели GENERATOR для извлечения рефлексий из исходного текста. В качестве основной модели MEMORY они задействовали Qwen2.5-14B-Instruct. Они также проверили этот подход на более мелких моделях с 1–2 млрд параметров на базе различных архитектур, включая Gemma3-1B.
В качестве модели рассуждений EXECUTIVE тестировались как модель с открытыми весами Qwen2.5-32B, так и проприетарная Gemini 3 Flash от Google.
MeMo сопоставлялся с верхней границей «идеального извлечения» (когда точные правильные документы предоставляются вручную) и несколькими передовыми поисковыми системами, включая традиционный поиск BM25, плотный векторный поиск и современный граф-ориентированный RAG (HippoRAG2). Они также протестировали «Cartridges» — недавний метод, который загружает обученный кэш KV в модель во время инференса.
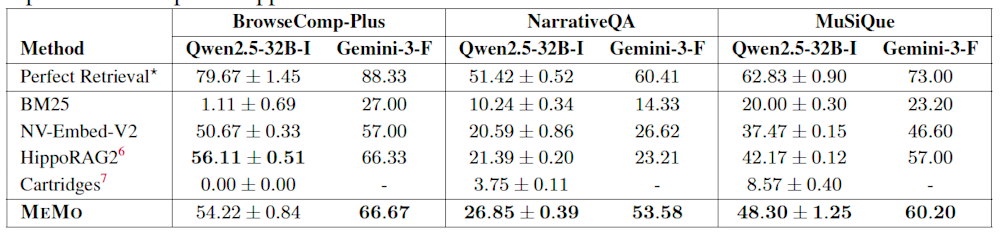
Производительность MeMo на отраслевых бенчмарках по сравнению с другими базовыми моделями (источник: arXiv)
MeMo продемонстрировал явное превосходство в рассуждениях по длинным документам. Согласно данным исследователей, в бенчмарке NarrativeQA модель MeMo в паре с Gemini 3 Flash достигла точности 53,58%. Максимальный результат HippoRAG2 составил 23,21%.
Корпоративным системам часто требуется синтезировать сложные ответы — например, сопоставлять перекрывающиеся нормативные акты, независимо составленные различными ведомствами, или объединять аналитические данные из огромной кодовой базы и внешней документации. Традиционные системы RAG буксуют в таких сценариях, поскольку они упираются в ограничения контекстного окна и не могут связать концепции, разбросанные по сотням страниц. MeMo добивается успеха благодаря тому, что эти связи сопоставляются и усваиваются внутри модели MEMORY во время обучения. По словам Солар-Лезамы, это «все равно что иметь собственного Малкольма Гладуэлла, который может связать историю The Beatles с историей Билла Гейтса, чтобы высказать аргумент о природе экспертных знаний».
Эксперименты выявили еще одно важное преимущество: обновление механизма рассуждений требует нулевого переобучения. Простая замена модели EXECUTIVE с открытым исходным кодом Qwen на проприетарную Gemini 3 Flash повысила производительность MeMo на 26,73% в бенчмарке NarrativeQA и на 11,90% в MuSiQue. Для практиков это означает, что можно безопасно обучить модель MEMORY на своих частных данных и мгновенно подключить ее к новейшим коммерческим API, непрерывно повышая интеллект системы без дополнительных затрат на обучение.
Исследовательская группа отметила, что интеграция не требует дополнительной настройки: «Базовую (или Executive) LLM, которую команды уже используют в RAG, можно настроить на отправку запросов непосредственно к модели памяти. Эти запросы выполняются на естественном языке, аналогично отправке сообщения в API, и никакой дополнительной настройки не требуется».
MeMo также исключительно хорошо справляется с зашумленными данными. Когда исследователи намеренно наводнили набор данных нерелевантными документами (в объеме, вдвое превышающем полезную информацию), производительность HippoRAG2 упала на 11,55%. Производительность MeMo осталась относительно стабильной, снизившись менее чем на 2%. Корпоративные базы знаний обычно несовершенны, они заполнены дубликатами документов и устаревшими регламентами. Стандартные системы RAG с трудом справляются с этим шумом, подтягивая в промпт неверные абзацы и вызывая галлюцинации. Поскольку модель EXECUTIVE в MeMo взаимодействует с синтезированным оракулом, а не с сырыми фрагментами документов, она сохраняет высокую устойчивость к неорганизованным корпоративным данным.
Ограничения и компромиссы
Инженерным командам, планирующим развертывание MeMo, следует учитывать несколько ключевых ограничений.
В отличие от традиционных систем RAG, которые быстро индексируют сырые документы в векторную базу данных, MeMo требует предварительных затрат на обучение для каждого нового корпуса. Конвейер генерации данных, используемый для синтеза обучающих рефлексий, вычислительно дорог. Например, команда отметила, что «генерация полного набора данных QA для рефлексий заняла примерно 240 графических часов (GPU-hours) на чипах NVIDIA H200», в то время как обучение модели MEMORY с 14 млрд параметров «потребовало примерно 180 графических часов H200». Как отметил Солар-Лесама, «снижение затрат на обучение — одна из важнейших нерешенных исследовательских задач, позволяющая сделать этот метод рабочим инструментом».
Поскольку модель MEMORY представляет собой нейронную сеть фиксированного размера, ее способность усваивать знания ограничена емкостью ее представлений. Хотя исследователи не столкнулись с жестким лимитом во время бенчмаркинга, они предполагают, что «достаточно крупные или насыщенные информацией корпусы превысят объем того, что модель MEMORY фиксированного размера способна корректно сжать и представить».
Наконец, поскольку MeMo синтезирует ответы из параметрической памяти, а не извлекает точные фрагменты текста, он скрывает происхождение информации. Это затрудняет привязку конкретных утверждений к исходным документам, что создает серьезную проблему соответствия требованиям (комплаенса) для корпоративных приложений, требующих строгого аудита.
Выбор между MeMo и традиционным RAG сводится к эвристике «поиск (lookup) против синтеза» в сочетании с изменчивостью данных. Исследователи советуют: «Традиционный RAG предпочтителен, когда ответы содержатся в одном документе или когда есть четко определенный источник… MeMo предпочтителен, когда задача смещается от поиска к синтезу ответа на основе информации, разбросанной по множеству фрагментов». Если ваш корпус знаний быстро меняется (например, ежедневные ленты) и вам требуются точные цитаты источников, RAG остается лучшим выбором из-за затрат на предварительное обучение MeMo. Если ваш корпус состоит из обобщенных предметных знаний, которые эволюционируют медленно по сравнению с их объемом, MeMo предлагает значительно превосходящие возможности рассуждения. Команды также могут внедрить гибридную архитектуру маршрутизации в продакшене: отправлять запросы на поиск в стандартную векторную базу данных, а запросы на синтез — в модель MEMORY.
«Заглядывая в будущее, я ожидаю, что модели памяти станут стандартным архитектурным компонентом наряду с поиском», — рассказала VentureBeat Даниэла Рус (Daniela Rus), соавтор научной работы и директор Лаборатории искусственного интеллекта и компьютерных наук MIT (CSAIL), — «точно так же, как кэширование и индексация являются стандартными компонентами любой серьезной системы данных сегодня».




