


OpenAI повышает уровень интерпретируемости моделей ИИ
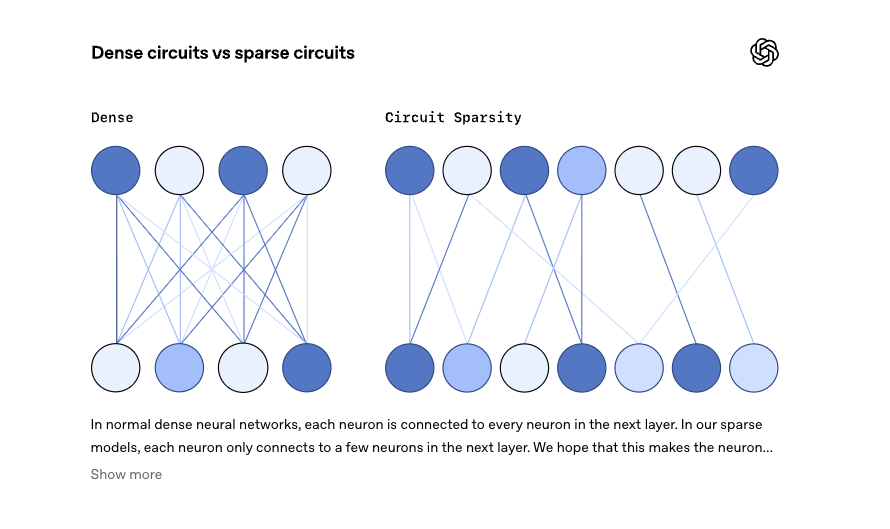


OpenAI исследователи экспериментируют с новым подходом к проектированию нейронных сетей, стремясь сделать ИИ-модели более простыми для понимания, отладки и управления. Разреженные модели могут предоставить предприятиям лучшее понимание того, как эти модели принимают решения.
Понимание того, как модели выбирают варианты ответов — ключевое преимущество рассуждающих моделей для бизнеса, — способно обеспечить необходимый уровень доверия для организаций, когда они обращаются к ИИ-моделям за аналитикой.
Метод потребовал от ученых и исследователей OpenAI изучать и оценивать модели не путем анализа производительности после обучения, а за счет внедрения интерпретируемости или понимания с помощью разреженных схем.
В OpenAI отмечают, что непрозрачность ИИ-моделей во многом проистекает из того, как большинство из них спроектировано, поэтому для лучшего понимания поведения моделей им приходится создавать обходные пути.
«Нейронные сети лежат в основе самых мощных современных систем искусственного интеллекта, но их по-прежнему сложно понять, — написали в блоге OpenAI. — Мы не пишем для этих моделей явные пошаговые инструкции. Вместо этого они учатся, настраивая миллиарды внутренних соединений или весов, пока не освоят задачу. Мы задаем правила обучения, но не конкретное возникающее поведение, и в результате получается плотная паутина связей, которую не может легко расшифровать ни один человек».
Чтобы повысить интерпретируемость комбинации, в OpenAI изучили архитектуру, которая обучает непересекающиеся нейронные сети, делая их более простыми для понимания. Команда обучила языковые модели с архитектурой, аналогичной существующим моделям, таким как GPT-2, используя ту же схему обучения.
Результат: улучшенная интерпретируемость.
Путь к интерпретируемости
Понимание того, как работают модели, и получение представления о том, как они делают свои выводы, важны, поскольку это оказывает реальное влияние на мир, заявляют в OpenAI.
Компания определяет интерпретируемость как «методы, которые помогают нам понять, почему модель выдала тот или иной результат». Существует несколько способов достижения интерпретируемости: пошаговая интерпретируемость (chain-of-thought), которую часто используют рассуждающие модели, и механистическая интерпретируемость, которая предполагает обратное проектирование математической структуры модели.
OpenAI сосредоточилась на улучшении механистической интерпретируемости, которая, по ее словам, «до сих пор была менее непосредственно полезной, но в принципе могла бы предложить более полное объяснение поведения модели».
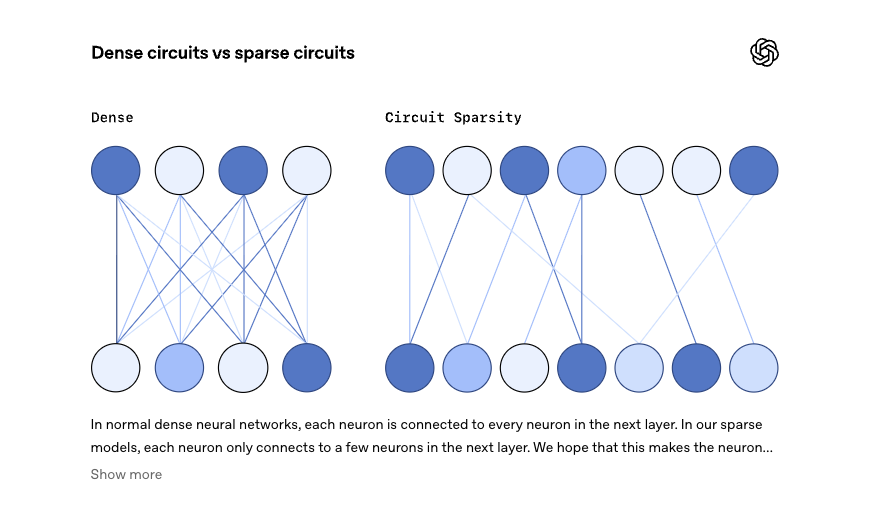
Источник: OpenAI
«Стремясь объяснить поведение модели на самом детальном уровне, механистическая интерпретируемость может делать меньше допущений и давать нам больше уверенности. Но путь от низкоуровневых деталей к объяснению сложного поведения гораздо длиннее и сложнее», — считают в OpenAI.
Более высокая интерпретируемость позволяет осуществлять лучший контроль и дает ранние предупреждающие знаки, если поведение модели перестает соответствовать правилам.
В OpenAI отметили, что улучшение механистической интерпретируемости — «это очень амбициозная ставка», но исследования в области разреженных сетей улучсили эту ситуацию.
Как распутать модель
Чтобы распутать клубок связей, создаваемых моделью, в OpenAI сначала удалили большинство из них. Поскольку такие трансформерные модели, как GPT-2, имеют тысячи связей, команде пришлось «обнулить» эти схемы. Каждая из них теперь взаимодействует лишь с ограниченным числом элементов, благодаря чему соединения становятся более упорядоченными.
Затем команда запустила «трассировку схем» для задач по созданию групп интерпретируемых схем. Последняя задача заключалась в усечении модели (прунинге), «чтобы получить наименьшую схему, которая достигает целевой потери на целевом распределении», согласно данным OpenAI. Целевой показатель потерь был установлен на уровне 0,15, чтобы изолировать точные узлы и веса, отвечающие за определенное поведение.
«Мы показываем, что прунинг наших моделей с разреженными весами дает примерно в 16 раз меньшие схемы для наших задач, чем прунинг плотных моделей с сопоставимыми потерями при предварительном обучении. Мы также можем создавать произвольно точные схемы ценой увеличения количества ребер. Это показывает, что схемы для простого поведения существенно более распутаны и локализуемы в моделях с разреженными весами по сравнению с плотными моделями», — говорится в отчете.
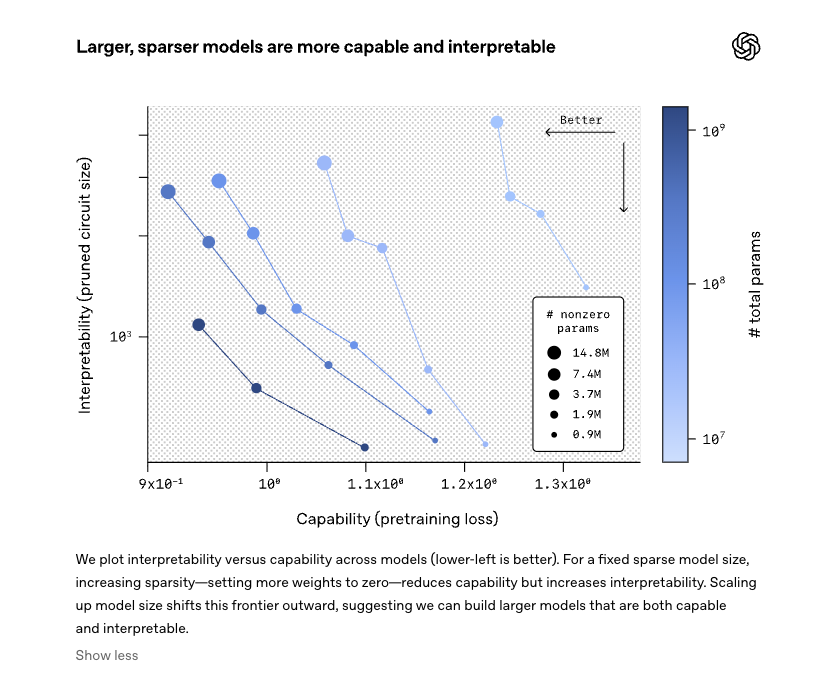
Источник: OpenAI
Маленькие модели становится проще обучать
Хотя OpenAI удалось создать разреженные модели, которые легче понять, они остаются значительно меньше большинства базовых моделей, используемых бизнесом. Компании все чаще используют небольшие модели, однако самые передовые системы, такие как их флагманская GPT-5.1, в будущем все равно выиграют от улучшения интерпретируемости.
Другие разработчики моделей также стремятся понять, как думают их ИИ-модели. Компания Anthropic, которая уже некоторое время занимается исследованиями в области интерпретируемости, недавно объявила, что «взломала» мозг Клода (Claude) — и Клод это заметил. Meta также работает над тем, чтобы выяснить, как модели рассуждений принимают свои решения.
Поскольку все больше предприятий обращаются к ИИ-моделям за помощью в принятии важных решений для своего бизнеса, а в перспективе и для клиентов, исследования в области понимания того, как думают модели, обеспечат ту ясность, которая необходима многим организациям для большего доверия к системам искусственного интеллекта.




