


Мочевые языковые модели способны мыслить, утверждает инженер Talentica


В последнее время много шумихи вызывает идея о том, что большие модели рассуждений (LRM) не способны мыслить. В основном это связано с исследовательской статьей, опубликованной Apple, — «Иллюзия мышления». В Apple утверждают, что LRM не могут мыслить; вместо этого они просто выполняют сопоставление с образцом. Доказательством служит то, что LRM с рассуждениями по цепочке рассуждений (CoT) не справляются с вычислениями по предопределенному алгоритму по мере роста сложности задачи.
Это в корне ошибочный аргумент. Если вы попросите человека, который уже знает алгоритм решения задачи о Ханойской башне, решить ее, например, с двадцатью дисками, он или она почти наверняка потерпят неудачу. Следуя этой логике, мы должны прийти к выводу, что люди тоже не умеют думать. Однако этот аргумент лишь указывает на то, что нет доказательств неспособности LRM мыслить. Само по себе это, конечно, не означает, что LRM умеют думать — лишь то, что мы не можем быть уверены в обратном.
В этой статье я выдвину более смелое утверждение: LRM почти наверняка умеют думать. Я говорю «почти», потому что всегда есть вероятность, что дальнейшие исследования нас удивят. Но я считаю свой аргумент весьма убедительным.
Что такое мышление?
Прежде чем пытаться понять, способны ли LRM мыслить, нам нужно дать определение тому, что мы понимаем под мышлением. Но сначала мы должны убедиться, что люди способны мыслить согласно этому определению. Мы будем рассматривать мышление исключительно в связи с решением проблем, что и является предметом споров.
1. Представление проблемы (лобная и теменная доли)
Когда вы думаете о какой-то проблеме, в этот процесс вовлекается префронтальная кора головного мозга. Эта область отвечает за рабочую память, внимание и исполнительные функции — способности, которые позволяют вам удерживать проблему в голове, разбивать ее на подкомпоненты и ставить цели. Теменная кора помогает кодировать символическую структуру для математических или логических задач.
2. Мысленное моделирование (рабочая память и внутренняя речь)
Оно состоит из двух компонентов: первый — это слуховая петля, которая позволяет вам разговаривать самим с собой, что очень похоже на генерацию CoT. Второй — это визуальные образы, которые позволяют вам мысленно манипулировать объектами. Геометрия была настолько важна для ориентации в пространстве, что у нас развились специализированные способности к ней. Слуховая часть связана с зоной Брока и слуховой корой, заимствованными из речевых центров. Зрительная кора и теменные области в первую очередь управляют визуальным компонентом.
3. Сопоставление с образцом и извлечение данных (гиппокамп и височные доли)
Эти действия зависят от прошлого опыта и накопленных знаний из долгосрочной памяти:
-
Гиппокамп помогает извлекать связанные воспоминания и факты.
-
Височная доля привносит семантические знания — значения, правила, категории.
Это похоже на то, как нейронные сети зависят от своего обучения при обработке задачи.
4. Мониторинг и оценка (передняя поясная кора)
Наша передняя поясная кора (ППК) отслеживает ошибки, конфликты или тупики — именно здесь вы замечаете противоречия или заходы в тупик. Этот процесс по сути основан на сопоставлении с образцом на основе предыдущего опыта.
5. Озарение или переосмысление (сеть пассивного режима работы мозга и правое полушарие)
Когда вы застряли, ваш мозг может переключиться в пассивный режим работы — более расслабленную, внутренне направленную сеть. Именно тогда вы отступаете назад, отпускаете текущую нить и иногда «внезапно» видите новый ракурс (классический момент «эврика!»).
Это похоже на то, как DeepSeek-R1 обучалась рассуждениям по CoT без наличия примеров CoT в своих обучающих данных. Помните, что мозг непрерывно учится по мере обработки данных и решения задач.
В отличие от этого, LRM не имеют возможности меняться на основе обратной связи из реального мира во время прогнозирования или генерации. Но при обучении DeepSeek-R1 с использованием CoT обучение действительно происходило по мере попыток решения задач — по сути, модель обновлялась в процессе рассуждения.
Сходства между рассуждениями CoT и биологическим мышлением
У LRM нет всех вышеперечисленных способностей. Например, маловероятно, что LRM задействует слишком много пространственного мышления в своих схемах, хотя что-то подобное может происходить. Но она точно не генерирует промежуточные изображения в процессе генерации CoT.
Большинство людей могут создавать пространственные модели в своей голове для решения проблем. Означает ли это, что мы можем сделать вывод о неспособности LRM мыслить? Я бы с этим не согласен. Некоторым людям также трудно формировать пространственные модели концепций, о которых они думают. Это состояние называется афантазией. Люди с этим заболеванием прекрасно умеют думать. Фактически, они живут так, будто у них нет никаких дефицитов. Многие из них на самом деле отлично справляются с символическими рассуждениями и неплохо разбираются в математике, чего часто достаточно, чтобы компенсировать отсутствие визуального мышления. Мы вполне можем ожидать, что наши модели на основе нейронных сетей также смогут обойти это ограничение.
Если мы посмотрим на описанный ранее процесс человеческого мышления с более абстрактной точки зрения, то увидим в нем следующие основные составляющие:
1. Сопоставление с образцом используется для извлечения усвоенного опыта, представления проблемы, а также мониторинга и оценки цепочек рассуждений.
2. Рабочая память служит для хранения всех промежуточных шагов.
3. Поиск с возвратом приходит к выводу, что цепочка рассуждений ни к чему не ведет, и совершает возврат к некоторой разумной точке.
Сопоставление с образцом в LRM происходит из ее обучения. Весь смысл обучения заключается в том, чтобы усвоить как знания о мире, так и шаблоны для эффективной обработки этих знаний. Поскольку LRM представляет собой многослойную сеть, вся рабочая память должна помещаться в пределах одного слоя. Весовые коэффициенты хранят знания о мире и шаблоны, которым нужно следовать, в то время как обработка происходит между слоями с использованием изученных шаблонов, хранящихся в виде параметров модели.
Обратите внимание, что даже в CoT весь текст — включая вводные данные, CoT и часть уже сгенерированного вывода — должен помещаться в каждый слой. Рабочая память — это всего лишь один слой (в случае механизма внимания сюда входит кэш ключей и значений KV-cache).
CoT на самом деле очень похожа на то, что мы делаем, когда разговариваем сами с собой (что происходит почти постоянно). Мы почти всегда вербализуем свои мысли, и точно так же поступает система рассуждений CoT.
Существуют также веские доказательства того, что система рассуждений CoT может делать шаги назад (возвращаться), когда определенная линия рассуждений кажется тупиковой. По сути, именно это увидели исследователи из Apple, когда попытались попросить LRM решить более сложные вариации простых головоломок. LRM правильно распознали, что попытки решить головоломки напрямую не поместятся в их рабочей памяти, поэтому они попытались найти лучшие обходные пути, точно так же, как это сделал бы человек. Это служит еще одним доказательством того, что LRM — это мыслители, а не просто слепые исполнители предопределенных шаблонов.
Но почему предсказатель следующего токена должен научиться думать?
Нейронные сети достаточного размера могут научиться любым вычислениям, включая мышление. Но система предсказания следующего слова также может научиться думать. Позвольте мне пояснить.
Распространено мнение, что LRM не умеют мыслить, поскольку в конечном счете они просто предсказывают следующий токен; это всего лишь «прославленная автодополнилка». Эта точка зрения в корне неверна — не потому, что это «автодополнение», а потому, что «автодополнение» не обязано думать. На самом деле предсказание следующего слова далеко от ограниченного представления о мысли. Напротив, это наиболее общая форма представления знаний, на которую только можно надеяться. Позвольте мне объяснить.
Всякий раз, когда мы хотим представить какие-то знания, нам нужен язык или система символов для этого. Существуют различные формальные языки, которые очень точны в отношении того, что они могут выразить. Однако такие языки принципиально ограничены в тех видах знаний, которые они могут представлять.
Например, логика предикатов первого порядка не может выразить свойства всех предикатов, удовлетворяющих определенному свойству, поскольку она не допускает предикаты над предикатами.
Конечно, существуют исчисления предикатов высших порядков, которые могут представлять предикаты над предикатами до произвольной глубины. Но даже они не могут выразить идеи, которым не хватает точности или которые носят абстрактный характер.
Естественный язык, однако, обладает полнотой выразительной силы — вы можете описать любую концепцию с любым уровнем детализации или абстракции. Более того, вы можете даже описать понятия, касающиеся самого естественного языка, используя сам естественный язык. Это делает его сильным кандидатом на роль инструмента представления знаний.
Проблема, конечно, заключается в том, что такое богатство выразительных средств затрудняет обработку информации, зашифрованной в естественном языке. Но нам не обязательно понимать, как делать это вручную — мы можем просто запрограммировать машину с помощью данных посредством процесса, называемого обучением.
Машина предсказания следующего токена по сути вычисляет вероятностное распределение для следующего токена при заданном контексте предшествующих токенов. Любая машина, стремящаяся точно вычислить эту вероятность, должна в какой-то форме представлять знания о мире.
Простой пример: рассмотрим неполное предложение: «Самая высокая горная вершина в мире — гора…» — чтобы предсказать следующее слово как «Эверест», модель должна хранить эти знания где-то у себя. Если задача требует от модели вычислить ответ или решить головоломку, предсказателю следующего токена необходимо выдать токены CoT, чтобы продвигать логику вперед.
Это означает, что, даже предсказывая по одному токену за раз, модель должна внутренне представлять по крайней мере следующие несколько токенов в своей рабочей памяти — достаточно, чтобы оставаться на логическом пути.
Если подумать, люди тоже предсказывают следующий токен — будь то во время речи или при размышлении с использованием внутреннего голоса. Идеальная система автодополнения, которая всегда выдает правильные токены и дает верные ответы, должна быть всеведущей. Конечно, мы никогда не достигнем этой точки — потому что не каждый ответ поддается вычислению.
Тем не менее, параметризованная модель, способная представлять знания путем настройки своих параметров и способная обучаться на данных и с помощью подкрепления, безусловно, может научиться мыслить.
Производит ли это эффекты мышления?
В конечном счете, высшим критерием мышления является способность системы решать задачи, требующие размышлений. Если система может отвечать на ранее не встречавшиеся вопросы, требующие определенного уровня рассуждений, значит, она научилась думать — или, по крайней мере, рассуждать — чтобы прийти к ответам.
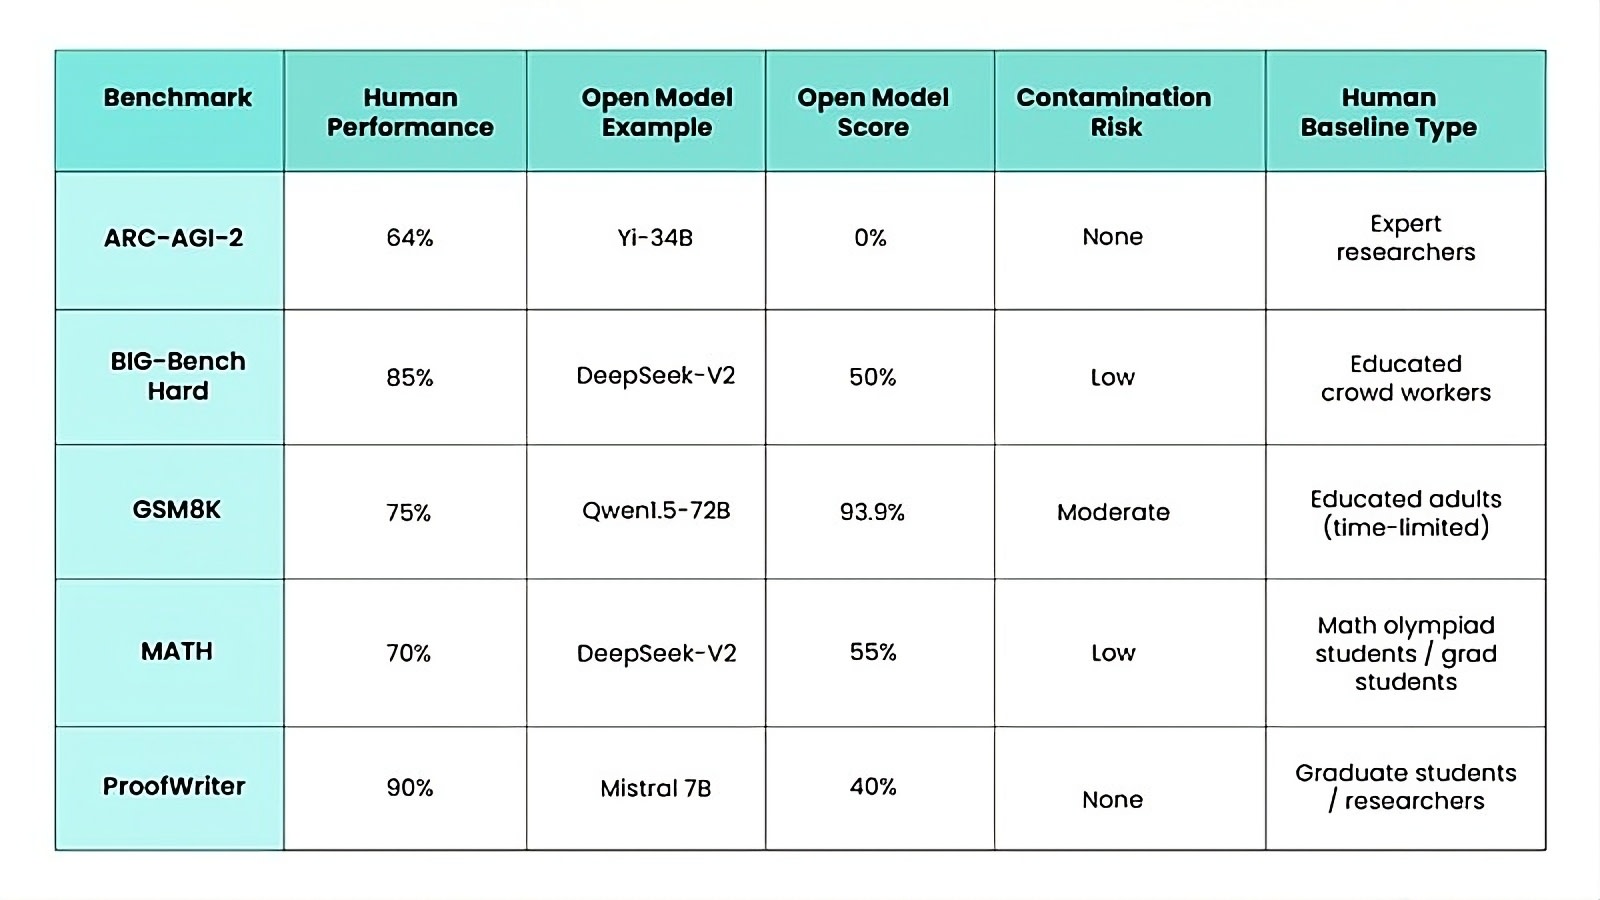
Мы знаем, что проприетарные LRM демонстрируют очень хорошие результаты на определенных бенчмарках рассуждений. Тем не менее, поскольку существует вероятность того, что некоторые из этих моделей были дообучены на тестовых наборах бенчмарков через скрытый ход (бэкдор), ради честности и прозрачности мы сосредоточимся только на моделях с открытым исходным кодом.
Мы оцениваем их с помощью следующих бенчмарков:
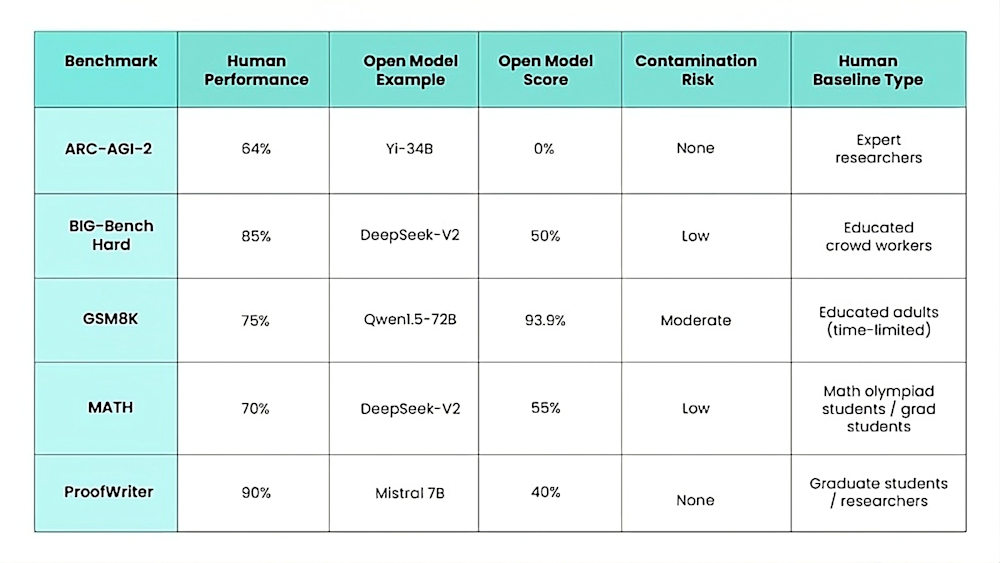
Как видно, в некоторых бенчмарках LRM способны решать значительное число логических задач. Хотя верно, что они по-прежнему уступают человеческим результатам во многих случаях, важно отметить, что базовый уровень человека часто формируется индивидуумами, специально тренированными на этих бенчмарках. Фактически, в определенных случаях LRM превосходят средний уровень неподготовленного человека.
Заключение
Основываясь на результатах тестов, поразительном сходстве между рассуждениями CoT и биологическим мышлением, а также на теоретическом понимании того, что любая система с достаточной репрезентативной емкостью, достаточным количеством обучающих данных и адекватной вычислительной мощностью способна выполнять любую вычислимую задачу — LRM соответствуют этим критериям в значительной степени.
Поэтому вполне разумно сделать вывод, что LRM почти наверняка обладают способностью мыслить.
Дебасиш Рай Чаудхури (Debasish Ray Chawdhuri) — старший главный инженер в компании Talentica Software и аспирант кафедры криптографии в ИИТ Бомбея.
Читайте другие материалы от наших приглашенных авторов. Или отправьте собственную статью! Ознакомьтесь с нашими рекомендациями здесь.
Добро пожаловать в сообщество VentureBeat!
Наша программа гостевых публикаций — это площадка, где технические эксперты делятся инсайтами и представляют нейтральные, непредвзятые глубокие аналитические материалы об ИИ, инфраструктуре данных, кибербезопасности и других передовых технологиях, формирующих будущее бизнеса.
Читайте далее материалы нашей программы гостевых постов и ознакомьтесь с нашими рекомендациями, если вы хотите предложить свою статью!




