


CRV от Meta FAIR повышает возможности рассуждения больших языковых моделей (LLM)


Исследователи из Meta FAIR и Эдинбургского университета разработали новый метод, способный предсказывать правильность рассуждений большой языковой модели (LLM) и даже вмешиваться для исправления ее ошибок. Метод, получивший название верификации рассуждений на основе схем (Circuit-based Reasoning Verification, CRV), заглядывает внутрь LLM, чтобы отслеживать ее внутренние «цепочки рассуждений» и выявлять признаки вычислительных ошибок по мере того, как модель решает задачу.
Их выводы показывают, что CRV способна обнаруживать ошибки в рассуждениях LLM с высокой точностью, строя и анализируя вычислительный граф на основе внутренних активаций модели. В качестве ключевого прорыва исследователи также продемонстрировали, что могут использовать это глубокое понимание для применения целенаправленных вмешательств, исправляющих неверные рассуждения модели «на лету».
Эта техника может помочь решить одну из величайших проблем искусственного интеллекта: обеспечить достоверность и правильность рассуждений модели. Это может стать критически важным шагом на пути к созданию более надежных приложений ИИ для корпоративного сектора, где стабильность имеет первостепенное значение.
Исследование рассуждений по цепочке мысли
Рассуждения по цепочке мысли (Chain-of-Thought, CoT) стали мощным методом повышения производительности LLM в сложных задачах и одним из ключевых компонентов успеха таких моделей рассуждений, как серия OpenAI o и DeepSeek-R1.
Однако, несмотря на успех CoT, метод не является полностью надежным. Сам процесс рассуждений часто оказывается с изъяном, и несколько исследований показали, что токены CoT, генерируемые LLM, не всегда точно отражают ее внутренний процесс рассуждений.
Сугубо текущие средства проверки CoT делятся на две основные категории. «Черноящичные» (black-box) подходы анализируют финальный сгенерированный токен или показатели уверенности для различных вариантов токенов. «Сероящичные» (gray-box) подходы идут дальше, изучая внутреннее состояние модели с помощью простых зондов на ее необработанных нейронных активациях.
Но хотя эти методы могут обнаружить корреляцию между внутренним состоянием модели и ошибкой, они не могут объяснить, почему произошел сбой в базовых вычислениях. Для приложений реального мира, где понимание первопричины сбоя имеет решающее значение, это существенный пробел.
Белоящичный подход к верификации
CRV основана на идее, что модели выполняют задачи с помощью специализированных подграфов, или «схем» (circuits), нейронов, которые функционируют как скрытые алгоритмы. Таким образом, если рассуждения модели дают сбой, он вызван изъяном в выполнении одного из этих алгоритмов. Это означает, что, инспектируя лежащий в основе вычислительный процесс, мы можем диагностировать причину сбоя — подобно тому, как разработчики изучают трассировки выполнения для отладки традиционного программного обеспечения.
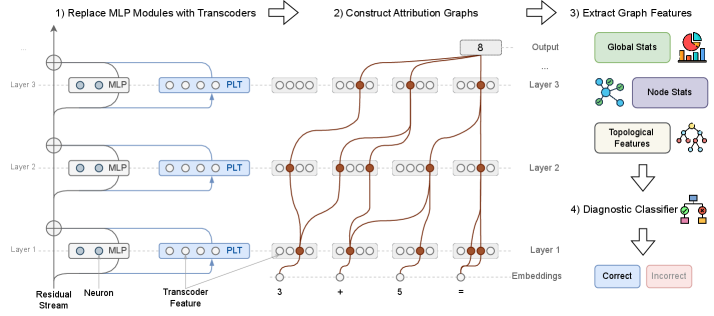
Архитектура моделей с верификацией рассуждений на основе схем (CRV) (источник: arXiv)
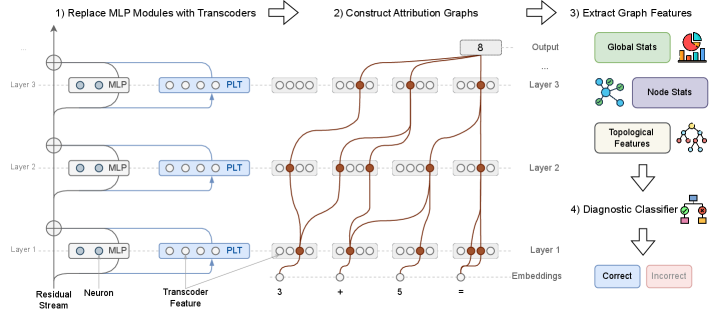
Чтобы сделать это возможным, исследователи сначала обеспечивают интерпретируемость целевой LLM. Они заменяют стандартные плотные слои блоков трансформера обученными «транскодерами» (transcoders). Транскодер — это специализированный компонент глубокого обучения, который заставляет модель представлять свои промежуточные вычисления не в виде плотного, нечитаемого вектора чисел, а в виде разреженного и осмысленного набора признаков. Транскодеры похожи на разреженные автоэнкодеры (SAE), используемые в исследованиях механистической интерпретируемости, с той разницей, что они также сохраняют функциональность эмулируемой ими сети. Эта модификация фактически устанавливает диагностический порт в модель, позволяя исследователям наблюдать за ее внутренней работой.
После внедрения этой интерпретируемой модели процесс CRV разворачивается в несколько этапов. Для каждого шага рассуждения, предпринимаемого моделью, CRV строит «граф атрибуции», отображающий причинно-следственный поток информации между интерпретируемыми признаками транскодера и обрабатываемыми им токенами. Из этого графа извлекается «структурный отпечаток», содержащий набор признаков, описывающих свойства графа. Наконец, на этих отпечатках обучается модель «диагностического классификатора», чтобы предсказать, является ли шаг рассуждения правильным или нет.
Во время инференса классификатор отслеживает активации модели и предоставляет обратную связь о том, находится ли цепочка рассуждений модели на верном пути.
Поиск и исправление ошибок
Исследователи протестировали свой метод на модели Llama 3.1 8B Instruct, модифицированной с помощью транскодеров, оценив ее наборе синтетических (булевых и арифметических) и реальных (математические задачи GSM8K) датасетов. Они сравнили CRV с комплексным набором базовых методов «черного» и «серого» ящиков.
Результаты предоставляют весомую эмпирическую поддержку центральной гипотезе: структурные сигнатуры в вычислительном следе шага рассуждения содержат проверяемый сигнал его правильности. CRV стабильно превосходила все базовые методы по каждому датасету и метрике, демонстрируя, что глубокий структурный взгляд на вычисления модели мощнее поверхностного анализа.
Интересно, что анализ показал: сигнатуры ошибок сильно зависят от предметной области. Это означает, что сбои в различных задачах на рассуждения (формальная логика против арифметических вычислений) проявляются в виде четких вычислительных паттернов. Классификатор, обученный обнаруживать ошибки в одной области, плохо переносится на другую, подчеркивая, что различные типы рассуждений опираются на разные внутренние схемы. На практике это означает, что для каждой задачи может потребоваться обучать отдельный классификатор (хотя сам транскодер остается неизменным).
Самым значительным открытием, однако, является то, что эти сигнатуры ошибок носят не просто корреляционный, а причинно-следственный характер. Поскольку CRV обеспечивает прозрачное представление вычислений, прогнозируемый сбой можно проследить до конкретного компонента. В одном из примеров модель допустила ошибку в порядке операций. CRV отметила этот шаг и определила, что признак «умножения» сработал преждевременно. Исследователи вмешались, вручную подавив этот единственный признак, и модель немедленно исправила свой путь и правильно решила задачу.
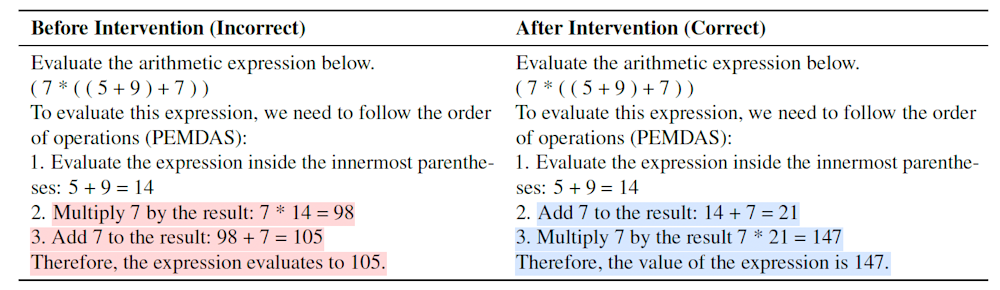
Пример обнаружения и исправления CRV ошибочных рассуждений в LLM (источник: arXiv)
Эта работа представляет собой шаг к более строгой науке об интерпретируемости и контроле ИИ. Как заключают авторы статьи, «эти выводы устанавливают CRV в качестве доказательства концепции механистического анализа, показывая, что переход от непрозрачных активаций к интерпретируемой вычислительной структуре обеспечивает причинное понимание того, как и почему LLM не справляются с правильными рассуждениями». Для поддержки дальнейших исследований команда планирует опубликовать свои датасеты и обученные транскодеры в открытом доступе.
Почему это важно
Хотя CRV является исследовательским доказательством концепции, ее результаты намекают на значительное будущее в разработке ИИ. Модели ИИ изучают внутренние алгоритмы или «схемы» для различных задач. Но поскольку эти модели непрозрачны, мы не можем отлаживать их так же, как стандартные компьютерные программы, прослеживая ошибки до конкретных шагов в вычислениях. Графы атрибуций — это самое близкое к трассировке выполнения средство, показывающее, как результат выводится из промежуточных шагов.
Это исследование предполагает, что графы атрибуций могут стать основой для нового класса отладчиков моделей ИИ. Такие инструменты позволили бы разработчикам понимать первопричину сбоев, будь то нехватка обучающих данных или интерференция между конкурирующими задачами. Это обеспечило бы точечное устранение проблем, например, адресную дообучку (fine-tuning) или даже прямое редактирование моделей вместо дорогостоящего полномасштабного переобучения. Они также могли бы позволить осуществлять более эффективное вмешательство для исправления ошибок модели во время инференса.
Успех CRV в обнаружении и точной локализации ошибок в рассуждениях является обнадеживающим признаком того, что такие отладчики могут стать реальностью. Это проложит путь к более надежным LLM и автономным агентам, способным справляться с непредсказуемостью реального мира и, подобно людям, корректировать курс при совершении ошибок в рассуждениях.




