


Контроль над корпоративными ИИ-агентами сдерживает их внедрение
Источник: VentureBeat · Matt Marshall


(Обновление от 14 июля: скорректирован точный показатель использования)
Крупные компании задействуют ИИ-агенты без предварительного внедрения необходимых для их контроля механизмов — и делают это осознанно. Таков главный вывод июньского исследования VentureBeat Research, в рамках которого были опрошены 573 технических руководителя из компаний со штатом от 100 сотрудников. Опрос охватывал пять параллельных направлений, связанных со стеком ИИ-агентов.
Теперь предприятиям приходится в спешном порядке дорабатывать системы, чтобы соответствовать собственным стандартам, и они уже закладывают на это бюджеты: согласно исследованию, примерно 6 из 10 компаний планируют сменить или добавить вендоров на каждом из пяти уровней контроля в течение ближайших 12 месяцев, а около трети (в зависимости от конкретного уровня) намерены сделать это уже в текущем квартале.
Выделяются пять основных уровней, на которых компании ведут разработку: управление доступом и идентификация агентов (какой агент и что имеет право делать, под чьей учетной записью); оценка результатов работы агентов (насколько качественен этот труд); телеметрия затрат (во сколько обходится запуск каждого агента); контекстный уровень (бизнес-данные и определения, к которым агенты обращаются за ответами); а также плоскость управления оркестрацией (ПО, координирующее многоэтапную работу агентов).
Компании уже расплачиваются за развертывание агентов в обход надлежащих функций контроля. За последние 12 месяцев 54% организаций сталкивались с инцидентами безопасности или ситуациями, когда катастрофы удавалось избежать в последний момент. 27% осуществляют лишь реактивный контроль расходов на агентов: они узнают о стоимости работы агента только в момент получения счета, не имея никаких бюджетов или лимитов на одного агента.
573 респондента из организаций с численностью персонала от 100 человек в рамках пяти опросов, проведенных в июне 2026 года:
101 — оркестрация · 157 — надежность / оценка · 107 — безопасность / идентификация · 107 — инфраструктура / вычисления · 101 — контекст / RAG
Выборки сформированы методом самоотбора; результаты следует воспринимать как указание на общие тенденции. Доверяйте закономерностям, а не точным процентам: каждый опрос независимо друг от друга указывает на одно и то же — внедрение технологий опережает процессы управления, прозрачности и контроля затрат.
Полные отчеты на конференции VB Transform, 14–15 июля в Менло-Парке →
Ниже приведены пять ключевых выводов, лежащих в основе исследования (по одному на каждый уровень технологического стека), а также рекомендации о том, с чего стоит начать в каждом конкретном случае.
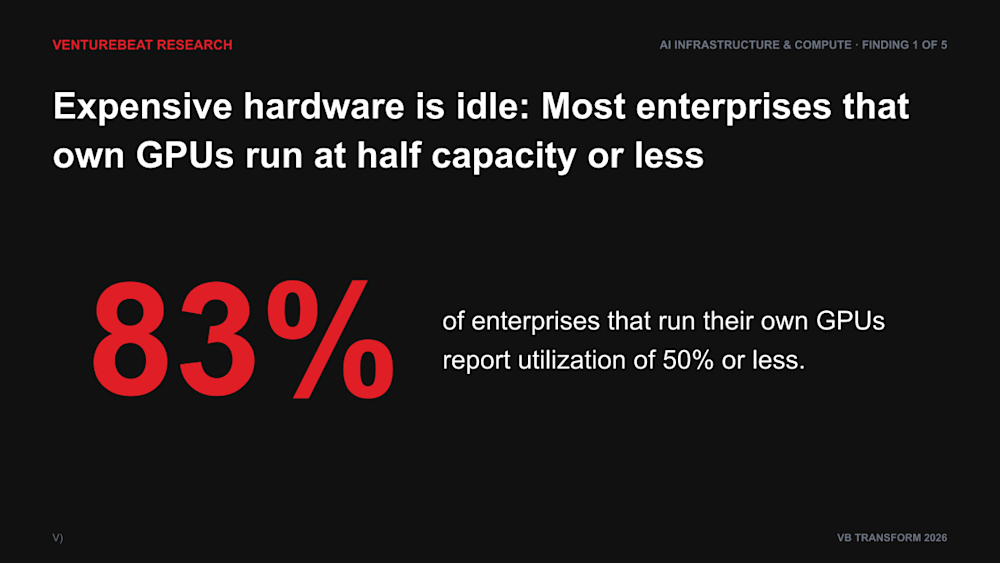
Дорогое железо простаивает: более 80% операторов графических процессоров заявляют об их загрузке на 50% или меньше
Около 83 процентов компаний, использующих собственные графические процессоры (GPU), сообщают об их загрузке на уровне 50% или ниже. Весь последний квартал Уолл-стрит спорила о том, не оказался ли масштаб инвестиций в ИИ избыточным. Представленные данные отражают реальную картину со стороны покупателей — самих предприятий: самое дорогое аппаратное обеспечение в их распоряжении задействовано максимум наполовину своей мощности.
Проблема усугубляется дефицитом метрик: лишь меньшинство (44%) тщательно отслеживают реальные затраты на ИИ-вычисления и их окупаемость. Все остальные занимаются лишь приблизительными оценками. Тем не менее процесс закупок в компаниях продолжается: 45% организаций заявляют, что в ближайшие 12 месяцев с наибольшей вероятностью будут оценивать такое перспективное вычислительное решение, как облака со специализацией под ИИ (CoreWeave, Lambda, Crusoe, Nebius). При этом менее 2% таких компаний пользуются подобными неоклаудами сегодня.
Кроме того, примерно каждая третья компания рассматривает возможность подстраховаться на случай рисков, связанных с Nvidia: на вопрос о том, какие новые вычислительные решения они вероятнее всего будут оценивать в течение следующих 12 месяцев, 32% предприятий назвали ускорители не от Nvidia (AWS Trainium, Google TPU, AMD), в то время как 28% упомянули графические процессоры Nvidia нового поколения. Собранные данные свидетельствуют о том, что предприятиям следует измерять уровень загрузки и стоимость работы на конкретную задачу для уже имеющихся у них GPU, прежде чем выделять бюджеты на новые вычислительные мощности — будь то контракт со специализированным ИИ-облаком, новые ускорители или дополнительные графические процессоры.
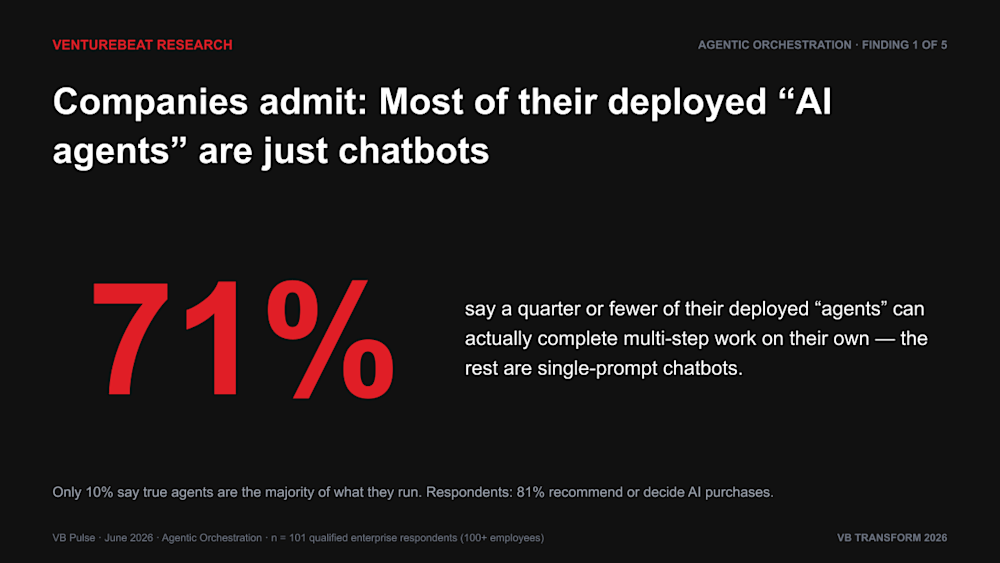
Большинство развернутых «агентов» выполняют задачи по принципу одного промпта: 71% респондентов говорят, что лишь четверть или меньше таких систем решают многоэтапные задачи самостоятельно
Семьдесят один процент компаний заявляют, что лишь четверть или меньшая доля развернутых ими «агентов» способна автономно выполнять многоэтапные задачи; остальные представляют собой обычные чат-боты, работающие по принципу одиночного запроса. И лишь 10% утверждают, что подавляющую часть их парка составляют полноценные агенты. Примечательно, что респонденты обладают достаточной компетенцией для подобных оценок: 81% из них заявили, что именно они рекомендуют или принимают решения о закупках ИИ в своих компаниях.
Этот вывод — о том, что большинство агентов на деле оказываются лишь чат-ботами в «маскировке» — контрастирует с заявлениями участников рынка об уровне внедрения, которые значительно опережают реальное положение дел в компаниях. Аналитики Gartner прогнозировали, что к концу 2026 года 40% корпоративных приложений будут интегрированы с узкоспециализированными ИИ-агентами по сравнению с менее чем 5% в 2025 году. Организация также предупреждала, что самая распространенная ошибка — называть простые ИИ-ассистенты агентами (явление, получившее название «agentwashing» или приукрашивание действительности).
Тем временем в корпоративном опросе Zapier 72% респондентов заявили о развертывании или тестировании автономных агентов, а исследование компании Writer за 2026 год показало, что 97% руководителей сообщили об использовании ИИ-агентов в своей компании за последний год.
В упомянутых опросах у компаний спрашивали, внедрили ли они так называемого ИИ-агента, и получали утвердительный ответ. Наш опрос задал управленцам, отвечающим за эти внедрения, более сложный вопрос: какое количество работающих у вас агентов способно выполнить многоэтапную задачу без постоянного контроля со стороны человека на каждом шаге? Этот разрыв имеет критическое значение по двум практическим причинам. Во-первых, завышенные показатели внедрения используются советами директоров и вендорами для давления на технических лидеров с целью ускорить процессы — в то время как наши данные показывают, что реальная планка гораздо ниже заголовков в СМИ. Во-вторых, ярлык определяет стоимость: простому чат-боту с человеком, читающим каждый ответ, не требуются ни функции идентификации, ни оценки, ни контроля расходов, о которых говорится в этом отчете, тогда как полноценному многоэтапному агенту необходимы все они.
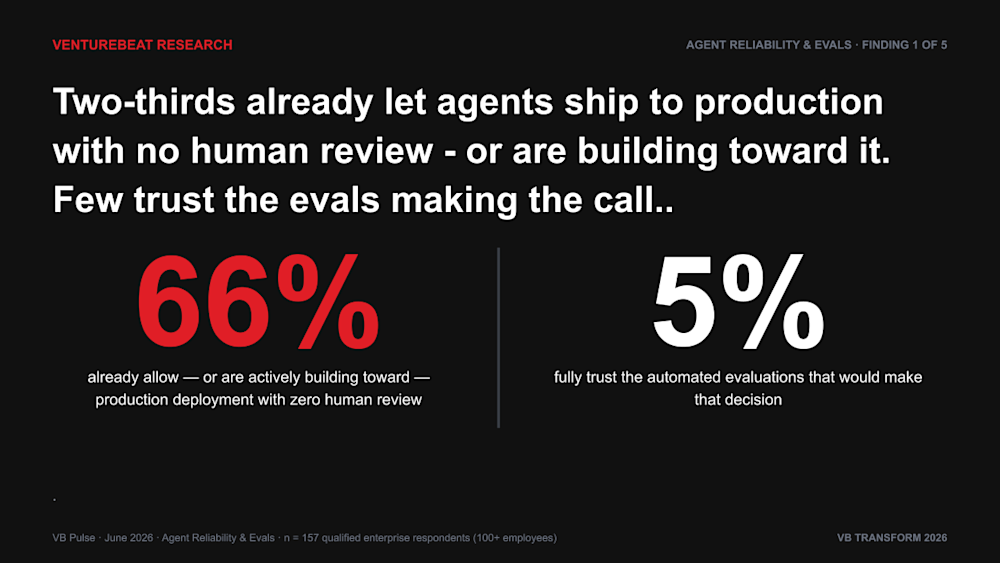
66% компаний позволяют агентам вносить изменения в продакшн на основе одних лишь автоматических оценок — или активно готовятся к этому. Лишь 5% полностью доверяют таким оценкам
Две трети компаний делятся на две категории: 34% уже разрешают ИИ-агенту внедрять изменения в код или системные настройки на базе результатов автоматического тестирования без проверки человеком, а еще 33% активно перестраивают свои рабочие процессы, чтобы внедрить такую практику в течение ближайших 12 месяцев. И лишь пять процентов полностью доверяют автоматизированным оценкам, на основе которых принимаются подобные решения.
Такое недоверие вполне обоснованно. Половина предприятий за последний год запускала в продакшн агента, который успешно прошел внутренние тесты, но впоследствии привел к сбоям на стороне пользователей; четверть сталкивалась с этим неоднократно. На вопрос о главной слабости текущих систем оценки больше всего респондентов (29%) выбрали вариант «слабая корреляция с реальными результатами работы».
При этом большая часть проверок происходит до того, как агент отправляется в релиз, после чего прекращается. Когда агенты начинают работу с реальными пользователями, лишь 23% компаний проводят мониторинг качества ответов в режиме реального времени. Еще 51% следят исключительно за работоспособностью системы — доступностью (аптаймом), трейсами запросов и логами шлюзов. Это лишь подтверждает, что агент функционирует технически, но ничего не говорит о правильности его ответов. Первое действие: прежде чем убирать человека из контура проверки в любом рабочем процессе, протестируйте свои критерии оценки на реальных результатах продакшна, а не на внутренних бенчмарках, и отслеживайте качество ответов, а не только доступность.
Этот вопрос подробнее рассматривается в материале VentureBeat, посвященном проблеме разрыва в оценке. В нем отмечается, что крупные компании движутся к полной автоматизации быстрее остальных, но при этом чаще совершают ошибки, а также предлагается фреймворк регрессионного тестирования, основанный на реальных результатах продакшна, а не на внутренних бенчмарках.
69% компаний допускают совместное использование учетных данных среди агентов — и такие организации сталкиваются с проблемами гораздо чаще
Шестьдесят девять процентов компаний разрешают ИИ-агентам совместно использовать учетные данные (креды) в процессе работы — это означает, что несколько агентов функционируют под одним ключом API или одной служебной учетной записью. Такие организации гораздо чаще подвергаются рискам: среди компаний, где практикуется шеринг кредов, инциденты безопасности или околокритические ситуации фиксировались в 63,5% случаев (47 из 74), в то время как среди тех, где каждый агент обладает собственным ограниченным уровнем доступа, этот показатель составил 40,9% (9 из 22).
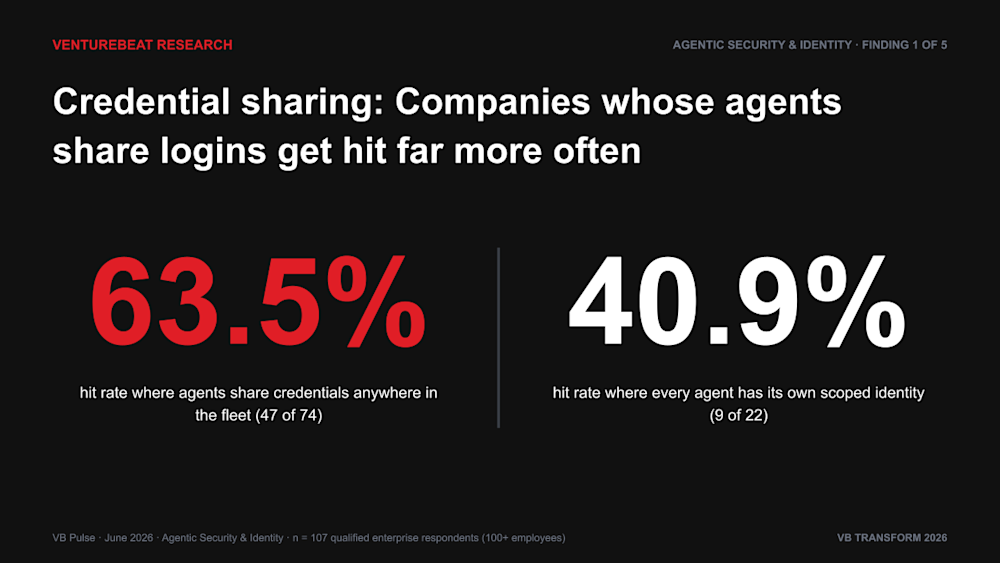
Главный вывод для бизнеса таков: предоставьте каждому агенту отдельную изолированную учетную запись, начав с тех систем, которые имеют доступ к рабочим средам продакшна.
57% компаний проследили связь между уверенными, но ошибочными ответами агентов и отсутствием у них необходимого или непротиворечивого бизнес-контекста
Пятьдесят семь процентов предприятий за последние шесть месяцев хотя бы раз сталкивались с ситуацией, когда уверенный, но неверный ответ агента был вызван отсутствием или несогласованностью бизнес-контекста: неверными метриками, устаревшими определениями или недостающими документами. Большинство из них наблюдали это неоднократно.
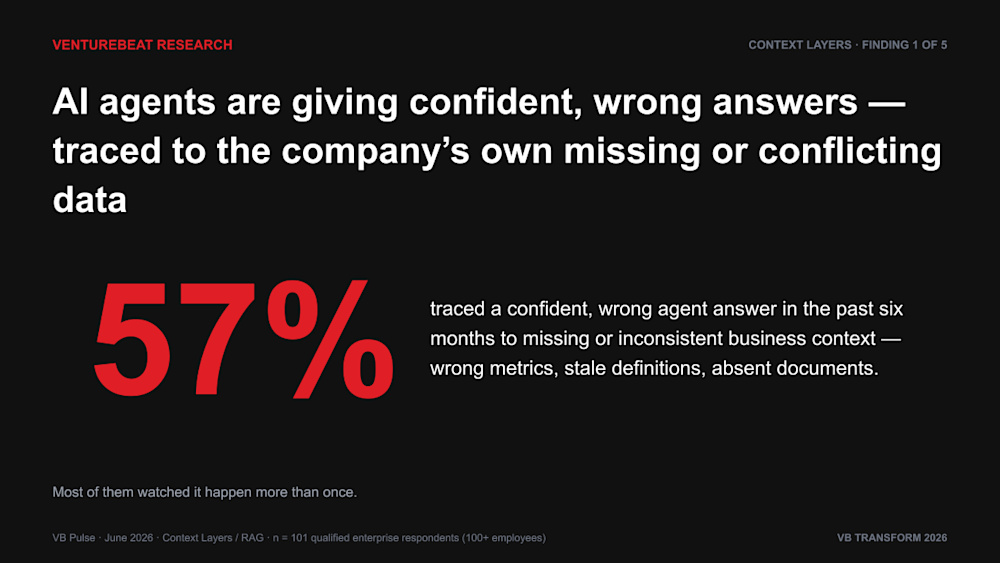
Большинство компаний решают эту проблему, даже несмотря на то, что уже продвинулись вперед в развертывании агентов: 25% уже используют управляемый семантический слой — единое регламентированное описание бизнес-логики, к которому обращаются все ИИ-системы. Тем не менее 34% еще находятся в процессе создания такого слоя, а 41% даже не приступали к этому. Вывод: упорядочите определения, на которые опираются ваши агенты (в первую очередь метрики и сущности), прежде чем масштабировать системы, зависящие от них.
Квартал, когда «переносимость» агентских технологий стала приоритетом
Стоит упомянуть еще об одном изменении, четко обозначившем свои контуры. В ходе нашей весенней волны опросов по оркестрации главным опасением в отношении контролируемых вендорами решений были ограничения безопасности и прав доступа (32%). К июню на первое место вышла проблема зависимости от конкретного вендора (lock-in) с результатом около трети голосов, в то время как ограничения безопасности набрали 28%.
Это два среза данных с разницей в один квартал, и вот одно из возможных объяснений того, почему портируемость вышла для предприятий на первый план. Наш июньский опрос вышел на рынок вскоре после того, как 12 июня Министерство торговли США ввело экспортные ограничения, на примерно три недели заблокировавшие для компаний доступ к модели Claude Fable 5 от Anthropic. Тем временем китайская компания Z.ai выпустила открытые веса модели GLM-5.2 под лицензией MIT (16 июня) по цене примерно в шесть раз ниже стоимости GPT-5.5; компания Tencent представила модель Hy3 (6 июля) под лицензией Apache 2.0 при вдвое меньшем размере и превосходстве почти во всем, кроме кодинга; а OpenAI анонсировала семейство моделей GPT-5.6 (26 июня) для узкого круга одобренных правительством партнеров, открыв к ним более широкий доступ 9 июля после прохождения госконтроля. Выпуск моделей с открытыми весами особенно ярко демонстрирует стремление компаний получить больше контроля над агентами, и хотя прямая причинно-следственная связь здесь не доказана, само совпадение по времени показательно.
Настроения респондентов подтверждают эту динамику: 51% опрошенных теперь ожидают, что к концу 2026 года их главная плоскость управления корпоративными агентами будет гибридной (собственные инструменты провайдера в сочетании с внешней оркестрацией) по сравнению с 34% в ходе весеннего опроса. Доля предприятий, заявляющих, что они полагаются исключительно на управляемые провайдером агентские сервисы, сократилась с 12% до 7%.
Пять уровней, отсутствие явных лидеров, 12 месяцев
Обобщенные результаты всех пяти опросов указывают на масштабное «окно для закупок». На каждом из пяти уровней контроля от 57% до 64% компаний планируют сменить вендоров или привлечь новых в течение 12 месяцев (64% в инфраструктуре и оценках, 59% в безопасности агентов, 57% в поиске и контексте), а от 26% до 38% (в зависимости от уровня) намерены сделать это в течение квартала. На рынке пока нет устоявшихся лидеров: в качестве наиболее распространенных инструментов оценки респонденты называют встроенные в языковые модели средства либо полное отсутствие специализированных инструментов (по 17% каждый); 82% участников опроса называют встроенные средства облачных провайдеров или гиперскейлеров в качестве основного уровня безопасности агентов; встроенные провайдерами решения для поиска лидируют и на технологическом уровне контекста (RAG и т.д.).
Большинство компаний сегодня по умолчанию используют встроенные инструменты, поставляемые вместе с крупными ИИ-платформами, к которым они уже привыкли: Anthropic, OpenAI, Google, Microsoft и AWS. Это справедливо для каждого из уровней агентского технологического стека: предприятия рассчитывают, что их основные облачные провайдеры и разработчики моделей предоставят защитные механизмы, инструменты оценки и решения для поиска информации, которые уже встроены в их предложения.
Эти стандартные инструменты выигрывают за счет удобства, и именно им предстоит пройти проверку в ходе грядущих расходов. Опрос не ставил целью выяснить, куда именно направятся эти деньги — в сторону встроенных платформ или к независимым специализированным игрокам, — и именно поэтому за судьбой каждого контракта на этих пяти уровнях будет крайне интересно наблюдать в течение следующих четырех кварталов.
Опрос в третьем квартале покажет, выполнили ли компании свои бюджетные планы: обрели ли их агенты изолированные идентификаторы, стали ли оценки тестироваться на реальных результатах продакшна, выросла ли загрузка графических процессоров и были ли запущены разрабатываемые семантические уровни.
VentureBeat опубликует полные отчеты за второй квартал по всем пяти трекерам VB Pulse на конференции VB Transform (14–15 июля в отеле Nia в Менло-Парке), где соберутся технические лидеры бизнеса, занимающиеся созданием автономных агентов в реальных производственных средах.
Раскрытие информации: VentureBeat выступает в роли производителя как данного исследования, так и конференции VB Transform




