


Оценка ИИ-агентов: доверие отстает от растущей автономности
Источник: VentureBeat · Carl Franzen


Корпоративные команды разработчиков ИИ предоставляют агентам все больше свободы именно в тот момент, когда их уверенность в автоматизированном тестировании стремительно падает.
Половина предприятий внедряли ИИ-агентов или функции на базе LLM, которые успешно прошли внутреннюю оценку, но все равно привели к сбоям при взаимодействии с клиентами (причем каждая четвертая компания сталкивалась с этим неоднократно). Об этом свидетельствуют результаты опроса VB Pulse, проведенного в июне 2026 года среди 157 квалифицированных респондентов из компаний со штатом от 100 сотрудников.
Выборка является стихийной, а не вероятностной, поэтому результаты следует рассматривать как отражающие общую тенденцию, а не как абсолютно точные.
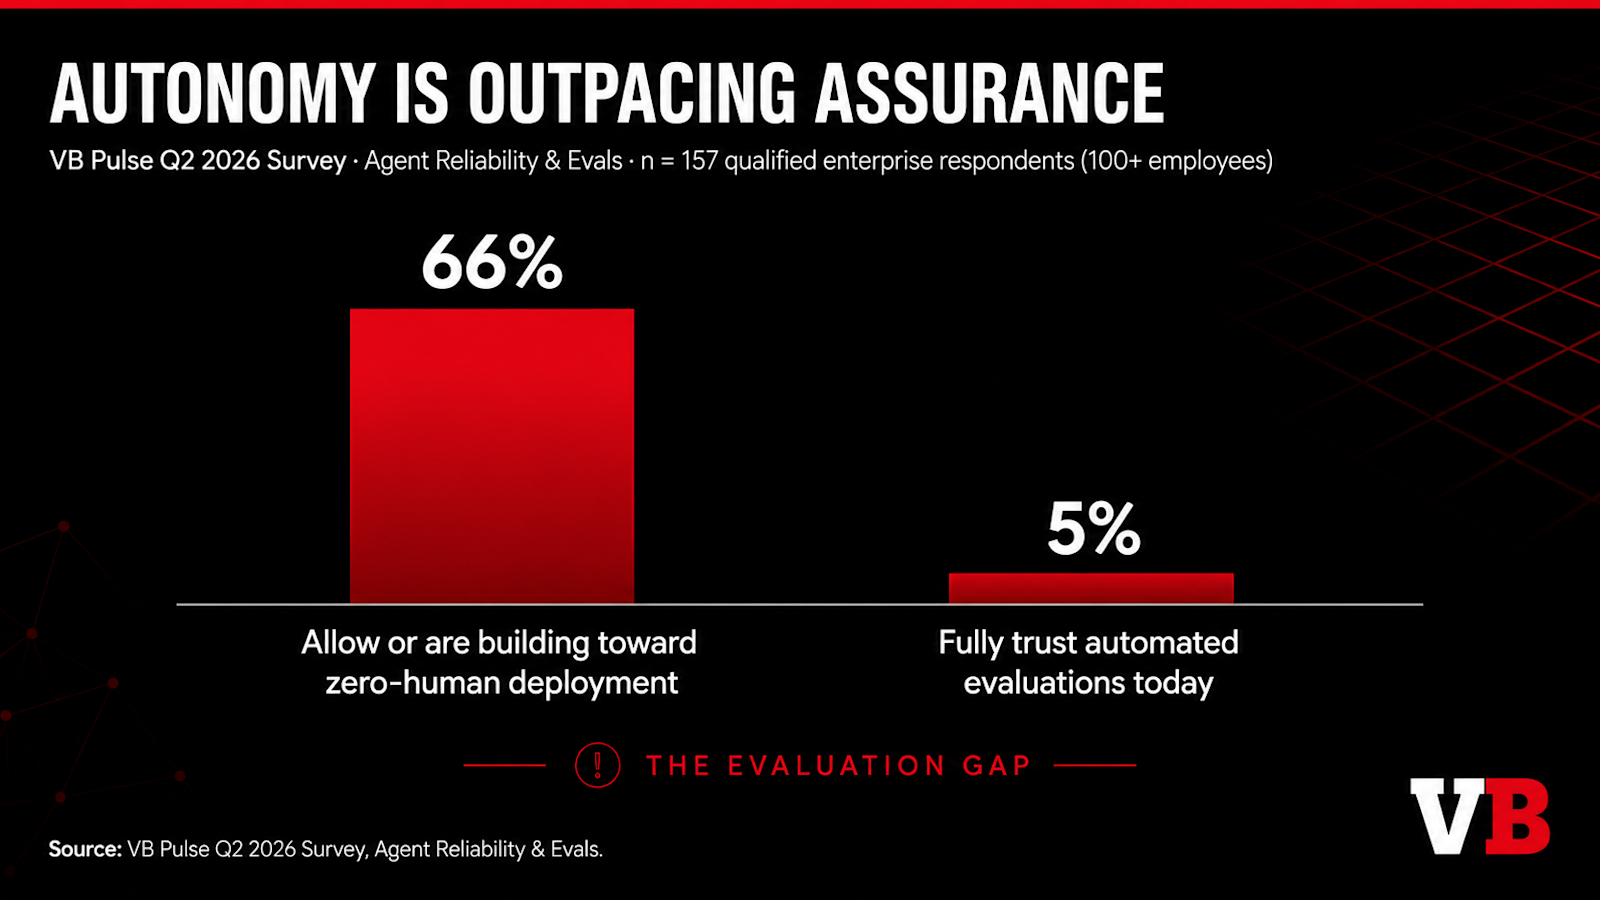
Однако бизнес реагирует на это вовсе не замедлением автоматизации: 66% респондентов уже разрешают частичное развертывание в рабочей среде без участия человека либо создают системы, рассчитанные на это в течение ближайших 12 месяцев. При этом лишь 5% заявляют, что полностью доверяют автоматизированному тестированию, на основе которого должны приниматься решения о релизе.
Это несоответствие создает так называемый «разрыв в оценке» (evaluation gap): планка автономности повышается быстрее, чем гарантии ее надежности.
Это также согласуется с более широким тезисом, который будет обсуждаться на конференции VB Transform 2026: компании сначала выпускают агентов, а уровни контроля безопасности и идентификации, оценки качества, затрат, контекста и оркестрации внедряют уже потом. Следующий год станет периодом доработок и модернизации, когда заказчики перенаправят бюджеты на системы, обеспечивающие управляемость и надежность внедрения агентов.
Почему успешное прохождение тестов не означает готовность агента
Традиционное тестирование ПО обычно проверяет, дает ли заданный входной сигнал ожидаемый результат. Тестировать агентов сложнее, поскольку система может сама выбирать последовательность шагов, обращаться к инструментам, извлекать данные, изменять состояние и выдавать разные ответы от запуска к запуску.
Агент может принять несколько вполне разумных по отдельности решений и все равно прийти к неверному результату. Он может найти нужный аккаунт, но обновить не то поле. Может составить корректный запрос на возврат средств, но отправить его без согласования. Или успешно задействовать пять инструментов, а на шестом шаге допустить утечку конфиденциальной информации либо оставить рабочий процесс незавершенным.
Опрос показывает, что бизнес уже осознает это ограничение. Главная причина недоверия к автоматизированной оценке — слабая корреляция с реальными результатами: ее назвали 29% респондентов. Далее следуют предвзятость или нестабильность (21%), недостаточная объяснимость (18%), а также опасения по поводу утечки данных и конфиденциальности (17%).
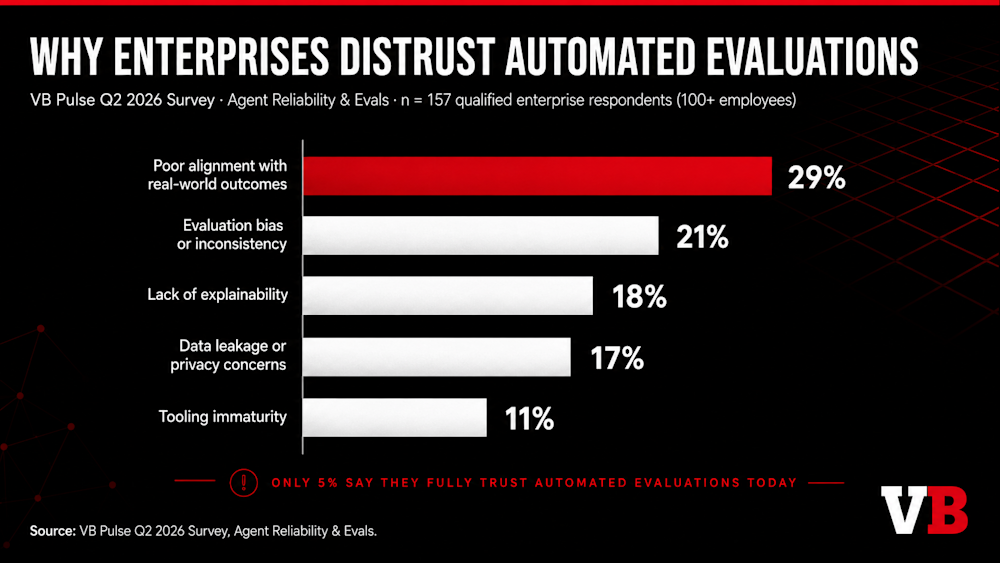
Эта иерархия факторов показательна. Компании утверждают, что оценка в тестах зачастую не предсказывает, что произойдет при реальном взаимодействии клиента, сотрудника или бизнес-процесса с агентом, — дело вовсе не в том, что автоматическое тестирование слишком медленное или дорогое.
К аналогичному выводу приходит и NIST в своем руководстве Generative AI Profile: метрики, собранные в контролируемой среде, могут не соответствовать реальным условиям развертывания, поскольку поведение модели меняется в зависимости от промптов, пользователей, контекста и условий эксплуатации. Рекомендации института призывают к натурным испытаниям, мониторингу после внедрения и четко регламентированным процессам эскалации сбоев.
Возможности — это еще не стабильность
Один успешный запуск доказывает лишь то, что агент способен выполнить задачу. Но это не означает, что он будет выполнять ее стабильно.
Руководство Anthropic по оценке агентов четко разграничивает два критерия: решает ли система задачу хотя бы один раз при серии попыток или же она справляется с ней каждый раз. Это различие принципиально для клиентских и операционных процессов. Модель, способная время от времени выдавать превосходный результат, все равно может оказаться неприемлемой, если при следующей попытке выполнение той же задачи непредсказуемо завершится сбоем.
Поэтому корпоративным командам следует рассматривать повторяемость как метрику первостепенной важности. Это означает многократный прогон одного и того же сценария с варьированием формулировок и контекста, тестирование сбоев инструментов и проверку того, остается ли конечный бизнес-результат корректным даже при изменении маршрута решения.
Набор тестов также должен развиваться. Каждый инцидент в рабочей среде должен становиться постоянным регрессионным тестом. Эскалации от клиентов, сбои при вызове инструментов, ошибочные согласования и огрехи в обработке данных должны возвращаться в тестовый набор до развертывания, а не оставаться единичными случаями из службы поддержки.
Автономия должна расширяться соразмерно рискам, а не амбициям
Результаты опроса не означают, что каждое действие агента должно требовать участия человека. Проверка людьми не способна масштабироваться на миллионы решений с незначительными последствиями.
Однако полностью автономная работа без участия человека должна быть заслужена доказанной надежностью и ограничена рамками возможных последствий сбоя.
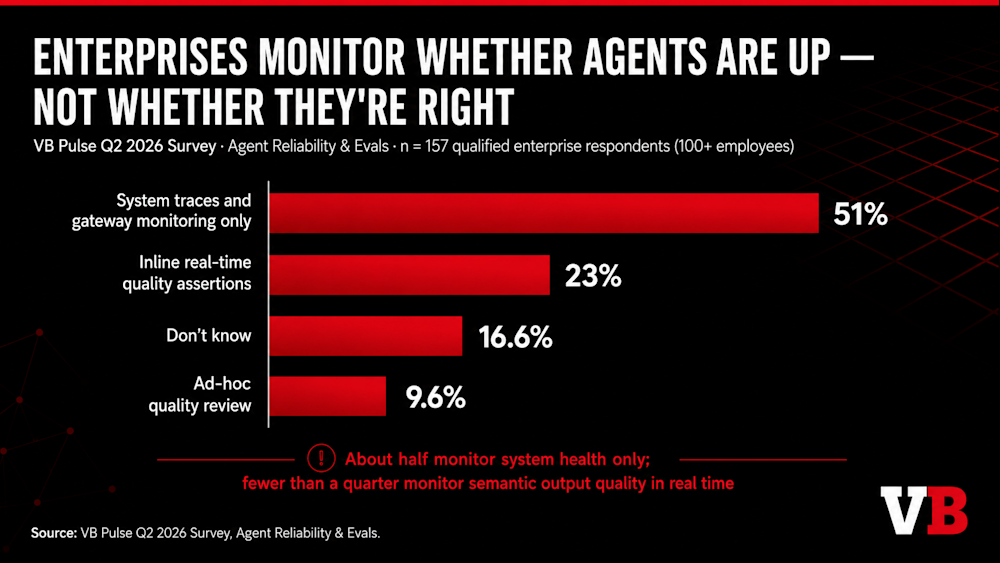
Действия с низким уровнем риска, такие как составление внутренних сводок или категоризация документов, допускают более высокую степень автономии. Финансовые же транзакции, общение с клиентами, развертывание кода, изменение прав доступа и удаление данных требуют более строгих пороговых значений, повторных тестов на стабильность, проверок на соответствие политикам, механизмов отката и четких путей эскалации на человека.
При этом риски распределяются неравномерно и в зависимости от размера компании. Крупные предприятия (с числом сотрудников от 2500) быстрее всех переходят к полностью автономному развертыванию: 70% против 64% у менее крупных компаний. Но они же и чаще внедряют агентов, которые впоследствии дают сбой в работе с клиентами: 54% против 48%.
Это предостережение для руководителей бизнеса. Исключение человека из цепочки принятия решений не устраняет неопределенность. Без надежных гарантий оно лишь превращает неопределенность в автоматизированное решение в рабочей среде.
Рынок продолжит стремиться к большей автономности, поскольку экономическая выгода очевидна. Однако в наиболее выигрышном положении окажутся не те организации, которые быстрее всех исключат человека из процессов, а те, кто относится к повторяемости и регрессионному тестированию так же серьезно, как и к скорости внедрения.




