


OpenAI представляет модели GPT-5.6 Sol, Terra и Luna — но пока они доступны только ограниченному кругу партнеров по предварительному просмотру по требованию правительства США
Источник: VentureBeat · Carl Franzen


OpenAI анонсировала ограниченную предварительную версию своего новейшего передового семейства ИИ-моделей GPT-5.6, которое включает три варианта: Sol, Terra и Luna.
Модель Sol предназначена для решения самых сложных задач, таких как сложное программирование и исследования в области безопасности; Terra ориентирована на масштабные бизнес-задачи, включая поддержку клиентов, внутренние инструменты и анализ документов; а Luna создана для более быстрой и недорогой повседневной работы, такой как суммаризация, составление чертежей и рутинная автоматизация. Sol и Terra устанавливают новые высокие стандарты в бенчмарках, в то время как Luna на нескольких тестах демонстрирует результаты, близкие к уровню GPT-5.5, несмотря на позиционирование в качестве самой быстрой и экономичной модели в семействе GPT-5.6.
Тем не менее, на первом этапе модели будут доступны лишь узкому кругу примерно из 20 организаций после того, как OpenAI поделилась моделями и планами их выпуска с правительством США. Полномасштабный релиз запланирован на «ближайшие недели».
Поэтапный выпуск последовал за указом президента Дональда Трампа, подписанным ранее в этом месяце, 2 июня 2026 года, который призывает различные федеральные ведомства сотрудничать в разработке процесса тестирования и оценки возможностей новых ИИ-моделей для обеспечения их безопасности и пригодности к широкому распространению.
Хотя этот процесс еще продолжается (согласно указу, на него отводится 30 дней, то есть до 2 июля), OpenAI сообщает в своем официальном блоге, что компания «представила наши планы и возможности моделей в преддверии сегодняшнего запуска. По запросу [правительства США] мы начинаем с ограниченного превью для небольшой группы доверенных партнеров».
Стратегия ограниченного предварительного релиза от OpenAI также последовала за решительным шагом со стороны правительства США, издавшего указ об экспортном контроле в отношении Anthropic — главного американского конкурента OpenAI, из-за уязвимостей (jailbreaks), обнаруженных в ее самой мощной модели для широкой публики Claude Fable 5. В ответ Anthropic полностью закрыла доступ к этой модели и ее ориентированному на кибербезопасность аналогу Claude Mythos 5 как для частных, так и для корпоративных пользователей. (Ранее Anthropic уже демонстрировала раннюю версию модели под названием «Claude Mythos Preview» ограниченному числу внешних участников своей программы исследований в области кибербезопасности «Project Glasswing», стартовавшей в апреле.)
Поскольку OpenAI согласовывает свою релизную структуру с Белым домом в преддверии более широкого публичного запуска, корпоративным покупателям приходится ориентироваться в принципиально новой среде реального времени, включающей меры безопасности, обязательные параметры комплаенса и структурированные системы кэширования токенов.
Чем отличаются три новые модели GPT-5.6: Sol против Terra и Luna
Три модели GPT-5.6 разработаны с учетом различных корпоративных потребностей и профилей производительности.
Sol — это флагманский вариант, созданный для самых требовательных задач, таких как сложное логическое мышление, продолжительные сеансы программирования, продвинутые рабочие процессы на базе агентов и приложения, ориентированные на безопасность.
Sol обеспечивает максимальный уровень возможностей, но при этом стоит дороже всего: $5.00 за миллион входных токенов / $30.00 за миллион выходных токенов — столько же, сколько и GPT-5.5. В OpenAI заявляют, что модель обеспечивает значительный прирост производительности в долгосрочных задачах программирования, кибербезопасности и агентских сценариях.
Terra балансирует между высокой производительностью и эффективностью. Она предназначена для крупномасштабных производственных сред, где организациям требуются надежные результаты при больших объемах работы без избыточных затрат на самую продвинутую модель. Она доступна по цене $2.50 / $15 за 1 млн токенов.
Luna — наиболее легкий и экономичный вариант, оптимизированный для скорости и повседневных сценариев использования. Она отлично подходит для простых задач, рутинных рабочих процессов и приложений, где скорость отклика и масштабируемость важнее максимальной глубины рассуждений. Это самый доступный вариант стоимостью $1 и $6 за миллион входных и выходных токенов соответственно.
Источники, знакомые с внутренними процессами OpenAI, сообщили VentureBeat, что новая схема наименований была разработана с целью отказаться от вариантов «nano» и «mini» для GPT-5, поскольку эти модели не столько отличаются по размеру или базовому интеллекту, сколько предназначены для совершенно разных сценариев использования.
Как говорится в блоге OpenAI, посвященном новой системе наименований: «В этой новой системе именования, представленной вместе с GPT‑5.6, номер указывает на поколение модели, в то время как Sol, Terra и Luna обозначают постоянные уровни возможностей, которые могут развиваться в собственном темпе. В совокупности это семейство предоставляет пользователям и разработчикам более четкий выбор между интеллектом, скоростью и стоимостью».
Кроме того, по словам источников, в OpenAI стремились вызвать чувство вдохновения, обращаясь к космосу и связанным с ним именам.
Более того, Sol отлично вписывается в добровольную программу OpenAI Daybreak для организаций, заинтересованных в использовании моделей компании для укрепления киберзащиты, что является приятным бонусом. Голосовой стиль «Sol» в голосовом режиме ChatGPT не имеет к этому отношения и, вероятно, будет переименован.
В новой системной карте GPT-5.6 содержится еще один важный для бизнеса нюанс: OpenAI классифицирует все три модели GPT-5.6 — а не только Sol — на уровне риска «Высокий» (High) как в отношении кибервозможностей, так и в биологической/химической сфере, в то время как по параметру самосовершенствования ИИ они оцениваются ниже этого уровня. Это означает, что даже более дешевые уровни Terra и Luna могут накладывать новые обязательства по управлению на компании, использующие их в сфере безопасности, наук о жизни или других чувствительных рабочих процессах.
Ниже приведено сравнение стоимости моделей с другими лидерами в сфере LLM — обратите внимание, что самый дешевый вариант от OpenAI в целом представляет собой модель сред ценового диапазона и все же дороже передового решения GLM-5.2.
|
Модель |
Вход |
Выход |
Общая стоимость |
Источник |
|
MiMo-V2.5 Flash |
$0.10 |
$0.30 |
$0.40 |
|
|
deepseek-v4-flash |
$0.14 |
$0.28 |
$0.42 |
|
|
deepseek-v4-pro |
$0.435 |
$0.87 |
$1.305 |
|
|
MiniMax-M3 |
$0.30 |
$1.20 |
$1.50 |
|
|
Gemini 3.1 Flash-Lite |
$0.25 |
$1.50 |
$1.75 |
|
|
Qwen3.7-Plus |
$0.40 |
$1.60 |
$2.00 |
|
|
MiMo-V2.5 |
$0.40 |
$2.00 |
$2.40 |
|
|
Grok 4.3 (низкий контекст) |
$1.25 |
$2.50 |
$3.75 |
|
|
MiMo-V2.5 Pro (≤256K) |
$1.00 |
$3.00 |
$4.00 |
|
|
Kimi-K2.6 |
$0.95 |
$4.00 |
$4.95 |
|
|
GLM-5.2 |
$1.40 |
$4.40 |
$5.80 |
|
|
GPT-5.6 Luna |
$1.00 |
$6.00 |
$7.00 |
|
|
Grok 4.3 (высокий контекст) |
$2.50 |
$5.00 |
$7.50 |
|
|
MiMo-V2.5 Pro (>256K) |
$2.00 |
$6.00 |
$8.00 |
|
|
Qwen3.7-Max |
$2.50 |
$7.50 |
$10.00 |
|
|
Gemini 3.5 Flash |
$1.50 |
$9.00 |
$10.50 |
|
|
Gemini 3.1 Pro Preview (≤200K) |
$2.00 |
$12.00 |
$14.00 |
|
|
GPT-5.6 Terra |
$2.50 |
$15.00 |
$17.50 |
|
|
GPT-5.4 |
$2.50 |
$15.00 |
$17.50 |
|
|
Gemini 3.1 Pro Preview (>200K) |
$4.00 |
$18.00 |
$22.00 |
|
|
Claude Opus 4.8 |
$5.00 |
$25.00 |
$30.00 |
|
|
GPT-5.5 |
$5.00 |
$30.00 |
$35.00 |
|
|
GPT-5.5 Instant ( |
$5.00 |
$30.00 |
$35.00 |
|
|
Sakana Fugu Ultra (≤272K) |
$5.00 |
$30.00 |
$35.00 |
|
|
GPT-5.6 Sol |
$5.00 |
$30.00 |
$35.00 |
|
|
Claude Fable 5 / Claude Mythos 5 |
$10.00 |
$50.00 |
$60.00 |
Технологии: более глубокие рассуждения и работа на базе субагентов
Главное техническое изменение в GPT-5.6 заключается в предоставлении модели большего времени и структуры для решения сложных задач на этапе инференса.
OpenAI добавляет новый параметр рассуждений max для GPT-5.6 Sol, ориентированный на проблемы, требующие более глубокого обдумывания.
OpenAI также представляет режим ultra, который задействует субагентов, способных разделять и ускорять выполнение сложных проектов вместо работы в рамках единого агентского потока.
Оценки компании при запуске показывают, что такой подход улучшает производительность в ряде задач агентского типа.
Бенчмарки демонстрируют заметный прогресс по сравнению с GPT-5.5 и новый уровень производительности (state-of-the-art) в задачах командной строки TerminalBench 2.1
Серия GPT-5.6 демонстрирует явный скачок производительности по сравнению с предшественниками в сложных задачах на рассуждение и долгосрочное планирование.

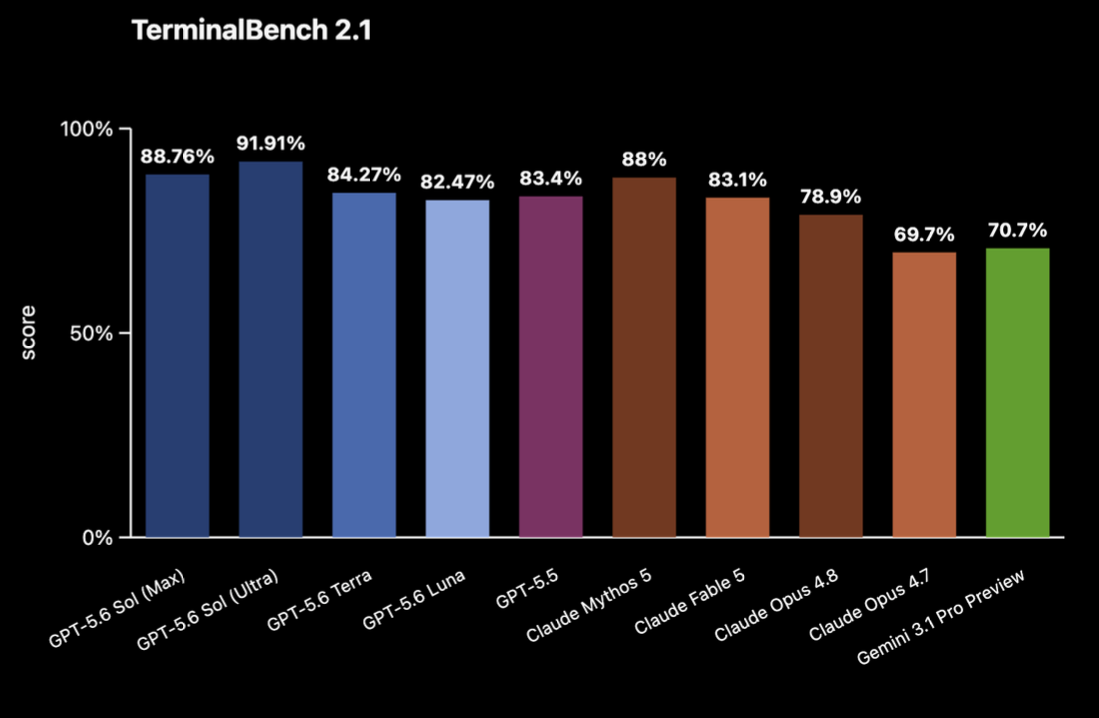
График производительности GPT-5.6 в TerminalBench по сравнению с другими моделями. Источник: OpenAI
В автоматизации командной строки, оцениваемой по тесту TerminalBench 2.1, как флагманская модель Sol, так и модель среднего уровня Terra превосходят результаты предыдущего бенчмарка GPT-5.5. При этом Sol задействовала новый ультра-режим мышления для достижения рекордного результата в 91.91% в бенчмарке, а максимальный режим показал 88.76% — обогнав как показатель GPT-5.5 в 83.4%, так и результаты Claude Mythos 5 на уровне 88%.
Это превосходство распространяется и на профессиональные рабочие процессы в рамках теста Agent’s Last Exam, где Sol стала единственной моделью, успешно преодолевшей экватор выполнения задач с результатом 50.9% в «режиме кода», в то время как повседневная версия Luna также смогла незначительно опередить флагман предыдущего поколения.

Результаты серии GPT-5.6 в бенчмарке Agent’s Last Exam. Источник: OpenAI
В тестах по количественной биологии и геномике модели Sol и Terra достигают более высокой точности, чем GPT-5.5 и GPT-5.4, причем Sol добивается таких результатов, расходуя меньше токенов.
Наконец, в ходе оценок кибербезопасности, измеряющих исследование уязвимостей и эксплуатацию, новые модели преодолевают прежние пределы производительности: Sol достигает значительно более высоких показателей успешных эксплойтов по мере увеличения времени рассуждений и демонстрирует конкурентоспособные возможности, используя лишь малую часть выходных токенов, необходимых старым моделям.
По данным OpenAI, в ExploitBench модель Sol работает на уровне Mythos Preview, генерируя примерно в три раза меньше выходных токенов.

Сравнение производительности OpenAI GPT-5.6 с другими моделями в ExploitBench. Источник: OpenAI
Прогнозируемая механика кэширования промптов и прирост скорости благодаря Cerebras
Чтобы помочь предприятиям контролировать непредсказуемые затраты при запуске агентских циклов, API GPT-5.6 представляет обновленный протокол кэширования промптов.
Теперь разработчики могут внедрять явные точки останова кэша (breakpoints), подкрепленные гарантированным минимальным временем жизни кэша в 30 минут.
В рамках этой концепции первоначальная запись в кэш стоит в 1.25 раза дороже стандартной ставки модели для необработанного входа, в то время как последующее чтение из кэша дает скидку 90%.
На практике компании, выполняющие повторяющиеся или схожие операции, платят больше за создание кэша, но значительно меньше каждый раз при повторном использовании кэшированного контекста в течение как минимум 30-минутного минимального окна кэширования.
Для систем, которые регулярно передают обратно в модель огромные контекстные окна или определения кодовой базы, такая предсказуемость является важнейшим финансовым буфером.
Кроме того, для корпоративных приложений, где задержка (лаг) является основным препятствием для внедрения, в июле этого года OpenAI запускает GPT-5.6 Sol на оборудовании Cerebras.
Это инфраструктурное партнерство заявляет скорость обработки до 750 токенов в секунду, ориентируясь на специализированные корпоративные приложения, требующие рассуждений передового уровня в реальном времени.
Корпоративные последствия: высокий уровень безопасности и алгоритмические барьеры
Для корпоративных инженерных команд, групп информационной безопасности и комплаенса развертывание GPT-5.6 требует тщательного изучения архитектуры безопасности.
Чтобы получить разрешение на релиз, OpenAI выделила около 700 000 часов работы графических процессоров A100e исключительно на автоматизированное тестирование на проникновение (red-teaming) GPT-5.6. Вычислительные мощности были направлены на обнаружение «универсальных джейлбрейков» — системных векторов атак, предназначенных для обхода средств защиты в самых разных контекстах, а не на обходные пути для одиночных запросов.
OpenAI заявляет, что реализовала многоуровневый стек средств защиты, работающий в режиме реального времени, что создает определенные операционные препятствия для команд корпоративной безопасности.
-
Отказы на уровне модели: GPT-5.6 настроена на отклонение запрещенной помощи в киберсфере, включая запросы, которые маскируют вредоносные намерения или пытаются использовать обходные пути в стиле джейлбрейка.
-
Проверка злоупотреблений в реальном времени: Отдельные детекторы кибер- и биологических угроз проверяют генерируемый контент в процессе его создания.
-
Проверка на основе активации: Для моделей Sol и Terra компания OpenAI добавляет классификаторы активации, которые отслеживают внутренние сигналы модели во время инференса. Если эти системы обнаруживают рискованный паттерн, потоковая передача вывода может быть приостановлена до тех пор, пока другая проверка безопасности не оценит контент. Модель Luna, судя по всему, не получает этот слой классификаторов активации, хотя по-прежнему защищена другими системами мониторинга.
-
Паузы для проверки рассуждений: Когда уровень риска кажется повышенным, генерация может остановиться, пока более крупная система рассуждений изучает обмен репликами и окружающий контекст. Если система классифицирует вывод как недопустимый, ответ блокируется до того, как он достигнет эндпоинта.
Поскольку легитимная защитная деятельность — такая как анализ кода, обнаружение уязвимостей, разработка патчей и защитное тестирование — часто использует те же программные примитивы, что и вредоносные эксплойты, в OpenAI признают, что их классификаторы могут регулярно выдавать ложноположительные срабатывания.
В системной карте указано, что стек мониторинга OpenAI показал общую полноту (recall) на уровне 94.8% на наборе биологических тестов и 81.6% на наборе тестов по кибербезопасности. Эти цифры дают предприятиям редкое количественное представление о мерах безопасности, но они также показывают, что система не идеальна и может пропускать некоторые рискованные случаи или блокировать легитимную работу.
Постоянная маркировка запросов может инициировать автоматические проверки на уровне учетной записи по истории диалогов, чтобы оценить, занимается ли корпоративный клиент вредоносной деятельностью или стандартными исследованиями безопасности. В настоящее время OpenAI ведет переговоры о долгосрочных элементах контроля корпоративного комплаенса в сфере безопасности, включая настраиваемые клиентами параметры переопределения безопасности и механизмы конфиденциального обнаружения, чтобы изолировать корпоративные данные от конвейеров ручной проверки.
Важно отметить, что OpenAI подчеркивает: в ходе тестирования модель Sol остается оптимизированной для защитной локализации, а не для наступательного развертывания. В тестах на кодовых базах Chromium и Firefox модель успешно изолировала ошибки и примитивы эксплойтов, но оказалась неспособна автономно спроектировать полноценный рабочий эксплойт, состоящий из цепочки уязвимостей, что позволило удерживать ее ниже порога оповещения организации «Киберкритический» (Cyber Critical).
Однако все три модели GPT-5.6 преодолели внутренний порог кибербезопасности «Высокий» (High) при тестировании в формате capture-the-flag: Sol достигла 96.7%, Terra — 91.84%, а Luna — 85.19%.
Это различие имеет значение для покупателей средств корпоративной безопасности: OpenAI представляет GPT-5.6 как инструмент, достаточно мощный для автоматизации частей исследований уязвимостей и анализа эксплойтов, но еще не как систему, способную надежно проводить полноценную сложную атаку без руководства со стороны человека в условиях испытаний компании.
Геополитика поэтапного релиза
Масштабный запуск серии GPT-5.6 отражает нарастающую взаимосвязь между передовыми лабораториями искусственного интеллекта и протоколами национальной безопасности.
Решение ограничить первоначальный доступ небольшим кругом проверенных партнеров, детали о которых передаются правительству США, продиктовано прямой координацией в рамках развивающейся структуры президентского указа по кибербезопасности. OpenAI предприняла необычный шаг, открыто подвергнув критике подобный государственный контроль в своей официальной документации по анонсу продукта. Компания прямо заявляет:
«Мы не считаем, что подобный процесс правительственного доступа должен стать долгосрочной нормой. Он лишает лучших инструментов пользователей, разработчиков, предприятия, киберзащитников и глобальных партнеров, которые в них нуждаются».
Это напряжение подчеркивает шаткое положение современных технологических предприятий. Хотя организации могут использовать беспрецедентную агентскую эффективность и надежные возможности защитного патчинга с помощью таких бенчмарков, как ExploitGym и ExploitBench, они также должны смириться с тем, что доступ к первоклассным инструментам по-прежнему зависит от дипломатических и регуляторных разрешений.




