


Создание надежных автономных ИИ-агентов


Послушайте, последние 18 месяцев мы занимались созданием производственных систем ИИ и готовы рассказать вам о том, что не дает нам спать по ночам — и это вовсе не способность модели отвечать на вопросы. Это теперь базовый минимум. Нас преследует мысль об агенте, который в 2 часа ночи автономно одобряет шестизначный контракт с поставщиком просто потому, что кто-то опечатался в файле конфигурации.
Мы уже миновали эпоху «оберток над ChatGPT» (слава богу), но индустрия по-прежнему относится к автономным агентам так, будто это просто чат-боты с доступом к API. Это не так. Когда вы предоставляете системе ИИ возможность совершать действия без подтверждения человека, вы переходите фундаментальный рубеж. Вы больше не создаете полезного помощника — вы создаете нечто, больше похожее на сотрудника. И это полностью меняет подход к проектированию таких систем.
Проблема автономности, о которой никто не говорит
Самое удивительное здесь то, что мы научились делать модели, которые *звучат* уверенно. Но уверенность и надежность — это не одно и то же, и разрыв между ними — это то место, где погибают производственные системы.
Мы усвоили это на собственном горьком опыте во время пилотной программы, в рамках которой позволили ИИ-агенту управлять расписанием команд руководителей. Кажется, все просто, верно? Агент мог проверять доступность, рассылать приглашения, разрешать конфликты. Однако в один прекрасный понедельник он перенес заседание совета директоров, потому что интерпретировал фразу «давайте сдвинем это при необходимости» в сообщении Slack как прямое указание к действию. Интерпретация модели не была ошибочной — она выглядела правдоподобно. Но правдоподобность не имеет значения, когда речь идет об автономности.
Этот инцидент научил нас важному выводу: главная сложность заключается вовсе не в том, чтобы создать работающих агентов в большинстве случаев. Задача в том, чтобы создать агентов, которые корректно сбоят, осознают свои ограничения и оснащены предохранителями для предотвращения катастрофических ошибок.
Что на самом деле означает надежность для автономных систем
Изображение предоставлено авторами.
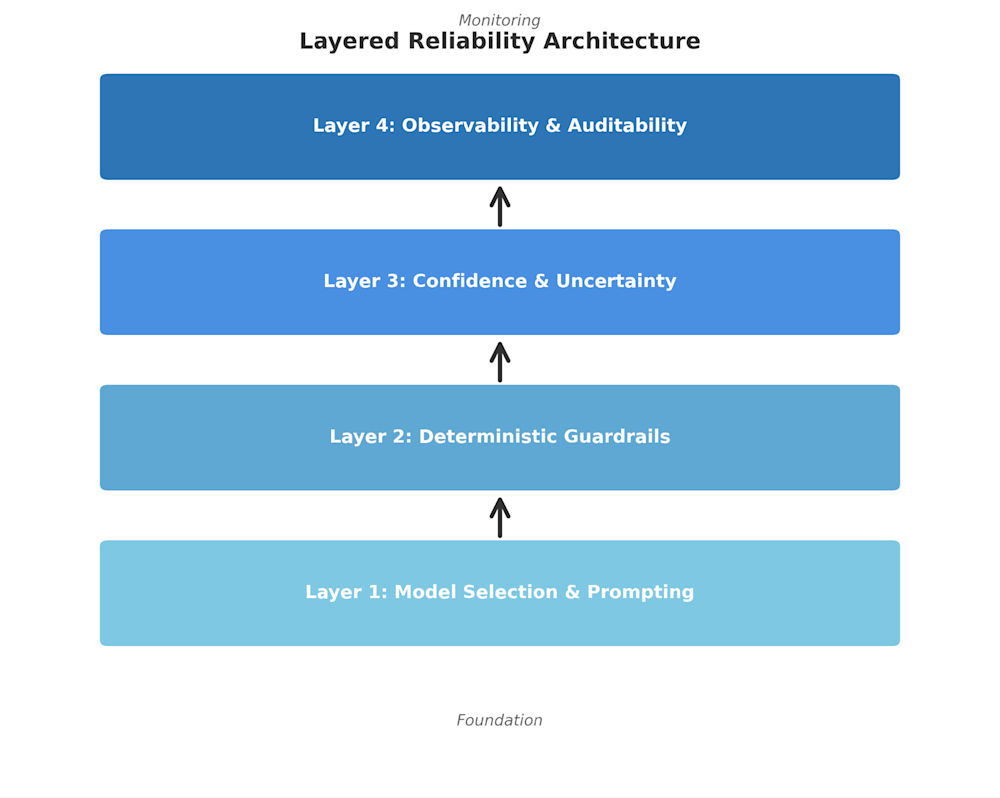
Многоуровневая архитектура надежности
Когда мы говорим о надежности в традиционной разработке программного обеспечения, у нас есть десятилетиями проверенные паттерны: избыточность, повторные попытки, идемпотентность, безопасная деградация (graceful degradation). Но ИИ-агенты разрушают многие из наших привычных предположений.
Традиционное ПО ложится предсказуемо. Вы можете писать модульные тесты. Вы можете отслеживать пути выполнения. В случае с ИИ-агентами вы имеете дело с вероятностными системами, принимающими оценочные суждения. Ошибка — это не просто логический сбой, это ситуация, когда модель галлюцинирует звучать правдоподобно, но выдает полностью сфабрикованную конечную точку API или неверно истолковывает контекст способом, который технически парсится, но совершенно упускает из виду намерения человека.
Так как же выглядит надежность в данном случае? По нашему опыту, это многоуровневый подход.
Уровень 1: Выбор модели и промпт-инжиниринг
Это фундаментальный, но недостаточный шаг. Да, используйте лучшую модель, которую можете себе позволить. Да, тщательно составляйте запросы (промпты), используя примеры и ограничения. Но не обманывайте себя мыслью, что отличного промпта достаточно. Я видел слишком много команд, которые запускали «GPT-4 с действительно хорошим системным промптом» и называли это готовым к внедрению на уровне предприятия решением.
Уровень 2: Детерминированные защитные барьеры (guardrails)
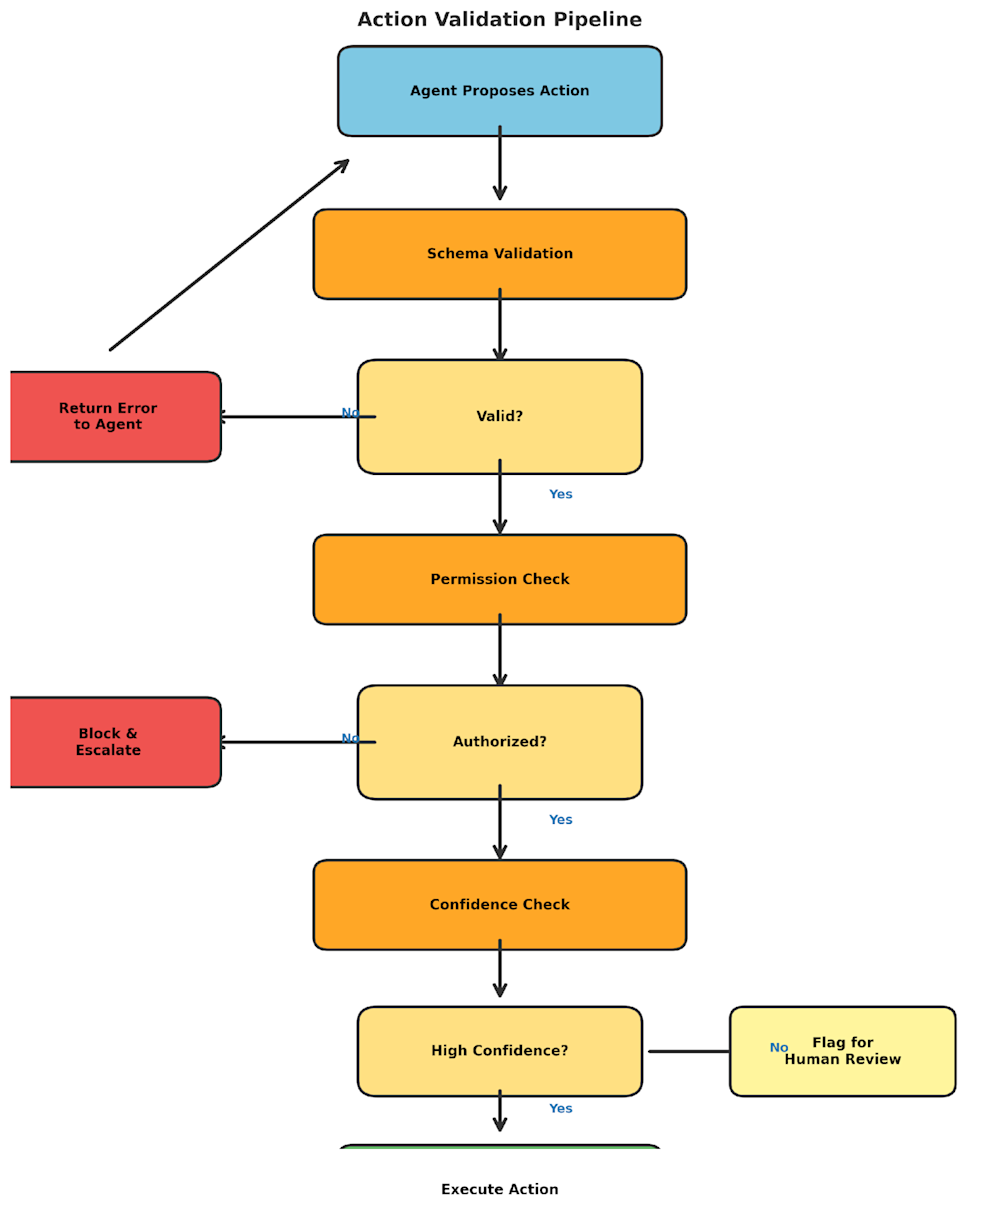
Прежде чем модель предпримет какие-либо необратимые действия, пропустите ее через жесткие проверки. Пытается ли она получить доступ к ресурсу, к которому не должна? Находятся ли действия в допустимых параметрах? Речь идет о старомодной логике валидации — регулярных выражениях, проверке схем, списках разрешенных элементов. Это не звучит модно, но это эффективно.
Один паттерн, который хорошо себя зарекомендовал: ведение формальной схемы действий. Каждое действие, которое может совершить агент, имеет определенную структуру, обязательные поля и правила валидации. Агент предлагает действия в рамках этой схемы, и мы проверяем их перед выполнением. Если валидация не проходит, мы не просто блокируем действие — мы возвращаем ошибки валидации обратно агенту, позволяя ему повторить попытку с учетом понимания того, что пошло не так.
Уровень 3: Количественная оценка уверенности и неопределенности
Вот где начинается самое интересное. Нам нужны агенты, которые знают, чего они не знают. Мы экспериментируем с агентами, способными явно рассуждать о своей уверенности перед совершением действий. Это не просто показатель вероятности, а реально сформулированная неопределенность: «Я интерпретирую это письмо как запрос на запуск проекта с задержкой, но формулировка двусмысленна и также может означать…»
Это не предотвращает все ошибки, но создает естественные точки останова, где можно подключить человеческий контроль. Действия с высокой степенью уверенности проходят автоматически. Действия со средней уверенностью отправляются на рассмотрение. Действия с низкой уверенностью блокируются с объяснением причин.
Уровень 4: Наблюдаемость (observability) и аудируемость
Конвейер проверки действий
Если вы не можете это отладить, вы не можете этому доверять. Каждое решение, принимаемое агентом, должно подлежать логированию, отслеживанию и объяснению. Не просто «какое действие он совершил», но и «о чем он думал, какие данные учитывал, какова была цепочка рассуждений?»
Мы создали пользовательскую систему логирования, которая фиксирует все взаимодействие с большой языковой моделью (LLM) — промпт, ответ, окно контекста и даже настройки температуры модели. Это чертовски подробный лог, но когда что-то идет не так (а это обязательно случится), вы должны иметь возможность точно восстановить произошедшее. Кроме того, это становится вашим датасетом для дообучения и улучшений.
Защитные барьеры: искусство говорить «нет»
Давайте поговорим о защитных барьерах (guardrails), потому что здесь по-настоящему важна инженерная дисциплина. Многие команды относятся к защитным барьерам как к чему-то второстепенному — «добавим пару проверок безопасности, если понадобится». Это в корне неверно. Защитные барьеры должны быть вашей отправной точкой.
Мы делим защитные барьеры на три категории.
Границы полномочий (Permission boundaries)
Что агенту разрешено делать физически? Это ваш контроль зоны поражения (blast radius). Даже если у агента возникнет худшая из возможных галлюцинаций, каков максимальный ущерб, который он может нанести?
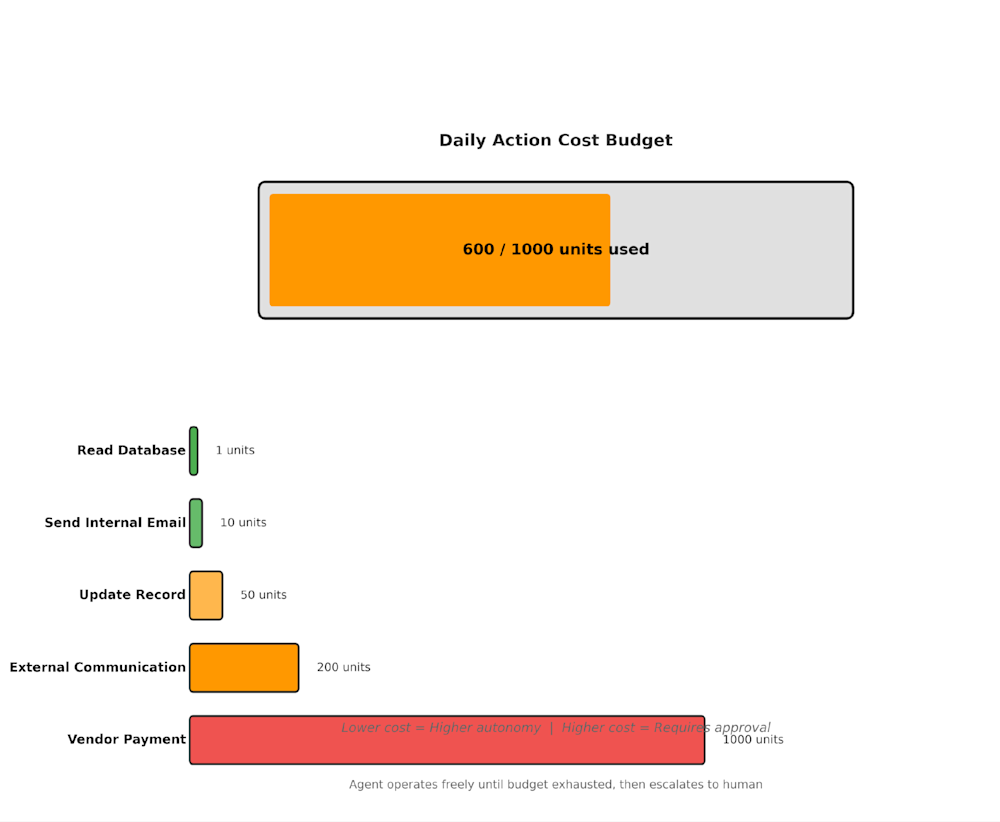
Мы используем принцип «постепенной автономии». Новые агенты начинают с доступа только для чтения. По мере того как они доказывают свою надежность, они переходят к операциям записи с низким риском (создание записей в календаре, отправка внутренних сообщений). Действия с высоким риском (финансовые транзакции, внешние коммуникации, удаление данных) либо требуют явного одобрения человека, либо просто закрыты для них.
Один из хорошо зарекомендовавших себя методов — бюджеты стоимости действий. У каждого агента есть дневной «бюджет», выраженный в единицах риска или затрат. Чтение записи из базы данных стоит 1 единицу. Отправка электронного письма стоит 10. Инициирование платежа поставщику стоит 1000. Агент может действовать автономно, пока не исчерпает свой бюджет; после этого требуется вмешательство человека. Это создает естественный ограничитель потенциально проблемного поведения.
Постепенная автономия и бюджет стоимости действий
Семантические границы (Semantic boundaries)
Что агент должен понимать как входящее или выходящее за рамки его компетенции? Это сложнее, поскольку носит концептуальный, а не только технический характер.
Я обнаружил, что четкие определения доменов очень помогают. Наш агент службы поддержки имеет четкий мандат: обрабатывать вопросы по продуктам, оформлять возвраты, эскалировать жалобы. Все, что выходит за рамки этого домена — запросы на инвестиционные советы, техническая поддержка сторонних продуктов, личные одолжения — получает вежливый отказ и эскалацию.
Задача заключается в том, чтобы сделать эти границы устойчивыми к промпт-инъекциям и попыткам взлома (jailbreaking). Пользователи будут пытаться убедить агента помочь с нерелевантными запросами. Другие части системы могут непреднамеренно передавать инструкции, переопределяющие границы агента. Здесь вам потребуется несколько уровней защиты.
Операционные границы (Operational boundaries)
Как много агент может сделать и как быстро? Это ограничение частоты запросов (rate limiting) и контроль ресурсов.
Мы внедрили жесткие лимиты на все: вызовы API в минуту, максимальное количество токенов за взаимодействие, максимальную стоимость в день, максимальное количество повторных попыток до эскалации на человека. Это может показаться искусственными ограничениями, но они необходимы для предотвращения неконтролируемого поведения.
Однажды мы видели, как агент застрял в цикле, пытаясь разрешить конфликт в расписании. Он продолжал предлагать время, получать отказы и пробовать снова. Без ограничения частоты запросов он отправил 300 приглашений в календарь за час. При наличии надлежащих операционных границ он достиг бы порогового значения и эскалировал задачу на человека после 5-й попытки.
Агентам нужен собственный стиль тестирования
Традиционное тестирование программного обеспечения не подходит для автономных агентов. Вы не можете просто написать тест-кейсы, покрывающие все крайние случаи (edge cases), потому что с языковыми моделями каждый случай — крайний.
Что сработало для нас:
Среды симуляции
Создайте песочницу (sandbox), зеркально отражающую продакшн, но с фальшивыми данными и макетными сервисами. Позвольте агенту действовать свободно. Посмотрите, что ломается. Мы делаем это постоянно — каждое изменение кода проходит через 100 смоделированных сценариев, прежде чем попасть в продакшн.
Главное — сделать сценарии реалистичными. Не тестируйте только благоприятные сценарии (happy paths). Симулируйте злых клиентов, двусмысленные запросы, противоречивую информацию, сбои в системе. Добавьте несколько состязательных (adversarial) примеров. Если ваш агент не справляется с тестовой средой, где что-то идет не так, он точно не справится с продакшном.
Красные команды (Red teaming)
Привлекайте креативных людей, чтобы попытаться сломать вашего агента. Не только специалистов по безопасности, но и экспертов в предметной области, понимающих бизнес-логику. Некоторые из наших лучших улучшений были предложены сотрудниками отдела продаж, которые пытались «обмануть» агента, заставив его делать то, чего делать не следует.
Теневой режим (Shadow mode)
Прежде чем запускаться в реальном времени, запустите агента в теневом режиме параллельно с людьми. Агент принимает решения, но реальные действия выполняют люди. Вы фиксируете в логах как выбор агента, так и выбор человека, а затем анализируете дельту.
Это утомительно и медленно, но оно того стоит. Вы обнаружите самые разные скрытые несоответствия, которые никогда не отловите при тестировании. Возможно, агент технически дает правильный ответ, но формулирует его в манере, нарушающей стандарты тональности компании. Возможно, он принимает юридически верные, но сомнительные с точки зрения этики решения. Теневой режим выявляет эти проблемы до того, как они станут реальными.
Паттерн «человек в контуре» (Human-in-the-loop)
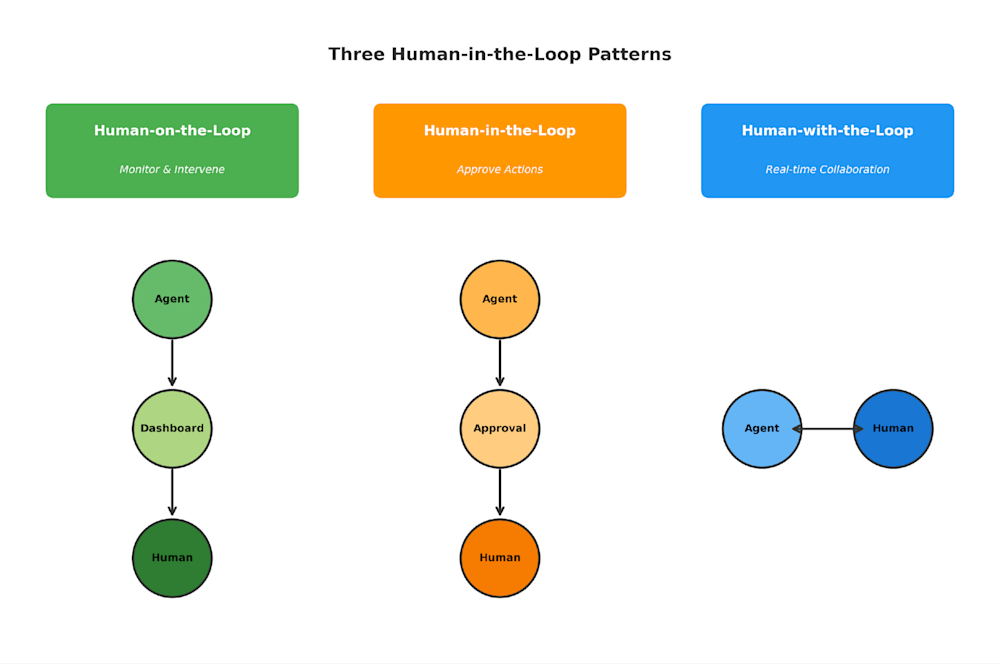
Три паттерна участия человека в контуре
Несмотря на всю автоматизацию, люди остаются незаменимыми. Вопрос в том: где именно они должны находиться в этом контуре?
Мы все больше убеждаемся, что концепция «человек в контуре» на самом деле распадается на несколько отдельных паттернов:
Человек над контуром (Human-on-the-loop): Агент работает автономно, но люди мониторят дашборды и могут вмешаться. Это стандартный режим для хорошо изученных операций с низким риском.
Человек в контуре (Human-in-the-loop): Агент предлагает действия, люди их одобряют. Это режим «учебных колес» на время, пока агент доказывает свою состоятельность, а также постоянный режим для операций с высоким риском.
Человек вместе с контуром (Human-with-the-loop): Агент и человек сотрудничают в реальном времени, выполняя каждый то, что у него получается лучше. Агент выполняет черновую работу, человек принимает оценочные суждения.
Вся сложность заключается в том, чтобы сделать эти переходы плавными. Агент не должен казаться совершенно другой системой при переходе из автономного режима в режим с надзором. Интерфейсы, логирование и пути эскалации должны быть единообразными.
Режимы отказов и восстановление
Будем честны: ваш агент потерпит неудачу. Вопрос в том, произойдет ли это изящно или катастрофически.
Мы классифицируем сбои на три категории:
Устранимые ошибки (Recoverable errors): Агент пытается что-то сделать, это не работает, агент понимает, что ничего не вышло, и пробует что-то другое. Это нормально. Именно так функционируют сложные системы. Пока агент не делает ситуацию хуже, позволяйте ему повторять попытки с экспоненциальной задержкой.
Обнаруживаемые сбои (Detectable failures): Агент делает что-то не так, но системы мониторинга замечают это до того, как будет нанесен значительный ущерб. Вот тут-то ваши защитные барьеры и наблюдаемость приносят свои плоды. Агент откатывается, люди проводят расследование, вы устраняете проблему.
Необнаруживаемые сбои (Undetectable failures): Агент делает что-то не так, и никто не замечает этого до гораздо более позднего момента. Вот это действительно страшно. Возможно, он неделями неверно истолковывал запросы клиентов. Возможно, он вносил едва заметные некорректные данные. Все это накапливается в системные проблемы.
Защитой от необнаруживаемых сбоев является регулярный аудит. Мы случайным образом выбираем действия агента и просим людей проверить их. Это не просто проверка на прошел/не прошел, а детальный анализ. Демонстрирует ли агент какое-либо отклонение в поведении? Есть ли паттерны в его ошибках? Не развиваются ли у него какие-либо вызывающие беспокойство тенденции?
Компромисс между стоимостью и производительностью
Вот о чем говорят недостаточно часто: надежность стоит дорого.
Каждый защитный барьер добавляет задержку. Каждый шаг валидации требует вычислительных ресурсов. Множественные вызовы моделей для проверки уверенности увеличивают затраты на API. Комплексное логирование генерирует огромные объемы данных.
Вы должны подходить к инвестициям стратегически. Не каждый агент нуждается в одинаковом уровне надежности. Генератор маркетинговых текстов может быть менее строгим, чем процессор финансовых транзакций. Помощник по планированию может повторять попытки более свободно, чем система развертывания кода.
Мы используем подход, основанный на рисках. Агенты с высоким уровнем риска получают все средства защиты, множество уровней валидации и масштабный мониторинг. Агенты с более низким уровнем риска получают более легкие средства защиты. Главное — четко осознавать эти компромиссы и документировать, почему у каждого конкретного агента установлены именно такие защитные барьеры.
Организационные проблемы
Было бы упущением не упомянуть, что самые сложные задачи кроются не в технической плоскости — они организационные.
Кто несет ответственность за агента, когда он совершает ошибку? Это команда инженеров, которая его создала? Подразделение, которое его развернуло? Человек, который должен был осуществлять за ним надзор?
Как поступать в пограничных ситуациях, когда логика агента технически верна, но не уместна в контексте? Если агент следует своим правилам, но нарушает неписаную норму, кто виноват?
Каков ваш процесс реагирования на инциденты, когда агент «слетает с катушек»? Традиционные инструкции (runbooks) рассчитаны на ошибки операторов-людей. Как адаптировать их для автономных систем?
На эти вопросы нет универсальных ответов, но их необходимо решить до запуска. Четкое распределение ответственности, задокументированные пути эскалации и четко определенные показатели успеха так же важны, как и техническая архитектура.
Куда мы движемся дальше
Индустрия все еще разбирается с этим. Не существует готового руководства по созданию надежных автономных агентов. Мы все учимся в условиях продакшна, и это одновременно захватывает и пугает.
Что мы знаем наверняка: преуспеют те команды, которые относятся к этому как к инженерной дисциплине, а не просто как к проблеме ИИ. Вам понадобятся традиционные строгости программной инженерии — тестирование, мониторинг, реагирование на инциденты — в сочетании с новыми методами, специфичными для вероятностных систем.
Вам нужно быть параноиком, но не парализованным страхом. Да, автономные агенты могут давать сбои впечатляющими способами. Но с надлежащими защитными барьерами они также способны справляться с огромными объемами работы со сверхчеловеческой стабильностью. Главное — уважать риски и одновременно принимать открывающиеся возможности.
Мы оставим вас с мыслью: каждый раз, когда мы развертываем новую автономную функцию, мы проводим пре-мортем (анализ возможных неудач до запуска). Мы представляем, что прошло шесть месяцев и агент спровоцировал серьезный инцидент. Что произошло? Какие предупреждающие знаки мы упустили? Какие защитные барьеры подвели?
Это упражнение спасало нас больше раз, чем мы можем сосчитать. Оно заставляет продумать сценарии отказов до того, как они произойдут, выстроить защитные механизмы до того, как они понадобятся, и подвергнуть сомнению предположения до того, как они ударят по вам.
Потому что в конце концов, создание автономных ИИ-агентов корпоративного уровня — это не создание систем, которые работают идеально. Это создание систем, которые безопасно сбоят, изящно восстанавливаются и непрерывно учатся.
И именно такой инжиниринг по-настоящему имеет значение.
Мадхвеш Кумар — ведущий инженер. Дипика Сингх — старший инженер-программист.
Высказанные мнения основаны на практическом опыте создания и развертывания автономных агентов, а также на тех редких случаях ликвидации инцидентов в 3 часа ночи, которые заставляют вас усомниться в выборе карьеры.
Добро пожаловать в сообщество VentureBeat!
Наша программа гостевых публикаций — это место, где технические эксперты делятся идеями и публикуют беспристрастные, независимые глубокие обзоры об ИИ, инфраструктуре данных, кибербезопасности и других передовых технологиях, формирующих будущее корпоративного сектора.
Читайте далее материалы нашей программы гостевых публикаций и ознакомьтесь с нашими рекомендациями, если вы хотите внести свой вклад в виде собственной статьи!




