


ИИ меняет подход к интерпретации веб-трафика
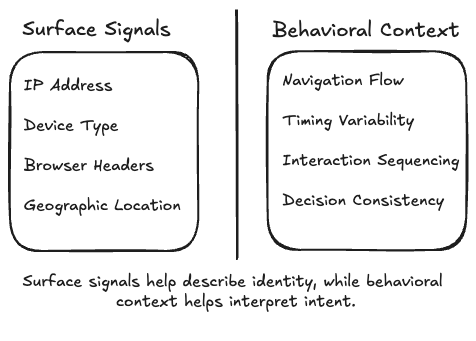


Более двух десятилетий цифровой бизнес опирался на простое предположение: когда кто-то взаимодействует с веб-сайтом, эта активность отражает осознанный выбор человека. Кликанье рассматривается как сигнал интереса. Время на странице считается показателем вовлеченности. Перемещение по воронке интерпретируется как намерение. На этой предпосылке были построены целые стратегии роста, маркетинговые бюджеты и продуктовые решения.
Сегодня это предположение начинает незаметно разрушаться.
Поскольку инструменты на базе ИИ все чаще взаимодействуют с интернетом от имени пользователей, многие сигналы, от которых зависят организации, становится все труднее интерпретировать. Сами данные остаются точными — страницы просматриваются, кнопки нажимаются, действия фиксируются, — но смысл, стоящий за этими действиями, меняется. Этот сдвиг не носит теоретический характер и не ограничивается краевыми случаями. Он уже влияет на то, как руководители читают дашборды, прогнозируют спрос и оценивают производительность.
Предстоящая задача заключается не в том, чтобы остановить взаимодействия, управляемые ИИ. Она заключается в том, чтобы научиться интерпретировать цифровое поведение в мире, где человеческая и автоматизированная активность все больше пересекаются.
Меняющееся представление о веб-трафике
На протяжении десятилетий фундамент интернета покоился на тихой, ориентированной на человека модели. За каждым скроллом, отправкой формы или процессом покупки стоял человек, движимый любопытством, необходимостью или намерением. Аналитические платформы развивались так, чтобы фиксировать эти типы поведения. Системы безопасности были сосредоточены на отделении «легитимных пользователей» от четко прописанных сценариев автоматизации. Даже экономика цифровой рекламы исходила из того, что вовлеченность равна человеческому вниманию.
За последние несколько лет эта модель начала меняться. Достижения в области больших языковых моделей (LLM), автоматизации браузеров и агентов на базе ИИ позволили программным системам перемещаться по сети способами, которые кажутся естественными и учитывающими контекст. Страницы изучаются, варианты сравниваются, рабочие процессы завершаются — зачастую без явных признаков автоматизации.
Это не значит, что веб становится менее человечным. Скорее, он становится более гибридным. Системы ИИ все глубже интегрируются в повседневные рабочие процессы, выступая в роли ассистентов по исследованиям, инструментов для сравнения или исполнителей задач от имени людей. В результате грань между человеком, напрямую взаимодействующим с сайтом, и ПО, действующим за него, стирается.
Проблема заключается не в самой автоматизации. Проблема в двусмысленности, которую это пересечение привносит в сигналы, на которые опираются компании.
Что мы имеем в виду под трафиком, сгенерированным ИИ?
Когда люди слышат «автоматизированный трафик», они часто думают о ботах прошлого — жестких скриптах, которые следовали заранее определенным путям и ломались в тот момент, когда менялся интерфейс. Те системы были повторяющимися, предсказуемыми и относительно простыми для идентификации.
Трафик, сгенерированный ИИ, устроен иначе.
Современные ИИ-агенты сочетают машинное обучение (ML) с возможностями автоматизированного просмотра страниц. Они умеют интерпретировать макеты страниц, адаптироваться к изменениям интерфейса и выполнять многошаговые задачи. Во многих случаях языковые модели направляют процесс принятия решений, позволяя этим системам корректировать поведение на основе контекста, а не фиксированных правил. В результате получается взаимодействие, которое выглядит гораздо более естественным, чем ранняя автоматизация.
Важно отметить, что такой трафик сам по себе не является проблематичным. Автоматизация уже давно играет продуктивную роль в интернете: от поисковой индексации и инструментов доступности (accessibility) до фреймворков тестирования и интеграций. Новые ИИ-агенты просто продолжают эту эволюцию, помогая пользователям суммировать контент, сравнивать продукты или собирать информацию на разных сайтах.
Дело не в намерениях, а в интерпретации. Когда ИИ-агенты успешно взаимодействуют с сайтом от имени пользователей, традиционные метрики вовлеченности могут больше не отражать тот смысл, который они несли раньше.
Почему трафик, созданный ИИ, становится все труднее отличить
Исторически обнаружение автоматизированной активности опиралось на выявление технических аномалий. Системы фиксировали поведение, которое двигалось слишком быстро, следовало абсолютно постоянным маршрутам или не имело стандартных функций браузера. Автоматизация выдавала себя «маркерами», делавшими классификацию простой.
Системы на базе ИИ меняют эту динамику. Они работают через стандартные браузеры. Они делают паузы, прокручивают страницы и перемещаются нелинейно. Они варьируют тайминги и последовательности взаимодействий. Поскольку эти агенты созданы для взаимодействия с интернетом в том виде, в каком он был построен — для людей, — их поведение все сильнее сливается с обычными паттернами использования.
В результате задача смещается от выявления ошибок к интерпретации поведения. Вопрос уже не столько в том, является ли взаимодействие автоматизированным, сколько в том, как оно разворачивается во времени. Многие сигналы, которые раньше разделяли людей и программное обеспечение, сходятся воедино, делая бинарную классификацию менее эффективной.
Когда вовлеченность перестает означать то, что мы думаем
Рассмотрим типичный сценарий в электронной коммерции.
Команда ритейлера замечает устойчивый рост просмотров товаров и действий «добавить в корзину». Исторически это было бы четким сигналом растущего спроса, побуждающим увеличить рекламный бюджет или расширить запасы.
Теперь представьте, что часть этой активности создается ИИ-агентами, выполняющими мониторинг цен или сравнение продуктов от имени пользователей. Взаимодействия произошли. Метрики точны. Но базовое намерение другое. Воронка больше не представляет собой прямой путь к покупке.
С данными «все в порядке», но смысл изменился.
Подобные паттерны проявляются в самых разных отраслях:
-
Цифровые издатели видят всплески вовлеченности в статьи без соразмерного рекламного дохода.
-
SaaS-компании наблюдают активное изучение функций при ограниченном числе конверсий.
-
Туристические платформы фиксируют рост поисковой активности, которая не перерастает в бронирования.
В каждом случае организации рискуют заниматься оптимизацией ради активности, а не ради ценности.
Почему это проблема данных и аналитики
По своей сути трафик, сгенерированный ИИ, вносит неопределенность в предположения, лежащие в основе аналитики и моделирования. Многие системы исходят из того, что наблюдаемое поведение четко соотносится с намерениями человека. Когда в наборы данных примешиваются автоматизированные взаимодействия, это предположение слабеет.
Поведенческие данные теперь могут включать в себя:
-
Изучение без намерения совершить покупку
-
Навигацию, обусловленную исследованием
-
Выполнение задач без конверсии
-
Повторяющиеся паттерны, продиктованные целями автоматизации
Для аналитических команд это привносит шум в метки, ослабляет прокси-метрики и увеличивает риск возникновения циклов обратной связи. Модели, обученные на смешанных сигналах, могут научиться оптимизировать объем вместо результатов, которые действительно важны для бизнеса.
Это не обесценивает аналитику. Это поднимает планку требований к интерпретации.
Целостность данных в мире машин
Поскольку поведенческие данные все сильнее подпитывают системы машинного обучения, которые формируют пользовательский опыт, состав этих данных имеет решающее значение. Если растущая доля взаимодействий исходит от автоматизированных агентов, платформы могут начать оптимизироваться под машинную навигацию, а не под человеческий опыт.
Со временем это может незаметно изменить облик интернета. Интерфейсы могут стать эффективными для извлечения данных и создания сводок, но при этом потеряют те «неправильности», которые делают их интуитивными или привлекательными для людей. Сохранение значимого человеческого сигнала требует выхода за рамки простого подсчета объемов и концентрации на контексте взаимодействия.
От исключения к интерпретации
Годами реакцией по умолчанию на автоматизацию было ее исключение. CAPTCHA, ограничения по частоте запросов (rate limits) и статические пороги работали хорошо, когда автоматизированное поведение было четко отделимо.
Этот подход становится все менее эффективным. ИИ-агенты часто приносят реальную пользу пользователям, и огульная блокировка может ухудшить пользовательский опыт, не улучшив результаты. В результате многие организации переходят от исключения к интерпретации.
Вместо того чтобы думать о том, как не пустить автоматизацию, команды задаются вопросом, как понимать различные типы трафика и соответствующим образом реагировать на них — предлагая опыт, соответствующий конкретным целям, не полагаясь на единственное определение легитимности.
Поведенческий контекст как дополнительный сигнал
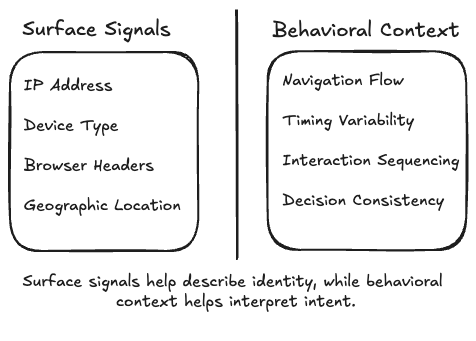
Один из перспективных подходов заключается в сосредоточении внимания на поведенческом контексте. Вместо того чтобы строить анализ вокруг идентификации личности, системы изучают, как взаимодействия разворачиваются во времени.
Человеческое поведение непоследовательно и неэффективно. Люди колеблются, возвращаются назад и исследуют пространство непредсказуемо. Автоматизированные агенты, даже будучи адаптивными, склонны демонстрировать более структурированную внутреннюю логику. Наблюдая за навигационным потоком, вариативностью таймингов и последовательностью взаимодействий, команды могут делать выводы о намерениях вероятностным, а не категоричным путем.
Это позволяет организациям оставаться открытыми, получая при этом более тонкое понимание активности.
Изображение создано автором.
Этика, конфиденциальность и ответственная интерпретация
По мере того как анализ становится все более сложным, этические границы приобретают все большую важность. Понимание паттернов взаимодействия — это не то же самое, что отслеживание конкретных людей.
Наиболее устойчивые подходы опираются на агрегированные, анонимизированные сигналы и прозрачные практики. Цель состоит в том, чтобы защитить целостность платформы, уважая при этом ожидания пользователей. Доверие остается фундаментальным требованием, а не второстепенной мыслью.
Будущее: спектр автономности
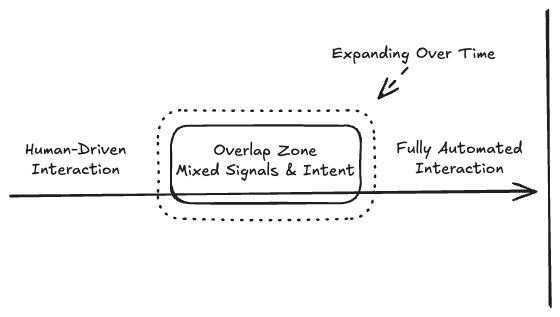
Заглядывая в будущее, мы видим, что веб-взаимодействия все больше располагаются вдоль определенного спектра. На одном конце люди просматривают страницы напрямую, посередине пользователи получают помощь от инструментов ИИ, а на другом — агенты действуют независимо от имени пользователя.
Эта эволюция отражает взросление цифровой экосистемы. Она также требует изменения подхода к оценке успеха. Простых подсчетов кликов или визитов уже недостаточно. Ценность должна оцениваться в контексте.
Изображение создано автором.
На чем бизнес-лидерам следует сосредоточиться сейчас
Трафик, сгенерированный ИИ — это не проблема, от которой нужно избавиться, это реальность, которую необходимо понять.
Лидеры, которые успешно адаптируются:
Пересмотрят то, как интерпретируются метрики вовлеченности
Отделят активность от намерений при аналитических обзорах
Инвестируют в контекстные и вероятностные методы измерения
Сохранят качество данных по мере роста участия ИИ
Будут относиться к доверию и конфиденциальности как к принципам проектирования
Интернет уже эволюционировал раньше, и он будет эволюционировать снова. Вопрос в том, готовы ли организации изменить то, как они считывают производимые им сигналы.
Шашват Джайн (Shashwat Jain) — старший инженер-программист в Amazon.
Добро пожаловать в сообщество VentureBeat!
Наша программа гостевых публикаций — это место, где технические эксперты делятся идеями и предоставляют нейтральные, непредвзятые глубокие обзоры об ИИ, инфраструктуре данных, кибербезопасности и других передовых технологиях, формирующих будущее бизнеса.
Читайте далее в рамках нашей программы гостевых постов и ознакомьтесь с нашими рекомендациями, если вы хотите опубликовать собственную статью!




