


GraphRAG повышает точность многошаговых ответов на вопросы на 20%


Предоставлено автором
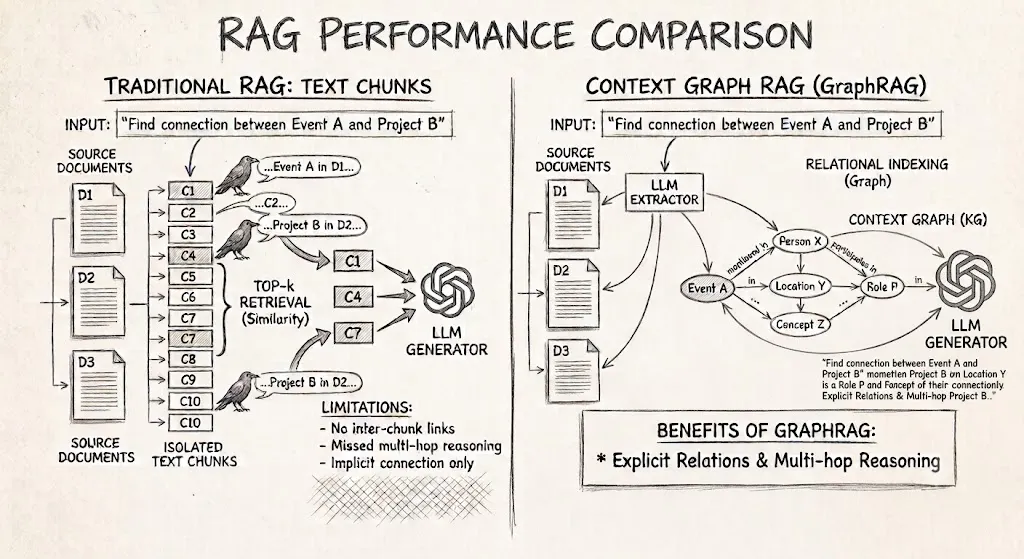
Если за последние два года вы создавали что-либо с использованием поисково-дополненной генерации (RAG), вы наверняка столкнулись с ее главным разочарованием: вы разбиваете документы на фрагменты, векторизуете их, извлекаете несколько наиболее похожих на ваш вопрос фрагментов и передаете их модели. Для задачи вроде «Какова была наша политика возврата средств в третьем квартале?» это работает великолепно. Для задачи «Каковы повторяющиеся темы в отзывах клиентов за два года?» этот подход терпит крах, поскольку ни один отдельный фрагмент не содержит ответа целиком.
Модное средство решения этой проблемы — GraphRAG: вместо того чтобы скармливать модели разрозненные фрагменты, вы сначала строите граф знаний об имеющихся в вашем корпусе сущностях и связях между ними, а затем используете эту структуру в качестве контекста. Такой подход звучит соблазнительно. Но соблазнительные идеи заслуживают проверки, поэтому я изучил факты — оригинальную статью Microsoft, а также четыре независимых бенчмарк-исследования — чтобы ответить на простой вопрос: действительно ли ответы становятся лучше, если заменить текстовые фрагменты графом контекста?
Короткий ответ: да, существенно — но лишь для определенного типа вопросов и не бесплатно. Позвольте мне представить доказательства.
Почему текстовые фрагменты упираются в тупик
Стандартный векторный RAG извлекает k отрывков, наиболее близких к вашему запросу. Такая архитектура имеет три структурных «слепых пятна»:
-
Он не умеет сопоставлять факты. Когда для ответа требуется объединить факты из разных частей текста через общую сущность, изолированные друг от друга фрагменты никогда не покажут эту связь.
-
Он слеп к глобальным вопросам. Вопрос «Каковы основные темы?» требует анализа всего корпуса документов, однако поиск по сходству возвращает лишь горстку фрагментов, которые лишь поверхностно напоминают запрос.
-
Он разрывает контекст на границах фрагментов. Отношения и иерархия, от которых зависит сложное логическое мышление, — это как раз то, что отбрасывается при разбиении на куски.
Подразделение Microsoft Research сформулировало это предельно четко при представлении GraphRAG: базовый RAG «испытывает трудности с объединением разрозненных фактов» и плохо справляется с задачами «целостного понимания обобщенных семантических концепций на больших объемах данных».
Что меняет граф контекста
GraphRAG решает проблему еще до того, как задан какой-либо вопрос. На этапе индексации большая языковая модель (LLM) читает каждый фрагмент, извлекает сущности, связи и утверждения, собирая их утяжеленный граф знаний. Затем запускается алгоритм обнаружения сообществ (алгоритм Лейдена), который разбивает граф на иерархию связанных тем и заранее записывает резюме на естественном языке для каждого сообщества.
Во время запроса именно эти резюме выполняют основную работу. Каждое релевантное сообщество формирует частичный ответ (шаг «map» — сопоставление), частичные ответы ранжируются и объединяются (шаг «reduce» — свертка), а модель синтезирует окончательный ответ, опираясь на структуру, а не на несколько выхваченных наугад отрывков. Альтернативные варианты, такие как HippoRAG, идут другим путем, используя граф в сочетании с обходом Personalized PageRank для поиска нужных отрывков — но суть остается прежней: позвольте связям, а не только косинусному сходству, определять, какой контекст видит модель.
Доказательства: Четыре исследования, одна закономерность
1. Глобальное осмысление: Главная победа
Компания Microsoft противопоставила GraphRAG наивному RAG при ответах на глобальные вопросы типа «осмыслить весь корпус целиком» на датасетах размером в миллионы токенов, причем LLM выступала в роли судьи по трем осям: полнота, разнообразие и информативность.
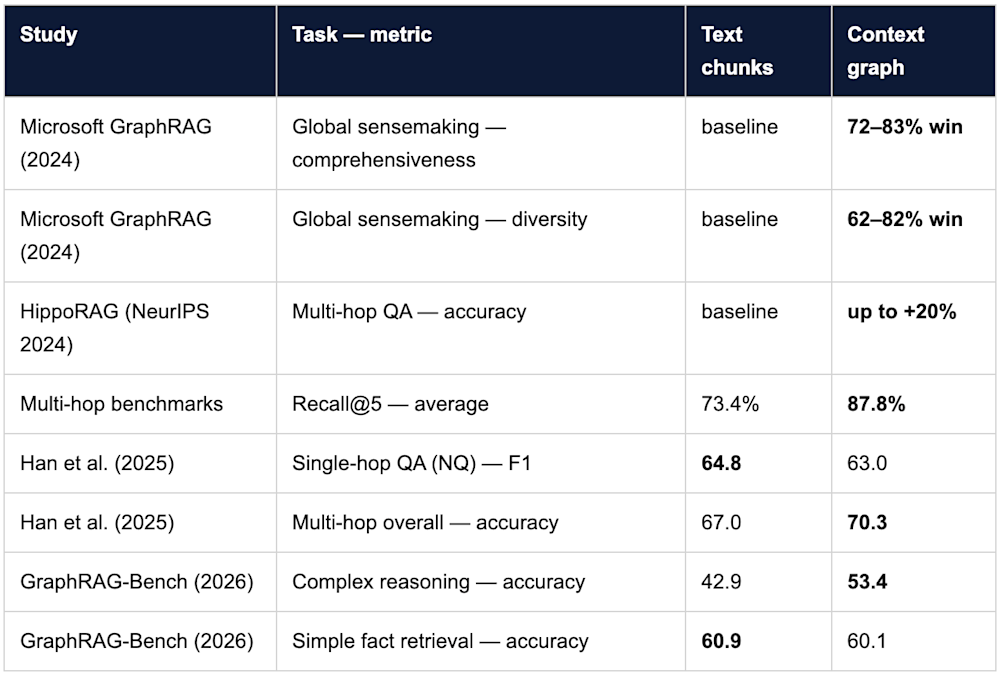
GraphRAG победил в 72–83% сравнений по полноте и в 62–82% сравнений по разнообразию по сравнению с векторным RAG. Его высокоуровневые резюме расходовали на 97% меньше токенов по сравнению с прямой обработкой исходного текста.
Это не погрешность измерений. Точно для такого рода вопросов, которые ставят в тупик текстовый RAG, граф выигрывает в двух случаях из трех или даже чаще.
2. Многошаговый поиск: Граф находит то, что пропускают фрагменты
Второе свидетельство касается качества извлечения: попадает ли вообще правильный вспомогательный отрывок в топ результатов? В стандартных многошаговых бенчмарках QA (MuSiQue, HotpotQA, 2WikiMultiHopQA) поиск на базе графов драматически повышает показатель Recall@5:
-
Средний показатель Recall@5 вырастает с 73,4% (у наивного RAG) до 87,8% (с поддержкой графа), что дает прирост в +19,6 пункта.
-
Наибольший скачок наблюдается на самых сложных кросс-документных наборах: +31 пункт на MuSiQue и +28 пунктов на 2Wiki.
-
Авторы HippoRAG сообщают о росте точности многошагового QA до 20% при в 10–20 раз меньших затратах и в 6–13 раз более высокой скорости по сравнению с методами итеративного поиска.
3. Контролируемое прямое сравнение — где все становится честно
Здесь картина становится более тонкой. В исследовании 2025 года, проведенном специалистами из Университета штата Мичиган и Meta, стандартный RAG сравнивался с четырьмя семействами GraphRAG в рамках единого протокола (с одинаковым разбиением на фрагменты, эмбеддингами и генерацией) и не выявил единоличного победителя. Эти два подхода дополняют друг друга:
-
В задачах одношагового поиска фактов (на естественных вопросах) простой RAG слегка опередил конкурентов (F1 64.8 против 63.0 у лучшего графового метода).
-
В задачах многошаговых рассуждений (MultiHop-RAG) графовый поиск вышел вперед (общая точность 70.3 против 67.0).
Урок таков: граф контекста — это не универсальное улучшение. Это специализированный инструмент, который окупается именно тогда, когда вопросы требуют рассуждений с привлечением нескольких источников.
4. Когда использовать графы: Вердикт по типам задач
Самый свежий бенчмарк, GraphRAG-Bench (ICLR 2026), поставил задачу ответить на вопрос: «В каких сценариях графовые структуры дают измеримую пользу?» Его показатели точности в зависимости от задачи четко очерчивают границы:
-
Простой поиск фактов: Текстовые фрагменты 60.9 против графа 60.1 — фактически ничья. Структура графа представляет собой избыточную нагрузку, которая не нужна для данного запроса.
-
Сложные рассуждения: Граф 53.4 против фрагментов 42.9 — победа графа в +10 пунктов.
-
Контекстная суммаризация: Граф 64.4 против фрагментов 51.3 — победа графа в +13 пунктов.
Табло результатов
Предоставлено автором
Если читать от начала до конца, эта закономерность очевидна: преимущество графа растет по мере увеличения глубины рассуждений, в то время как текстовые фрагменты удерживают свои позиции при работе с изолированными фактами.
Подводные камни: Стоимость и проблема судей на базе LLM
Два важных нюанса мешают назвать этот подход безоговорочной победой, и их игнорирование приводит к разочарованию команд.
Построение графа обходится дорого. Извлечение сущностей и связей из всего корпуса документов с помощью LLM стоит недешево. Один из анализов показал, что создание индекса на базе GPT-4o для умеренного корпуса обошлось примерно в $48, что намного дороже простого векторного индекса. (Собственная разработка Microsoft, LazyGraphRAG, откладывает извлечение на момент запроса и снижает затраты примерно до 0,1% от прежней стоимости — молчаливое признание того, что первоначальный бюджет непрактичен для многих внедрений).
Многие победы присуждаются другой LLM, а судьи на базе LLM предвзяты. Независимый аудит выявил систематические ошибки в таком стиле оценки: предвзятость по позиции (изменение порядка вывода ответов может качнуть долю побед более чем на 30 пунктов), предвзятость по длине и предвзятость экспериментов (одинаковые сравнения дают разные результаты при перезапусках). После внесения поправок заявленный одним популярным методом показатель успешности в 66.7% упал примерно до 39%, что ниже точки безубыточности в 50%.
Вывод заключается вовсе не в том, что «исследования неверны». Он состоит в том, что крупные достижения — рост точности многошагового поиска на 20%, скачки показателя recall на 15–30 пунктов — являются надежными, в то время как небольшие расхождения в показателях полноты заслуживают скептического пересмотра с использованием метрик на основе эталонов.
Так когда же стоит использовать граф контекста?
Если отбросить рекламную шелуху, принятие решения становится на удивление прагматичным.
Используйте граф контекста, если: ваши вопросы предполагают многошаговый поиск, носят глобальный характер или направлены на осмысление информации; вам нужны исчерпывающие ответы с разных точек зрения; ваш корпус тесно взаимосвязан (исследовательские библиотеки, материалы судебных дел, истории инцидентов, базы знаний).
Оставайтесь на текстовых фрагментах, если: ваши запросы в основном сводятся к поиску одиночных фактов; ваш корпус мал или плоский; а затраты на индексацию, задержка и простота эксплуатации перевешивают маргинальный прирост качества.
Лучше всего — используйте гибридный подход: систематические исследования сходятся в одной рекомендации: направляйте каждый запрос к подходящему методу или объединяйте результаты обоих подходов. Сочетание графового поиска и поиска по фрагментам неизменно превосходит каждый из них по отдельности. Вам не нужно слепо веровать во что-то одно; вам нужно построить маршрутизатор.
Итог
Граф контекста — это не магия и не панацея. Это целевой инструмент. Дайте ему задачу, требующую соединения разрозненных фактов или синтеза всего корпуса, и он решит ее значительно лучше текстовых фрагментов. Попросите его найти «номер телефона на странице 3», и вы просто заплатите за ненужную вам индексацию.
Команды, которые добравутся успеха с GraphRAG в 2026 году, — это не те, кто запрограммирует в граф абсолютно все. Это те, кто знает, какие вопросы заслуживают графа, и создают достаточно умные пайплайны, чтобы отличать их друг от друга.
Даттарадж Рао — архитектор по исследованиям и разработкам в Persistent Systems
Добро пожаловать в сообщество VentureBeat!
Наша программа гостевых публикаций предназначена для того, чтобы технические эксперты могли делиться идеями и предоставлять объективные, неангажированные аналитические материалы об искусственном интеллекте, инфраструктуре данных, кибербезопасности и других передовых технологиях, формирующих будущее бизнеса.
Читайте далее в рамках нашей программы гостевых постов и ознакомьтесь с нашими рекомендациями, если вы хотите опубликовать собственную статью!




