


Графовый RAG для корпоративных данных


Генерация, дополненная поиском (RAG), стала фактическим стандартом для привязки больших языковых моделей (LLM) к корпоративным данным. Стандартная архитектура — разбиение документов на фрагменты, их векторизация в векторной базе данных и извлечение топ-k результатов с помощью косинусного сходства — эффективна для неструктурированного семантического поиска.
Однако для корпоративных доменов, характеризующихся высокой степенью взаимосвязи данных (цепочки поставок, финансовый комплаенс, обнаружение мошенничества), RAG только на основе векторов часто оказывается неэффективным. Он улавливает ходьбу по сходству, но упускает структуру. Ему трудно даются вопросы, требующие многошаговых рассуждений, например: «Как задержка поставки Компонента X повлияет на наш релиз для Клиента Y в третьем квартале?», поскольку векторное хранилище не «знает», что Компонент X является частью обязательств перед Клиентом Y.
В этой статье рассматривается паттерн графово-расширенного RAG. Опираясь на мой опыт создания высокопроизводительных систем логирования в Meta и инфраструктуры частных данных в Cognee, мы разберем эталонную архитектуру, которая объединяет семантическую гибкость векторного поиска со структурным детерминизмом графовых баз данных.
Проблема: когда векторный поиск теряет контекст
Векторные базы данных отлично справляются с улавливанием смысла, но отбрасывают топологию. Когда документ разбивается на фрагменты и векторизуется, явные связи (иерархия, зависимости, принадлежность) часто сглаживаются или теряются полностью.
Рассмотрим сценарий рисков в цепочке поставок. Хотя это гипотетический пример, он отражает именно тот класс структурных проблем, с которыми мы постоянно сталкиваемся в корпоративных архитектурах данных:
-
Структурированные данные: SQL-база данных, определяющая, что Поставщик A предоставляет Компонент X Заводу Y.
-
Неструктурированные данные: Новостной отчет, в котором говорится: «Наводнение в Таиланде остановило производство на предприятии Поставщика A».
Стандартный векторный поиск по запросу «производственные риски» найдет новостной отчет. Однако в нем, скорее всего, не будет контекста, связывающего этот отчет с продукцией Завода Y. LLM получает новости, но не может ответить на важнейший бизнес-вопрос: «Какие нижестоящие заводы находятся под угрозой?»
В продакшене это проявляется в виде галлюцинаций. LLM пытается преодолеть разрыв между новостным отчетом и заводом, но из-за отсутствия прямой связи начинает либо угадывать взаимосвязи, либо отвечать «Я не знаю», несмотря на то, что данные присутствуют в системе.
Паттерн: гибридный поиск
Для решения этой проблемы мы переходим от «плоского RAG» к архитектуре «графового RAG» (Graph RAG). Она включает в себя трехуровневый стек:
-
Инжест данных (урок от Meta): Работая в Meta над инфраструктурой логирования Shops, мы поняли, что структуру необходимо обеспечивать на этапе загрузки. Нельзя гарантировать надежную аналитику, если пытаться восстановить структуру из неструктурированных логов позже. Аналогично, в RAG мы должны извлекать сущности (узлы) и отношения (ребра) во время инжеста. Мы можем использовать LLM или модель распознавания именованных сущностей (NER) для извлечения сущностей из текстовых фрагментов и связывания их с существующими записями в графе.
-
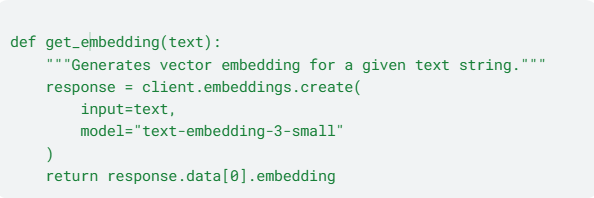
Хранение: Мы используем графовую базу данных (например, Neo4j) для хранения структурного графа. Векторные эмбеддинги сохраняются как свойства определенных узлов (например, узла RiskEvent).
-
Извлечение: Мы выполняем гибридный запрос:
Эталонная реализация
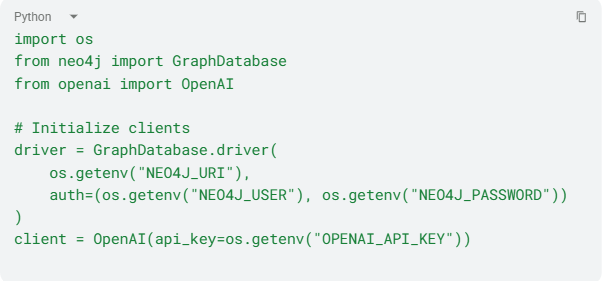
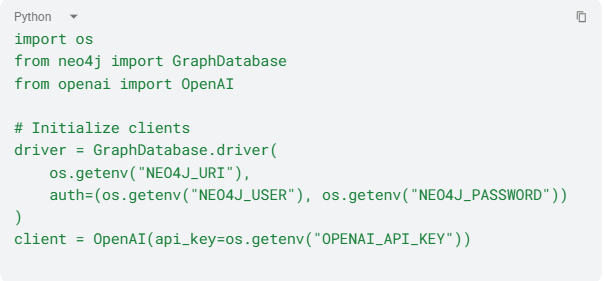
Давайте создадим упрощенную реализацию этого анализатора рисков цепочки поставок с использованием Python, Neo4j и OpenAI.
1. Моделирование графа
Нам нужна схема, которая соединяет наши неструктурированные «события риска» со структурированными сущностями «цепочки поставок».
2. Инжест: связывание структуры и семантики
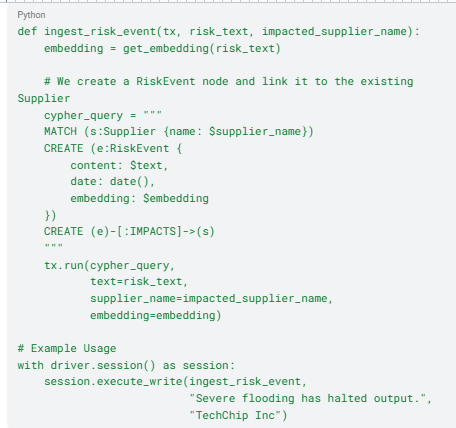
На этом этапе мы предполагаем, что структурный граф (поставщики -> заводы) уже существует. Мы загружаем новое неструктурированное «событие риска» и связываем его с графом.
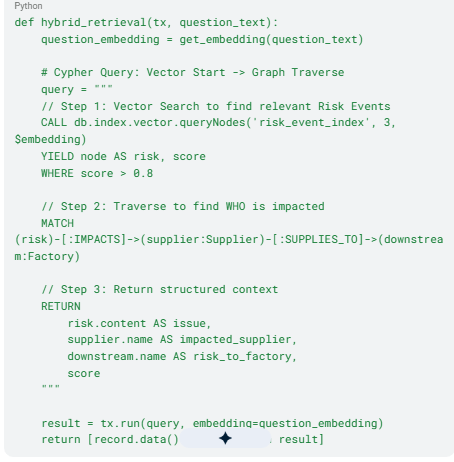
3. Запрос для гибридного поиска
Это ключевое отличие. Вместо того чтобы просто возвращать топ-k фрагментов, мы используем Cypher для выполнения векторного поиска с целью нахождения события, а затем обходим граф для поиска нижестоящих последствий.
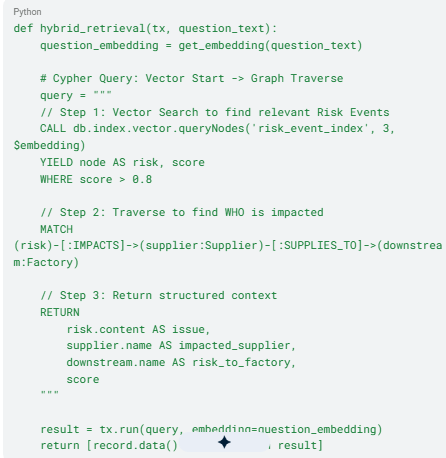
Результат: Вместо общего текстового фрагмента LLM получает структурированные данные:
[{‘issue’: ‘Severe челлендж…’, ‘impacted_supplier’: ‘TechChip Inc’, ‘risk_to_factory’: ‘Assembly Plant Alpha’}]
Это позволяет LLM сформировать точный ответ: «Наводнение на предприятии TechChip Inc ставит под угрозу сборочный завод Assembly Plant Alpha».
Уроки продакшена: задержки и консистентность
Перенос этой архитектуры из ноутбука в продакшн требует работы с компромиссами.
1. Налог на задержку (Latency Tax)
Обход графов обходится дороже, чем простые векторные поиски. В своей работе над экспериментами с изображениями товаров в Meta я сталкивался со строгими ограничениями по задержкам, когда каждая миллисекунда влияла на пользовательский опыт. Хотя предметная область была другой, архитектурный урок применим и к Graph RAG: вы не можете позволить себе вычислять всё «на лету».
Минимизация: Мы используем семантическое кэширование. Если пользователь задает вопрос, похожий (косинусное сходство > 0.85) на предыдущий запрос, мы отдаем закэшированный результат графа. Это снижает «графовую нагрузку» для частых запросов.
2. Проблема «устаревших ребер»
В векторных базах данных информация независима. В графе данные взаимозависимы. Если Поставщик A прекращает поставки Заводу Y, но ребро остается в графе, система RAG с уверенностью выдаст галлюцинацию о несуществующей больше связи.
Минимизация: Графовые связи должны иметь время жизни (TTL) или синхронизироваться через конвейеры захвата изменений данных (CDC) из источника правды (ERP-системы).
Инфраструктурный фреймворк принятия решений
Стоит ли вам внедрять Graph RAG? Вот фреймворк, который мы используем в Cognee:
-
Используйте RAG только на векторах, если:
-
Корпус плоский (например, хаотичный дамп Wiki или Slack).
-
Вопросы носят общий характер («Как мне сбросить VPN?»).
-
Требование к задержке < 200 мс является критическим.
-
-
Используйте графово-расширенный RAG, если:
-
Домен регулируется законами (финансы, здравоохранение).
-
Требуется «объяснимость» (нужно показать путь обхода графа).
-
Ответ зависит от многошаговых связей («Какие косвенные дочерние компании затронуты?»).
-
Заключение
Графово-расширенный RAG — это не замена векторному поиску, а необходимая эволюция для сложных доменов. Рассматривая свою инфраструктуру как граф знаний, вы предоставляете LLM то, чего она не может сгаллюцинировать: структурную правду вашего бизнеса.
Даулет Амирханов — инженер-программист в UseBead.
Добро пожаловать в сообщество VentureBeat!
Наша программа гостевых публикаций — это место, где технические эксперты делятся идеями и предоставляют объективные, непредвзятые глубокие анализы об ИИ, инфраструктуре данных, кибербезопасности и других передовых технологиях, формирующих будущее корпоративного сектора.
Читать далее из нашей программы гостевых постов — и ознакомьтесь с нашими рекомендациями если вы хотите опубликовать собственную статью!




