


DeepSeek открывает исходный код DSpark — нового фреймворка для ускорения инференса языковых моделей на величину до 85%
Источник: VentureBeat · Carl Franzen


В то время как геополитические споры вокруг искусственного интеллекта продолжают накаляться после мер американского правительства по ограничению использования новых моделей от Anthropic и OpenAI, китайский любимец разработчиков открытого ПО DeepSeek возвращается с очередным релизом с открытым исходным кодом, который снова способен изменить разработку ИИ по всему миру.
В минувшие выходные компания выпустила DSpark — новую систему под лицензией MIT, призванную заставить большие языковые модели отвечать быстрее без изменения того, что базовая модель пытается сказать.
Проще всего представить это так: большинство ИИ-чат-ботов пишут как человек, переходящий реку по камням — шаг за шагом. Они выбирают один небольшой фрагмент текста, затем следующий, затем еще один.
DSpark предоставляет системе «разведчика», который бежит на несколько шагов вперед, угадывает вероятный путь и позволяет более крупной модели быстро проверить, какие шаги безопасны. Когда догадки верны, модель движется быстрее. Когда догадки слабы, DSpark старается не тратить время на их проверку.
DeepSeek опубликовала эту работу вместе с техническим документом, контрольными точками (чекпоинтами) моделей и DeepSpec — кодовой базой для обучения и оценки систем спекулятивного декодирования. Релиз доступен на публичных страницах DeepSeek в GitHub и на Hugging Face, причем обе публикации используют мягкую, дружелюбную и распространенную лицензию MIT, что делает новый метод широко применимым для разработчиков, исследователей и коммерческих предприятий, желающих изучить или адаптировать этот подход.
Система нацелена на одну из самых дорогостоящих проблем при развертывании ИИ: обслуживание крупных моделей с достаточной для реальных пользователей скоростью при эффективном использовании оборудования, чтобы экономика процесса сходилась. Это имеет решающее значение для потребительских чат-ботов, ассистентов программирования, агентных рабочих процессов и корпоративных ИИ-систем, где пользователи ожидают, что длинные ответы будут выдаваться быстро, а не ползти слово за словом.
DeepSeek применяет DSpark к своей собственной новейшей пограничной открытой модели — DeepSeek-V4.
В частности, DeepSeek применила свой новый фреймворк DSpark к DeepSeek-V4-Flash — уже оптимизированной по скорости модели с разрешением смеси экспертов (MoE) на 284 миллиарда параметров с 13 миллиардами активных параметров, а также к DeepSeek-V4-Pro — более глубокой и мощной модели на 1,6 триллиона параметров с 49 миллиардами активных параметров (обе поддерживают контекстные окна до одного миллиона токенов).
Но более широкое значение заключается в том, что DSpark концептуально не ограничивается моделью DeepSeek-V4. Собственные тесты DeepSeek и выпущенные контрольные точки охватывают и другие семейства открытых моделей, включая открытые веса Qwen от Alibaba и Gemma от Google.
Это означает, что корпоративные команды, использующие модели с открытыми весами, в принципе могут обучать или дообучать модули предсказания в стиле DSpark для своих собственных целевых моделей. Это не переключатель, который любой клиент API может щелкнуть извне, но это метод, который применим к другим моделям, когда оператор контролирует веса и стек обслуживания.
VB Transform · 14–15 июля · Менло-Парк · Агентная оркестровка
Intuit перестроила свою многоагентную систему за 60 дней. Что они изменили и почему?
На конференции Transform лидеры инженерных команд из Intuit, Target и Instacart расскажут о том, как они перепроектировали свои архитектуры оркестровки для обеспечения надежности, масштабируемости и работы с реальными клиентами.
Потрясающий рост скорости генерации токенов при инференсе
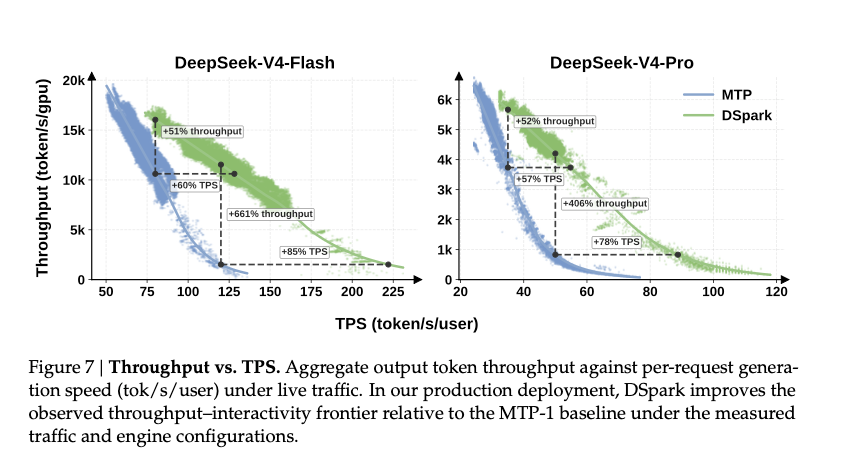
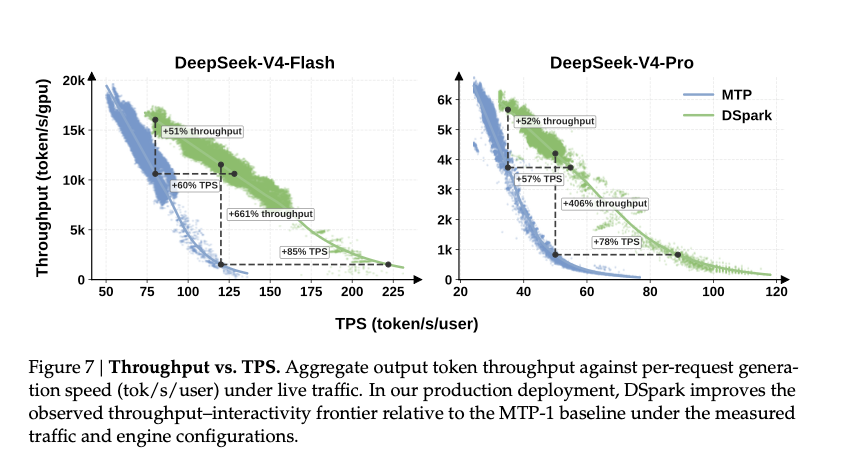
В ходе живых производственных тестов DeepSeek DSpark повысила общую пропускную способность на 51% для DeepSeek-V4-Flash при целевом показателе обслуживания в 80 токенов в секунду на пользователя и на 52% для DeepSeek-V4-Pro при целевом показателе в 35 токенов в секунду на пользователя. При сопоставимой емкости системы DeepSeek сообщает об ускорении генерации для отдельного пользователя на 60–85% для V4-Flash и на 57–78% для V4-Pro по сравнению с предыдущей производственной базовой линейкой MTP-1.
В различных заявлениях о росте скорости измеряются разные вещи. Показатели от 60% до 85% для V4-Flash и от 57% до 78% для V4-Pro описывают, насколько быстрее отдельные пользователи получают сгенерированные токены, когда DeepSeek сравнивает DSpark с MTP-1 при сопоставимой практической емкости системы.
Источник: DeepSeek, «DSpark: Confidence-Scheduled Speculative Decoding with Semi-Autoregressive Generation»
Это более чистые цифры «скорости генерации». DeepSeek также сообщает о гораздо более масштабном росте на 661% и 406%, но эти показатели измеряют общую пропускную способность при очень строгих целевых показателях скорости: 120 токенов в секунду на пользователя для V4-Flash и 50 токенов в секунду на пользователя для V4-Pro.
При таких целевых показателях, по словам DeepSeek, ее старая базовая модель MTP-1 приближается к рабочему пределу, что означает возможность одновременного выполнения лишь небольшого числа запросов при сохранении такого уровня оперативности.
DSpark позволяет избежать столь масштабного падения производительности, поэтому процентная разница в общем объеме системного вывода становится гораздо больше. Проще говоря: цифра в 85% ближе к пониманию того, «насколько быстрее ощущается поездка для пользователя» в сопоставимых условиях, в то время как показатели в 661% и 406% ближе к ответу на вопрос, «насколько большую нагрузку все еще может выдержать дорога», когда старая система уже упирается в узкое горлышко.
VB Transform · 14–15 июля · Менло-Парк · Агентная оркестровка
Intuit перестроила свою многоагентную систему за 60 дней. Что они изменили и почему?
На конференции Transform лидеры инженерных команд из Intuit, Target и Instacart расскажут о том, как они перепроектировали свои архитектуры оркестровки для обеспечения надежности, масштабируемости и работы с реальными клиентами.
Почему спекулятивное декодирование имеет значение
Большие языковые модели обычно генерируют текст по одному токену за раз. Токен может быть словом, частью слова, знаком препинания или другим небольшим фрагментом текста. Каждый новый токен зависит от уже созданного текста, поэтому модель вынуждена постоянно делать паузы, проверять полный контекст и выбирать следующий фрагмент.
Это точно, но медленно. Это все равно что заставлять главного редактора одобрять каждое слово, прежде чем писатель сможет перейти к следующему. Редактор может быть превосходным, но этот процесс создает узкое горлышко.
Спекулятивное декодирование, разработанное на заре эпохи архитектуры Transformer, призвано устранить это узкое место. Вместо того чтобы просить большую модель производить каждый токен по очереди, система использует более мелкий или легкий компонент предварительной генерации (драфтер), чтобы предложить несколько вероятных следующих токенов. Затем большая модель параллельно проверяет этот пакет предположений. Если догадки оправдались, система продвигается вперед сразу на несколько токенов. Если драфтер ошибся, система отклоняет неверный токен и все, что следует за ним, добавляет исправленный токен и пробует снова.
Смысл заключается в достижении скорости без изменения предполагаемого вывода большой модели. При стандартной схеме спекулятивного декодирования модель предсказания не заменяет целевую модель. Она больше похожа на ассистента, который готовит черновой вариант следующего предложения для утверждения или отклонения главным редактором.
Эта идея возникла не на пустом месте с появлением современных больших языковых моделей. Ключевой предшественник появился в 2018 году, когда Митчелл Стерн, Ноам Шазеер и Якоб Узкорейт предложили блочное параллельное декодирование для глубоких авторегрессионных моделей. Их метод предсказывал несколько будущих шагов параллельно, после чего сохранял самый длинный префикс, подтвержденный главной моделью. Эта статья заложила основу для интуитивного понимания принципа «предсказания и проверки» в последующих работах по спекулятивному декодированию.
Это направление исследований стало более явным в 2022 году. Хемин Ся, Тао Гэ и соавторы представили SpecDec — подход с предварительной генерацией и верификацией для генерации «последовательность-в-последовательность». Позже в том же году Янив Левиатан, Матан Калман и Йосси Матиас опубликовали работу «Быстрый инференс трансформеров с помощью спекулятивного декодирования» (Fast Inference from Transformers via Speculative Decoding), которая помогла сформировать современную версию этого метода для языковых моделей на базе трансформеров. Исследователи из DeepMind в 2023 году представили тесно связанный метод, названный спекулятивной выборкой.
Эти статьи 2022 и 2023 годов являются наиболее явными предшественниками того, как спекулятивное декодирование обсуждается в текущих работах по инференсу больших языковых моделей: более быстрый процесс предварительной генерации предлагает токены, а более крупная целевая модель проверяет их таким образом, чтобы сохранить распределение выходных данных целевой модели.
С тех пор эта область быстро прошла через несколько вариантов, включая раздельные модели предсказания, головы многотокенового прогнозирования, древовидную верификацию, методы на уровне признаков, такие как EAGLE, самоспекуляцию, дополнительные головы в стиле Medusa и параллельные/блочные модули предсказания, такие как DFlash.
Ключевой метрикой является не то, сколько токенов может угадать модель предсказания. Важно то, сколько из этих догадок реально принимает большая модель. Длинные спекулятивные блоки помогают только в том случае, если достаточное количество предложенных токенов проходит верификацию. В противном случае система тратит вычислительные ресурсы на проверку догадок, которые в итоге отбрасываются.
В этом и заключается контекст DSpark. Спекулятивное декодирование уже было устоявшимся методом инференса до релиза DeepSeek, с поддержкой в основных стеках обслуживания и несколькими конкурирующими исследовательскими подходами. Но это по-прежнему не до конца решенная проблема. Ускорение сильно зависит от модели предсказания, рабочей нагрузки, настроек обслуживания и текущего уровня трафика. Вклад DSpark заключается в улучшении обеих сторон компромисса: система пытается формировать более когерентные блоки токенов, а затем верифицировать только те части этих блоков, которые с наибольшей вероятностью окупятся в реальных условиях обслуживания.
Что меняет DSpark
DSpark решает две взаимосвязанные проблемы: неверные догадки и напрасную трату ресурсов на проверку.
Во-первых, система использует то, что DeepSeek называет полуавторегрессионной генерацией. Простыми словами, это означает, что DSpark пытается объединить скорость с лучшим пониманием последовательности.
Полностью параллельный модуль предсказания может угадывать несколько токенов одновременно, что работает быстро, но его последующие догадки могут стать менее согласованными, поскольку каждая позиция прогнозируется слишком независимо. Чисто пошаговый драфтер может лучше отслеживать, как один токен переходит в другой, но при этом теряется большая часть преимущества в скорости.
DSpark пытается сохранить лучшее из обоих миров. Он использует параллельную основу для большей части работы по черновой генерации, а затем добавляет легкую последовательную голову, которая позволяет учитывать взаимосвязи между соседними токенами. В примере из статьи параллельный драфтер может перепутать вероятные окончания фраз, такие как «of course» (конечно) и «no problem» (без проблем), выдавая неуклюжие комбинации, поскольку он прогнозирует позиции слишком изолированно. Последовательный компонент DSpark помогает системе сделать более поздние токены соответствующими более ранним.
Во-вторых, DSpark добавляет верификацию с расписанием на основе уверенности (confidence-scheduled verification). Вместо того чтобы всегда просить целевую модель проверять одинаковое количество черновых токенов, DSpark оценивает, какой именно префикс предварительной генерации с наибольшей вероятностью выживет. Планировщик с учетом возможностей оборудования затем корректирует объем проверяемой части каждого черновика на основе как уверенности модели, так и текущей нагрузки на обслуживание.
Простая аналогия: когда ресторан работает в спокойном режиме, шеф-повар может проверить больше работы помощника повара. Когда на кухне завал, шеф уделяет внимание только тем блюдам, которые с наибольшей вероятностью готовы. DSpark применяет схожий принцип к обслуживанию ИИ. При более легком трафике система может позволить себе проверять более длинные префиксы черновиков. При более интенсивном трафике она обрезает хвостовые догадки с низкой уверенностью до того, как они займут емкость батча, которая могла бы быть использована для других пользователей.
DeepSeek представляет это как ответ на распространенный производственный компромисс. Статичное многотокеновое предсказание может выглядеть привлекательно изолированно, но способно навредить пропускной способности при высокой параллельности запросов, поскольку система продолжает проверять токены, которые с высокой долей вероятности будут отвергнуты. Планировщик DSpark делает бюджет верификации гибким, а не фиксированным.
Офлайн-результаты: лучшая приемка черновиков в моделях Qwen и Gemma
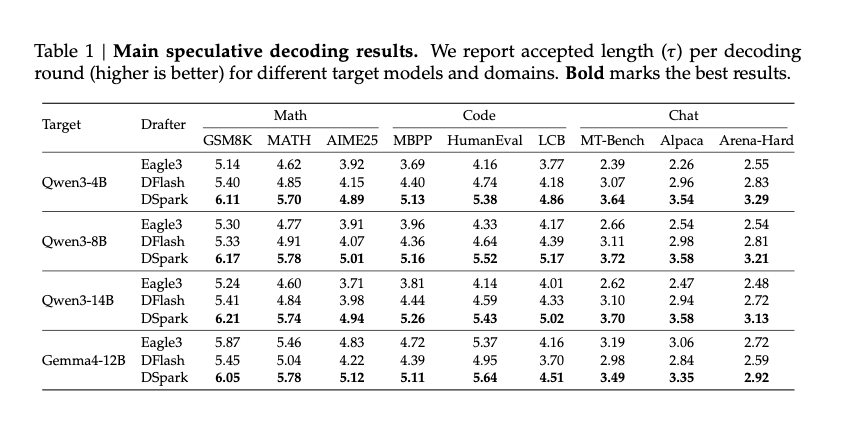
DeepSeek протестировала DSpark в офлайн-режиме на целевых моделях Qwen3-4B, Qwen3-8B, Qwen3-14B и Gemma4-12B на бенчмарках по математике, программированию и чат-задачам.
В этих тесках команда сравнила DSpark с DFlash (параллельный драфтер) и Eagle3 (авторегрессионный драфтер). В статье приводится показатель принятой длины за раунд декодирования — мера того, сколько в среднем токенов переживает верификацию.
Улучшение скорости моделей DSpark по сравнению с Eagle3 и DFlash на Qwen3-4B, Qwen3-8B, Qwen3-14B и Gemma4-12B. Источник: DeepSeek, «DSpark: Confidence-Scheduled Speculative Decoding with Semi-Autoregressive Generation»
Для всех трех размеров моделей Qwen3 DSpark увеличила среднюю макро-принятую длину по сравнению с Eagle3 на 30,9%, 26,7% и 30,0% соответственно. По сравнению с DFlash она увеличила принятую длину на 16,3%, 18,4% и 18,3%. В статье также отмечается, что эти приросты распространились и на Gemma4-12B.
Это подтверждает мысль, высказанную разработчиком Дэниелом Ханом (Daniel Han), который отметил в соцсети X, что DeepSeek продемонстрировала работу DSpark за пределами собственных моделей V4, включая Gemma и Qwen. Я бы рассматривал слова Хана как реакцию сообщества, а не как единственное доказательство этого утверждения. Более весомым подтверждением служат собственные бенчмарки DeepSeek и выпущенные контрольные точки.
Офлайн-результаты также показывают, почему рабочая нагрузка имеет значение. Структурированные задачи, такие как математика и написание кода, имеют тенденцию к большей принятой длине по сравнению с беседами в свободном формате. Это интуитивно понятно: завершение кода или шаг математического вычисления часто имеют меньше разумных вариантов следующих шагов, чем свободный диалог.
Для предприятий это означает, что методы в стиле DSpark могут быть особенно привлекательны для ассистентов программирования, агентов анализа данных, автоматизации структурированных рабочих процессов и других сценариев, где выводимые данные подчиняются более предсказуемым паттернам.
Как предприятия могут использовать DSpark без DeepSeek-V4
Один из самых важных вопросов заключается в том, является ли DSpark оптимизацией исключительно для DeepSeek или это более широкий метод, который можно применять к другим моделям. Ответ таков: более широкий метод, но не автоматический плагин.
Для моделей с открытыми весами путь относительно ясен. Предприятие, запускающее Qwen, Gemma, Llama, Mistral, Granite, открытые веса в стиле Command или другую модель, которую оно хостит самостоятельно, может обучить или дообучить модуль предварительной генерации в стиле DSpark для этой целевой модели.
Затем команда может измерить процент принятия на собственных рабочих нагрузках и интегрировать планировщик верификации в свой стек инференса.
Это отличается от простой загрузки модуля DSpark от DeepSeek и его подключения к любой модели. Спекулятивное декодирование зависит от согласованности между модулем предсказания и целевой моделью. Драфтер должен узнать, что именно целевая модель склонна принимать. Драфтер, обученный для DeepSeek-V4, не станет автоматически подходящим для другой модели, особенно для той, которая дообучена на внутренних данных компании или настроена на другое поведение при рассуждениях.
Рабочий процесс DeepSpec отражает это. Процесс включает подготовку данных, повторную генерацию ответов целевой модели, создание целевого кэша, обучение модели предварительной генерации и оценку принятия спекулятивного декодирования. Для предметно-ориентированного использования модель предсказания может потребовать дополнительного дообучения, особенно если целевая модель работает в режиме размышлений или логических рассуждений.
Что касается проприетарных моделей, то здесь все зависит от того, что контролирует предприятие. Если компания владеет весами модели и стеком обслуживания или полностью размещает их у себя, она теоретически может обучить и развернуть драфтер в стиле DSpark. Если модель доступна только через размещенное API от стороннего вендора, клиент не может напрямую добавить DSpark извне. Поставщик API может реализовать аналогичную оптимизацию внутри себя, но у клиента, как правило, нет доступа к циклу верификации токенов, логитам, поведению батчинга и планировщику обслуживания, которые необходимы для работы DSpark.
Это различие имеет значение для корпоративных покупателей. DSpark усиливает аргументы в пользу открытой или саморазмещаемой ИИ-инфраструктуры, поскольку дает передовым командам еще один рычаг для повышения скорости и снижения затрат. Но это также показывает, почему обслуживание моделей становится специализированной дисциплиной. Ценность заключается не только в выборе модели, но и в том, насколько умно эта модель запускается.
Что получают разработчики от DeepSpec
Для разработчиков DeepSpec предоставляет конкретный путь реализации для обучения и оценки моделей предварительной генерации для спекулятивного декодирования. Он включает этапы подготовки данных, обучения и оценки по бенчмаркам, а также выпущенные контрольные точки для нескольких семейств открытых моделей. Это делает релиз полезным не только для запуска DeepSeek-V4 с DSpark, но и для исследователей и инфраструктурных команд, изучающих способы добавления более быстрого декодирования в другие открытые модели.
Существуют реальные оговорки относительно развертывания. В собственном файле README DeepSpec указано, что настройка подготовки данных по умолчанию для Qwen3-4B может потребовать примерно 38 ТБ хранилища целевого кэша, а скрипты по умолчанию предполагают использование одного узла с восемью графическими процессорами (GPU). Это делает релиз более актуальным для ИИ-лабораторий, облачных команд и продвинутых групп корпоративной ИИ-инфраструктуры, чем для обычных разработчиков приложений.
Тем не менее, выпуск конвейера обучения имеет большое значение. Многие оптимизации инференса появляются лишь в виде научных статей, расплывчатых бенчмарков или закрытых заявлений о производственных результатах. DeepSpec дает разработчикам нечто больше похожее на набор чертежей: не готовый корпоративный продукт, а способ воспроизвести, адаптировать и оценить метод.
Раннее тестирование в сообществе
Релиз уже привлек быстрое внимание разработчиков. Разработчик Рафаэль Карисио (Rafael Caricio) опубликовал запрос на слияние (pull request) на GitHub, документирующий работу с однопоточным DSpark для DeepSeek-V4-Flash и сообщающий о разогретых бенчмарках на уровне 26,33 токена в секунду без спекулятивного декодирования, 39,88 токена в секунду с MTP-1 и примерно 60 токенов в секунду с DSpark — примерно в 1,5 раза быстрее по сравнению с MTP-1 и в 2,3 раза быстрее по сравнению с декодированием без спекуляций.
Более поздний коммит в той же ветке зафиксировал среднее значение по пяти прогонам в 60,31 токена в секунду, с приростом в 1,51 раза по сравнению с MTP-1 и в 2,29 раза по сравнению с неспекулятивным декодированием.
Эта же работа указывает и на важное практическое ограничение: в реалистичных сессиях программирования с многократным обменом сообщениями производительность может снижаться по мере того, как качество приема черновика падает на фоне растущего контекста. Другими словами, DSpark может ускорить декодирование, но качество предсказаний все равно определяет, какой объем прироста скорости система реализует на практике.
Это полезная проверка реальности. DSpark — это не волшебство. Он по-прежнему зависит от того, насколько предсказуемы следующие токены и насколько хорошо модуль предсказания согласован с целевой моделью. Но ранняя работа по реализации показывает, что заявления DeepSeek не являются чисто академическими. Разработчики уже тестируют метод в практических средах обслуживания и сообщают о приростах, близких к ожиданиям однопоточного режима из статьи.
Итоги
DSpark показывает, сколько еще скрытой производительности остается на уровне инференса, даже когда базовая архитектура модели остается прежней. Поскольку компании, занимающиеся искусственным интеллектом, конкурируют по качеству моделей, длине контекста и ценообразованию, эффективность декодирования становится еще одним важнейшим полем битвы.
Более быстрая генерация означает меньшую задержку для пользователей, более высокую пропускную способность для провайдеров и лучшую экономику для команд, обслуживающих открытые модели в масштабе.
Релиз DeepSeek примечателен тем, что объединяет проверенный на практике метод, открытый код, публичные контрольные точки и подробный документ. Главная инновация заключается не только в предсказании большего количества токенов. Она состоит в том, чтобы сделать систему более избирательной в отношении того, какую спекулятивную работу действительно стоит проверять.
Для корпоративных команд более широкий вывод заключается в том, что следующая волна прироста производительности ИИ придет не только от более крупных моделей. Она также будет обеспечена за счет более умных способов запуска уже имеющихся у компаний моделей — особенно когда эти компании контролируют достаточную часть стека, чтобы настраивать модель, обучать совместимый модуль предсказания и оптимизировать движок обслуживания под реальные рабочие нагрузки.




