


DeepSeek-V4 выходит на рынок с интеллектом, близким к передовому, за малую часть стоимости Opus 4.7 и GPT-5.5
Источник: VentureBeat · Carl Franzen


Кит снова всплыл на поверхности.
Компания DeepSeek, китайский стартап в сфере искусственного интеллекта и ответвление фирмы количественного анализа High-Flyer Capital Management, стала мировой сенсацией практически за одну ночь в январе 2025 года после выпуска своей открытой модели R1, которая не уступала проприетарным разработкам американских гигантов.
С тех пор в мире ИИ наступила целая эпоха, и хотя DeepSeek выпустила несколько обновлений для этой модели и своей другой серии V3, международное сообщество специалистов по ИИ и бизнес-среда в основном затаив дыхание ждали продолжения того фурора, который произвела модель R1.
И вот этот момент настал: прошлой ночью была выпущена DeepSeek-V4 — модель смешанных экспертов (Mixture-of-Experts, MoE) с 1,6 триллиона параметров, доступная бесплатно по коммерчески дружественной открытой лицензии MIT. Она приближается (а по некоторым бенчмаркам и превосходит) производительность самых передовых в мире закрытых систем, обходясь примерно в 6 раз дешевле при использовании через интерфейс программирования приложений (API).
Этот релиз, который исследователь DeepSeek AI Дели Чен (Deli Chen) описал в X как «труд любви», представленный через 484 дня после запуска V3, уже называют «вторым моментом DeepSeek».
Как отметил Чен в своем посте, «ОИИ (AGI) принадлежит каждому». Модель уже доступна в сообществе разработчиков ИИ Hugging Face и через API DeepSeek.
ИИ фронтирного класса переходит в более низкую ценовую категорию
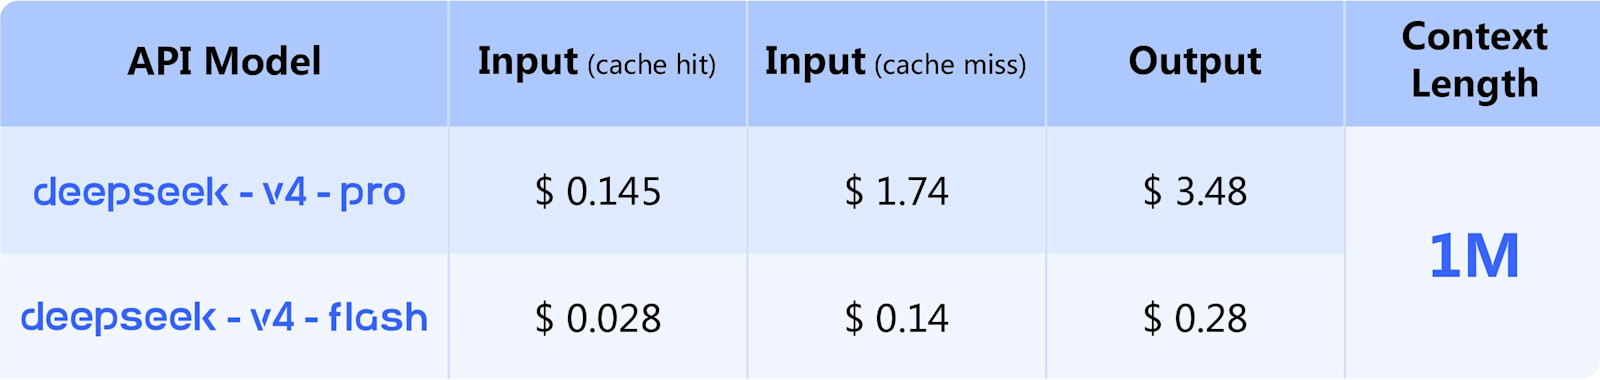
Самым непосредственным последствием запуска DeepSeek-V4 является экономический эффект. Скорректированная таблица цен показывает, что DeepSeek не устанавливает для своей новой модели Pro цены, близкие к нулю, но тем не менее переводит доступ к высококлассным моделям в гораздо более низкий ценовой сегмент по сравнению с ведущими американскими фронтирными моделями.
Стоимость DeepSeek-V4-Pro через ее API составляет 1,74 доллара США за 1 миллион входных токенов при промахе кэша (cache miss) и 3,48 доллара за миллион выходных токенов.
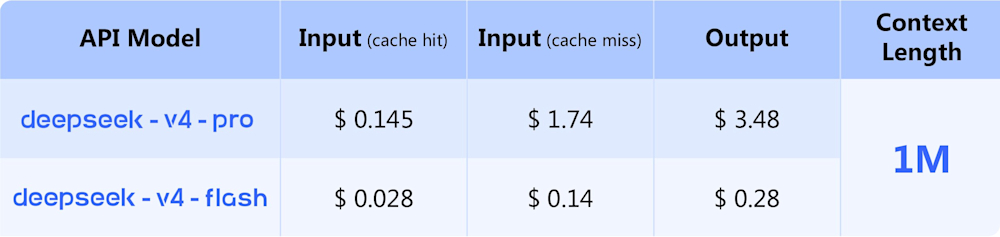
Тарифная сетка API DeepSeek V4. Источник: DeepSeek AI
Таким образом, простое сравнение для одного миллиона входных и одного миллиона выходных токенов составляет 5,22 доллара. При использовании кэшированного ввода стоимость входных данных падает до 0,145 доллара за миллион токенов, в результате чего аналогичное комплексное сравнение снижается до 3,625 доллара.
Это кардинально дешевле текущих премиальных цен от OpenAI и Anthropic. GPT-5.5 оценивается в 5,00 долларов за миллион входных токенов и 30,00 долларов за миллион выходных токенов, что в сумме составляет 35,00 долларов в том же простом сравнении.
Claude Opus 4.7 стоит 5,00 долларов за ввод и 25,00 долларов за вывод, что в сумме дает 30,00 долларов.
|
Модель |
Вход |
Выход |
Итоговая стоимость |
Источник |
|
Grok 4.1 Fast |
$0.20 |
$0.50 |
$0.70 |
|
|
MiniMax M2.7 |
$0.30 |
$1.20 |
$1.50 |
|
|
Gemini 3 Flash |
$0.50 |
$3.00 |
$3.50 |
|
|
Kimi-K2.5 |
$0.60 |
$3.00 |
$3.60 |
|
|
MiMo-V2-Pro (≤256K) |
$1.00 |
$3.00 |
$4.00 |
|
|
GLM-5 |
$1.00 |
$3.20 |
$4.20 |
|
|
GLM-5-Turbo |
$1.20 |
$4.00 |
$5.20 |
|
|
DeepSeek-V4-Pro |
$1.74 |
$3.48 |
$5.22 |
|
|
GLM-5.1 |
$1.40 |
$4.40 |
$5.80 |
|
|
Claude Haiku 4.5 |
$1.00 |
$5.00 |
$6.00 |
|
|
Qwen3-Max |
$1.20 |
$6.00 |
$7.20 |
|
|
Gemini 3 Pro |
$2.00 |
$12.00 |
$14.00 |
|
|
GPT-5.2 |
$1.75 |
$14.00 |
$15.75 |
|
|
GPT-5.4 |
$2.50 |
$15.00 |
$17.50 |
|
|
Claude Sonnet 4.5 |
$3.00 |
$15.00 |
$18.00 |
|
|
Claude Opus 4.7 |
$5.00 |
$25.00 |
$30.00 |
|
|
GPT-5.5 |
$5.00 |
$30.00 |
$35.00 |
|
|
GPT-5.4 Pro |
$30.00 |
$180.00 |
$210.00 |
При стандартной тарификации без кэширования стоимость DeepSeek-V4-Pro составляет примерно одну седьмую от стоимости GPT-5.5 и около одной шестой (1/6) от стоимости Claude Opus 4.7.
При использовании кэшированного ввода разрыв увеличивается: DeepSeek-V4-Pro стоит примерно в десять раз дешевле GPT-5.5 и примерно в восемь раз дешевле Claude Opus 4.7.
Еще более экстремальная ситуация с ценами, близкими к нулю, относится к DeepSeek-V4-Flash, а не к модели Pro. Стоимость Flash составляет 0,14 доллара за миллион входных токенов при промахе кэша и 0,28 доллара за миллион выходных токенов, что в сумме дает 0,42 доллара.
С учетом кэшированного ввода эта цифра падает до 0,308 доллара. В таком случае более дешевая модель от DeepSeek оказывается более чем на 98% дешевле GPT-5.5 и Claude Opus 4.7 при простом сравнении «вход плюс выход», или почти в 100 раз дешевле — хотя её производительность при этом заметно снижается.
DeepSeek сжимает экономику передовых моделей до гораздо более низкого диапазона, заставляя разработчиков и предприятия пересматривать расчеты затрат и выгод при использовании премиальных закрытых моделей.
Для компаний, запускающих масштабные рабочие нагрузки инференса, этот ценовой разрыв может изменить представление о том, что стоит автоматизировать. Задачи, которые кажутся слишком дорогими на GPT-5.5 или Claude Opus 4.7, могут стать экономически жизнеспособными на DeepSeek-V4-Pro и тем более на DeepSeek-V4-Flash. Этот релиз не делает интеллект бесплатным, но он делает рынок гораздо менее защищенным для премиальных провайдеров, полагающихся исключительно на показатели производительности.
Тестирование фронтира: DeepSeek-V4-Pro приближается к лидерам, но GPT-5.5 и Opus 4.7 по-прежнему лидируют в большинстве общих тестов
DeepSeek-V4-Pro-Max лучше всего рассматривать как крупный скачок среди моделей с открытыми весами, а не как безоговорочную победу над новейшими закрытыми фронтирными системами по всем фронтам.
Самые громкие заявления модели по результатам бенчмарков основаны на собственных сравнительных таблицах DeepSeek, где она сопоставляется с GPT-5.4 xHigh, Claude Opus 4.6 Max и Gemini 3.1 Pro High, превосходя их в ряде тестов, включая Codeforces и Apex Shortlist.
Но это не то же самое, что прямое сравнение с более новым GPT-5.5 от OpenAI или более новым Claude Opus 4.7 от Anthropic.
Если рассматривать только DeepSeek-V4 в сравнении с последними проприетарными моделями, картина выглядит более сдержанной.
В этом общем наборе тестов GPT-5.5 и Claude Opus 4.7 по-прежнему лидируют в большинстве категорий.
Лучший результат DeepSeek-V4-Pro-Max показывает в BrowseComp — бенчмарке, измеряющем возможности агентского веб-серфинга ИИ (особенно работу с сильно контейнеризированной информацией), где модель набирает 83,4%, лишь ненамного отставая от GPT-5.5 с его 84.4% и опережая Claude Opus 4.7, у которого 79,3%.
В Terminal-Bench 2.0 модель DeepSeek набирает 67,9%, что близко к показателю Claude Opus 4.7 (69.4%), но значительно отстает от результата GPT-5.5 (82.7%).
|
Бенчмарк |
DeepSeek-V4-Pro-Max |
GPT-5.5 |
GPT-5.5 Pro (где указано) |
Claude Opus 4.7 |
Лучший результат среди них |
|
GPQA Diamond |
90.1% |
93.6% |
— |
94.2% |
Claude Opus 4.7 |
|
Humanity’s Last Exam, без инструментов |
37.7% |
41.4% |
43.1% |
46.9% |
Claude Opus 4.7 |
|
Humanity’s Last Exam, с инструментами |
48.2% |
52.2% |
57.2% |
54.7% |
GPT-5.5 Pro |
|
Terminal-Bench 2.0 |
67.9% |
82.7% |
— |
69.4% |
GPT-5.5 |
|
SWE-Bench Pro / SWE Pro |
55.4% |
58.6% |
— |
64.3% |
Claude Opus 4.7 |
|
BrowseComp |
83.4% |
84.4% |
90.1% |
79.3% |
GPT-5.5 Pro |
|
MCP Atlas / MCPAtlas Public |
73.6% |
75.3% |
— |
79.1% |
Claude Opus 4.7 |
Результаты в общих академических рассуждениях благоприятствуют закрытым моделям: в GPQA Diamond модель DeepSeek-V4-Pro-Max набирает 90,1%, в то время как GPT-5.5 достигает 93.6%, а Claude Opus 4.7 — 94.2%.
В тесте Humanity’s Last Exam без инструментов DeepSeek набирает 37.7%, уступая GPT-5.5 (41.4%), GPT-5.5 Pro (43.1%) и Claude Opus 4.7 (46.9%). При включенных инструментах результат DeepSeek возрастает до 48.2%, но модель по-прежнему отстает от GPT-5.5 (52.2%), GPT-5.5 Pro (57.2%) и Claude Opus 4.7 (54.7%).
Результаты в сфере агентских задач и программной инженерии более неоднозначны, но они по-прежнему показывают, что DeepSeek-V4-Pro-Max уступает GPT-5.5 и Opus 4.7.
В Terminal-Bench 2.0 результат DeepSeek в 67,9% конкурентоспособен по сравнению с 69,4% у Claude Opus 4.7, однако у GPT-5.5 этот показатель значительно выше и составляет 82.7%.
В SWE-Bench Pro результат DeepSeek в 55,4% отстает от GPT-5.5 (58.6%) и Claude Opus 4.7 (64.3%). В MCP Atlas показатель DeepSeek в 73,6% немного ниже, чем у GPT-5.5 (75.3%) и Claude Opus 4.7 (79.1%).
BrowseComp выделяется на общем фоне: результат DeepSeek в 83,4% превосходит 79,3% у Claude Opus 4.7 и практически догоняет 84.4% у GPT-5.5, хотя показатель GPT-5.5 Pro на уровне 90,1% остается недосягаемым.
В конечном счете DeepSeek-V4-Pro-Max не производит свержения GPT-5.5 или Claude Opus 4.7 в тех бенчмарках, которые можно напрямую сопоставить по опубликованным таблицам компаний. Но модель подбирается к ним достаточно близко во многих тестах — особенно в BrowseComp, Terminal-Bench 2.0 и MCP Atlas — благодаря чему ее гораздо более низкая стоимость API становится главным инфоповодом.
В практическом плане DeepSeek не обязательно побеждать во всех строчках таблиц лидеров, чтобы иметь значение. Если модель способна обеспечивать близкую к фронтирной производительность во многих актуальных для бизнеса агентских задачах и задачах на рассуждение при стоимости API примерно в шестую-седьмую часть от стандартной цены GPT-5.5 или Claude Opus 4.7, она все равно заставляет кардинально переосмыслить экономику внедрения передового ИИ.
DeepSeek-V4-Pro-Max — несомненно, сильнейшая модель с открытыми весами на сегодняшний день, причем в ряде практических бенчмарков она необычайно близка к закрытым фронтирным системам.
Хотя GPT-5.5 и Claude Opus 4.7 по-прежнему сохраняют лидерство в большинстве прямых сопоставлений по таблицам бенчмарков самих компаний, DeepSeek V4 Pro подбирается к ним вплотную, оставаясь при этом разительно дешевле и находясь в открытом доступе.
Большой скачок по сравнению с DeepSeek V3.2
Чтобы осознать масштаб этого релиза, необходимо взглянуть на прирост производительности базовых моделей. DeepSeek-V4-Pro-Base представляет собой значительный шаг вперед по сравнению с предыдущим поколением — DeepSeek-V3.2-Base. В категории «Мировые знания» (World Knowledge) модель V4-Pro-Base набрала 90,1 балла в тесте MMLU (5-shot) по сравнению с 87,8 балла у V3.2, а в тесте MMLU-Pro продемонстрировала колоссальный скачок с 65,5 до 73.5 балла.
Улучшение показателей в области высокоуровневых рассуждений и верифицированных фактов выражено еще ярче: в SuperGPQA модель V4-Pro-Base достигла 53,9 балла по сравнению с 45,0 у V3.2, а в параметрическом бенчмарке FACTS она более чем удвоила результат предшественника, подскочив с 27,1 до 62.6 балла. Верифицированные оценки Simple-QA также показали драматический рост с 28,3 до 55.2 балла.
Возможности работы с длинным контекстом (Long Context) также были доработаны. В LongBench-V2 модель V4-Pro-Base набрала 51,5 балла, значительно опередив результат V3.2-Base, равный 40,2 балла. В программировании и математике V4-Pro-Base достигла 76,8 балла в HumanEval (Pass@1) по сравнению с 62,8 балла у V3.2-Base.
Эти цифры подчеркивают, что DeepSeek не просто оптимизировала затраты на инференс, но и фундаментально повысила плотность интеллекта своей базовой архитектуры. Преимущества в эффективности выглядят не менее впечатляюще и для варианта Flash. Модель DeepSeek-V4-Flash-Base, несмотря на использование значительно меньшего числа параметров, превосходит более крупную V3.2-Base в широком спектре бенчмарков, особенно в сценариях с длинным контекстом.
Новый «регулировщик» информации: гиперсвязи с ограничением на многообразии (mHC)
Способность DeepSeek предлагать такие цены и показатели производительности коренится в радикальных архитектурных инновациях, подробно описанных в техническом отчете, который также был опубликован сегодня: «В направлении высокоэффективного контекстного интеллекта объемом в миллион токенов» (Towards Highly Efficient Million-Token Context Intelligence).
Главным техническим достижением V4 является нативное окно контекста размером в один миллион токенов. Исторически поддержание столь масштабного контекста требовало огромного объема памяти (кэша ключей и значений, или KV-кэша).
DeepSeek решила эту проблему, внедрив гибридную архитектуру внимания (Hybrid Attention Architecture), которая объединяет разреженное сжатое внимание (Compressed Sparse Attention, CSA) для уменьшения начальной размерности токенов и сильно сжатое внимание (Heavily Compressed Attention, HCA) для агрессивного сжатия объема памяти под долгосрочные зависимости.
На практике модели V4-Pro требуется всего 10% от объема KV-кэша и 27% от вычислительных затрат (FLOP) на инференс одного токена по сравнению с ее предшественницей DeepSeek-V3.2, даже при работе с контекстом в 1 млн токенов.
Чтобы стабилизировать сеть из 1,6 триллиона параметров, разработчики DeepSeek отошли от традиционных остаточных связей (residual connections). Исследователи компании внедрили гиперсвязи с ограничением на многообразии (Manifold-Constrained Hyper-Connections, mHC), чтобы усилить распространение сигналов между слоями при сохранении выразительной способности модели.
mHC позволяет ИИ задействовать гораздо более широкий поток информации (чтобы обучаться более сложным вещам) без риска того, что модель потеряет стабильность или «сломается» в процессе обучения. Это все равно что построить в городе 10-полосную магистраль и добавить идеального ИИ-регулировщика, который гарантирует, что никто никогда не нажмет на тормоз почем зря.
Это решение дополняется оптимизатором Muon, который позволил команде добиться более быстрой сходимости и повышенной стабильности в ходе предварительного обучения на более чем 32 триллионах разнообразных высококачественных токенов.
Эти данные предварительного обучения были очищены от мусорного автогенерируемого контента, что снизило риск деградации модели (model collapse) и позволило расставить приоритеты в пользу уникальной академической ценности. 1,6 трлн параметров модели используют архитектуру смешанных экспертов (MoE), в которой для каждого токена активируются лишь 49 млрд параметров, что дополнительно снижает требования к вычислительным мощностям.
Обучение смеси экспертов (MoE) для работы в качестве единого целого
DeepSeek-V4 не просто обучалась — она была «выращена» с помощью уникальной двухэтапной парадигмы.
-
Сначала посредством независимого культивирования экспертов (Independent Expert Cultivation) были обучены доменные эксперты с помощью контролируемой доработки (SFT) и обучения с подкреплением (RL) с использованием алгоритма GRPO (Group Relative Policy Optimization). Это позволило каждому эксперту освоить специализированные навыки вроде математических рассуждений или анализа баз данных.
-
Во-вторых, унифицированная консолидация модели (Unified Model Consolidation) интегрировала эти различные компетенции в единую модель посредством он-политичной дистилляции (on-policy distillation), где единая модель выступает в роли студента, обучающегося оптимизации обратной дивергенции Кульбака — Лейблера (KL loss) с модельями-учителями. Этот процесс дистилляции гарантирует, что модель сохраняет специализированные возможности каждого эксперта, функционируя при этом как слаженный единый организм.
Познавательные возможности модели дополнительно разделены на три нарастающих режима «усилий» (effort modes).
-
Режим «Без раздумий» (Non-think) обеспечивает быстрые, интуитивные ответы на рутинные задачи.
-
Режим «Глубокие раздумий» (Think High) задействует осознанный логический анализ для комплексного решения проблем.
-
Наконец, режим «Максимальные раздумия» (Think Max) раздвигает границы возможностей модели в рассуждениях, сокращая разрыв с фронтирными моделями при решении сложных логических и агентских задач. Такая гибкость позволяет пользователям соотносить вычислительные затраты со сложностью задачи, что дополнительно повышает экономическую эффективность.
Преодоление монополии графических процессоров Nvidia с помощью местных китайских NPU Huawei Ascend
Хотя главная новость кроется в весах модели, программный стек, выпущенный вместе с ними, возможно, еще важнее для будущего «суверенного ИИ» («Sovereign AI»).
Аналитик Руй Ма (Rui Ma) выделил одно предложение из релиза как наиболее критически важное: DeepSeek провела валидацию своей схемы мелкозернистого параллелизма экспертов (Expert Parallelism, EP) на NPU Huawei Ascend (нейронных процессорах).
Добежав до ускорения в 1,50–1,73 раза на платформах, отличных от графических процессоров Nvidia, DeepSeek предоставила чертеж для развертывания высокопроизводительного ИИ, устойчивого к цепочкам поставок западных GPU и экспортным ограничениям.
Тем не менее важно отметить, что DeepSeek по-прежнему заявляет об использовании официально лицензированных, легальных графических процессоров Nvidia для обучения DeepSeek V4 в дополнение к NPU Huawei.
DeepSeek также открыла исходный код мега-кернела MegaMoE в качестве компонента своей библиотеки DeepGEMM. Эта CUDA-реализация обеспечивает ускорение до 1,96 раза для чувствительных к задержкам задач вроде генерации траекторий RL (rollouts) и высокоскоростного обслуживания агентов.
Этот шаг гарантирует, что разработчики смогут запускать эти массивные модели с предельной эффективностью на существующем оборудовании, еще больше укрепляя роль DeepSeek как главного драйвера инфраструктуры ИИ с открытым исходным кодом.
В техническом отчете подчеркивается, что эти оптимизации имеют решающее значение для поддержки стандартного контекста в 1 миллион токенов во всех официальных сервисах.
Лицензирование и локальное развертывание
DeepSeek-V4 выпускается под лицензией MIT — самой мягкой нормативной рамкой в отрасли. Это позволяет разработчикам использовать, копировать, модифицировать и распространять веса в коммерческих целях без выплаты роялти, что резко контрастирует с «ограниченными» лицензиями на модели с открытыми весами, которым отдают предпочтение другие компании.
Для локального развертывания DeepSeek рекомендует устанавливать параметры сэмплирования temperature = 1.0 и top_p = 1.0. Тем, кто использует режим рассуждений «Think Max», команда советует задавать размер окна контекста не менее 384 тыс. токенов, чтобы избежать усечения внутренних цепочек рассуждений модели.
Релиз включает специальную папку кодирования (encoding folder) с питоновскими скриптами, демонстрирующими, как кодировать сообщения в формате, совместимом с OpenAI, и как парсить вывод модели, включая контент рассуждений.
DeepSeek-V4 также бесшовно интегрирована с ведущими ИИ-агентами, такими как Claude Code, OpenClaw и OpenCode. Эта нативная интеграция подчеркивает ее роль в качестве фундамента для инструментов разработки, предоставляя открытую альтернативу проприетарным экосистемам крупных облачных провайдеров.
Реакция сообщества и что будет дальше
Реакция сообщества носила характер шока и признания. Hugging Face официально приветствовала возвращение «кита», заявив, что наступила эра экономически эффективной длины контекста в 1 миллион токенов.
Эксперты отрасли отметили, что «второй момент DeepSeek» фактически перезагрузил траекторию развития всей сферы, оказав колоссальное давление на провайдеров закрытого ПО вроде OpenAI и Anthropic, вынуждая их оправдывать свои премиальные наценки.
Фирма по оценке ИИ Vals AI отметила, что DeepSeek-V4 теперь является «моделью с открытыми весами №1 в нашем бенчмарке Vibe Code, и конкурентов рядом нет».
DeepSeek быстро сворачивает свои старые архитектуры. Компания объявила, что устаревшие эндпоинты deepseek-chat и deepseek-reasoner будут полностью отключены 24 июля 2026 года. Весь трафик в настоящее время перенаправляется на архитектуру V4-Flash, что означает полный переход на стандарт миллиона токенов.
DeepSeek-V4 — это больше, чем просто новая модель; это вызов существующему положению дел. Доказав, что архитектурные инновации могут заменить погоню за грубой максимизацией вычислительных мощностей, DeepSeek сделала высшие уровни искусственного интеллекта доступными для мирового сообщества разработчиков по гораздо более низкой цене. Это может принести пользу планете даже в то время, когда законодатели и лидеры в Вашингтоне выражают опасения по поводу того, что китайские лаборатории «дистиллируют» разработки американских проприетарных гигантов для обучения моделей с открытым исходным кодом, а также боятся, что упомянутые открытые модели или модели со взломанной защитой (jailbreak) могут быть использованы для создания оружия и совершения терактов.
Правда в том, что хотя все это потенциальные риски — какими они были и остаются для прошлых технологий, расширивших доступ к информации, вроде поисковых систем и самого интернета, — выгоды, судя по всему, намного их перевешивают. Стремление DeepSeek сохранять передовые модели ИИ открытыми приносит пользу всей планете потенциальных пользователей ИИ, особенно предприятиям, стремящимся внедрять передовые технологии по минимально возможной цене.




