


Инструмент ИИ для писателей сокращает расходы на токены на 38%
Источник: VentureBeat · Ben Dickson


Корпоративный ИИ сталкивается с парадоксом окупаемости инвестиций (ROI). Хотя увеличение вычислительных мощностей для работы с самыми мощными базовыми моделями отлично показывает себя в экспериментах с продуктом, затраты становятся невыносимыми при развертывании продукта в продакшене.
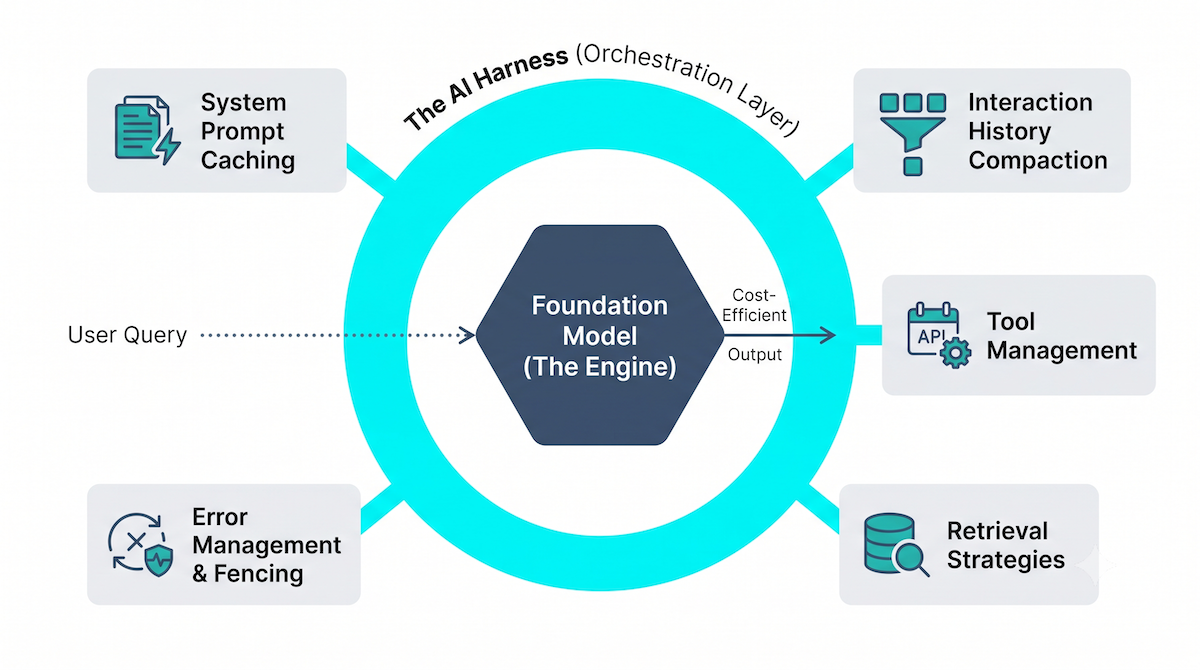
Новая научная работа исследователей из Writer предлагает решение, доступное для инженерных команд. В исследовании представлен систематический подход к оптимизации различных компонентов уровня оркестрации, который окружает базовую модель, — так называемой ИИ-обвязки (harness).
Оптимизируя обвязку, исследователи демонстрируют впечатляющее сокращение количества токенов на задачу, падение стоимости успешного выполнения задачи на величину до 61% и стабильное качество при неизменной базовой модели.
Поскольку обвязка полностью находится под контролем разработчика и не требует тонкой настройки модели (fine-tuning), инженерные команды могут применить эти результаты для создания высокорентабельных ИИ-приложений.
Кризис окупаемости токенмаксинга
Текущее состояние ИИ-инжиниринга омрачено «токенмаксингом» — тенденцией в индустрии, когда разработчики полагаются на огромные контекстные окна и грубое потребление токенов как замену качественному проектированию систем.
Вместо проектирования элегантных рабочих процессов разработчики перенесли рефлекс из традиционной разработки программного обеспечения: сгенерировать, запустить, получить ошибку, запихнуть ошибку и еще больший контекст обратно в окно и повторить попытку.
«Команды занимаются токенмаксингом, потому что это самое дешевое решение в моменте и потому что именно так сегодня работает большинство инженеров», — рассказал VentureBeat Васим АльШих (Waseem AlShikh), технический директор и соучредитель Writer. Поскольку этот подход достаточно часто срабатывает на задачах по программированию, он стал стандартным рефлексом для любой другой агентской рабочей нагрузки. Опасность заключается в том, что снижение цен за токен маскирует лежащую в основе неэффективность.
«Ваш счет складывается из количества токенов на задачу, умноженного на цену за токен, и большинство команд следят только за вторым показателем», — сказал АльШих. «В агентских рабочих нагрузках количество токенов на задачу накапливается — каждая итерация цикла повторно передает растущий контекст — и накапливается быстрее, чем падают цены. Снижение цен действует как анестетик. Оно маскирует тот факт, что сам цикл кровоточит».
Токенмаксинг приводит к ряду сбоев на уровне предприятия. Команды по умолчанию направляют простые задачи передовым премиальным моделям. Они используют языковую модель (LLM) как ленивый поисковый индекс, заполняя контекстное окно исходными документами вместо извлечения точных ответов. Самое разрушительное — они создают неограниченные агентские циклы, которые выходят из-под контроля, когда модель сталкивается с ошибкой. Поскольку выходные токены стоят значительно дороже входных у всех основных провайдеров моделей, неэффективное выполнение задач действует как скрытый убийца бюджета.
Индустрия внедрила несколько методов повышения эффективности для сдерживания этих расходов, но они в значительной степени неэффективны, поскольку рассматривают модель изолированно:
-
Сжатие промптов уплотняет входной текст для экономии места, но игнорирует то, как система упорядочивает эти входы в рамках сложных рабочих процессов.
-
Бюджетируемые рассуждения ограничивают вычислительные шаги, которые может предпринять модель, что часто ухудшает качество вывода, если рабочий процесс не маршрутизируется интеллектуально.
-
Лаконичный кодинг заставляет модели выдавать минимальный код для экономии выходных токенов, но ничего не делает для решения проблемы неэффективного вызова инструментов.
-
Спекулятивное декодирование использует меньшую модель-черновик для ускорения генерации текста более крупной моделью, оптимизируя скорость инференса, но не решая проблему раздутой архитектуры агентов.
Эти усилия терпят неудачу, потому что они оптимизируют движок, игнорируя трансмиссию. Они не учитывают уровень оркестрации, оставляя лежащие в основе архитектурные неэффективности нерешенными.
Анализ обвязки: рычаги эффективности
Обвязка (harness) — это уровень оркестрации, который маршрутизирует, форматирует и превращает базовую LLM в работающую систему.
Основные рычаги оптимизации обвязки включают кэширование системных промптов, компактизацию истории взаимодействия, управление инструментами, стратегии извлечения данных и управление ошибками. Это наиболее доступные точки вмешательства для инженерных команд, стремящихся улучшить производительность ИИ.
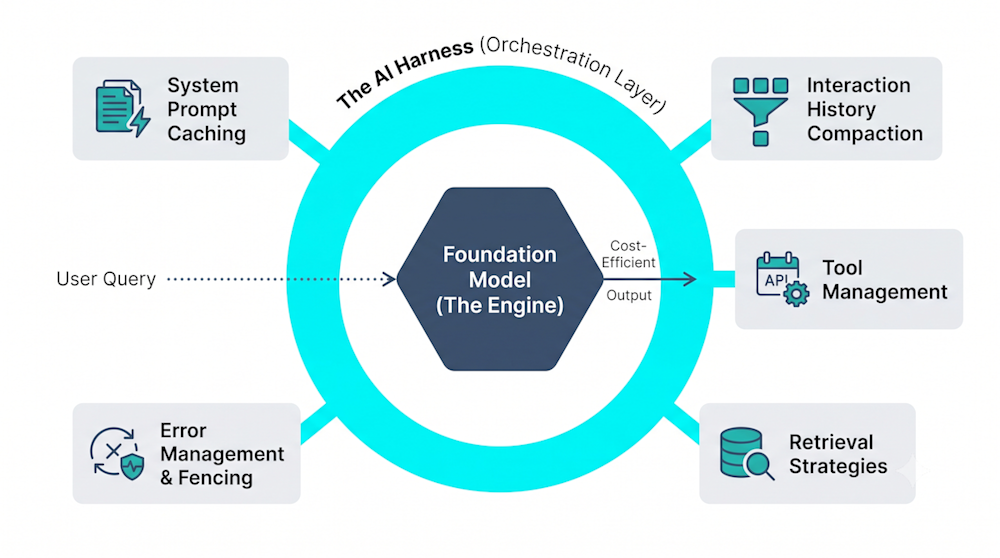
Источник изображения: VentureBeat совместно с Nano Banana
Как отмечают исследователи Writer в своем исследовании: «Если обвязка — это уровень, который объединяет вызовы моделей в работу, то это также уровень, который устанавливает цену этой работы».
Исторически разработчики относились к обвязке как к одноразовому связующему коду, предназначенному просто для подключения API к пользовательскому интерфейсу. Исследование сигнализирует о том, что теперь к обвязке нужно относиться как к объекту первого класса: первичному программному артефакту, требующему собственного тестирования, версионирования и строгого проектирования.
Для предприятий это переосмысляет дилемму «создать или арендовать».
«Предприятия тратят месяцы на оценку моделей, а затем арендуют готовую оркестрацию — а это значит, что они оптимизируют меньший рычаг и отдают на аутсорсинг больший», — сказал АльШих. «Кто владеет обвязкой, тот владеет вашей экономикой единицы продукции, а открытая среда, настроенная для демоверсий, не настроена под ваш счет».
Внутри экспериментов
Чтобы изолировать влияние уровня оркестрации, исследователи провели эксперименты на шести базовых моделях от разных производителей и весовых категорий: Claude Sonnet 4.6, Gemini 3.1, Gemini Flash 3.5, Qwen 3.6, GLM 5.1 и собственной модели Writer — Palmyra X6.
В ходе экспериментов фиксированный традиционный производственный цикл агента сравнивался с готовой обвязкой агента Writer (Writer Agent Harness) на тех же 22 зафиксированных корпоративных задачах, охватывающих такие возможности, как заземление и извлечение данных, многошаговые рабочие процессы, использование инструментов и генерация контента. Сохраняя модели и задачи неизменными, исследователи смогли изолировать эффекты самого уровня оркестрации.
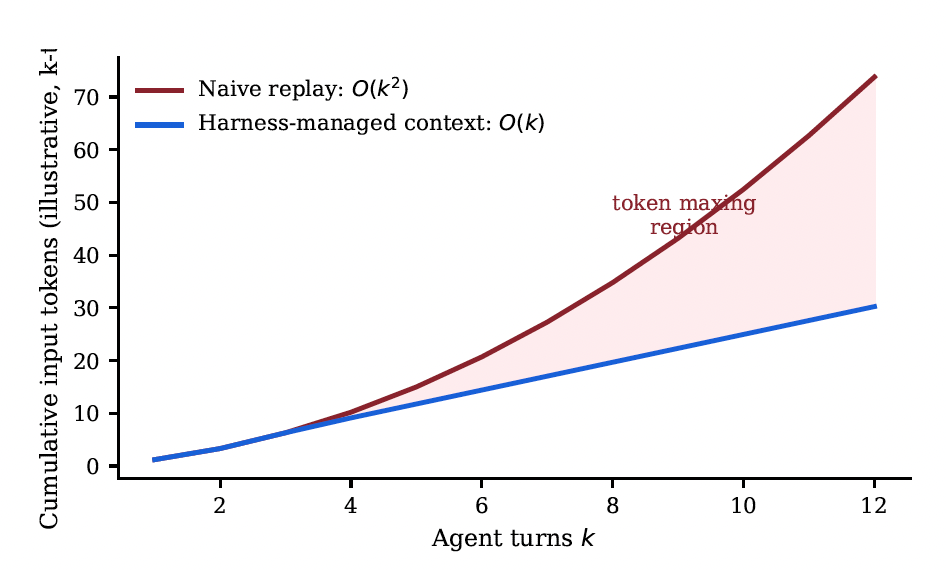
Потребление токенов при токенмаксинге и оптимизации обвязки (источник: arXiv)
Оптимизированная обвязка привела к значительному снижению затрат, сократив смешанную стоимость задачи на 41% — с 21 до 12 центов. Во многом это было достигнуто за счет резкого сокращения потребления токенов: количество токенов на задачу уменьшилось на 38% (с 14,2 тыс. до 8,8 тыс.).
Обвязка спроектирована так, чтобы делегировать такие задачи, как поиск, специализированным субагентам. Субагент получает только инструмент и конкретный запрос, который ему необходим, извлекает точные данные и возвращает основному агенту усеченную, чистую сводку, не позволяя первичному контекстному окну заполниться результатами сырого поиска.
Успешность выполнения задач оставалась стабильной даже на фоне снижения использования токенов — показатель изменился с 78% до 81%. Исследователи описывают этот прирост скорее как направленный, а не статистически значимый при данном размере выборки, что означает отсутствие потерь в качестве при падении затрат.
Сквозная задержка (латентость) задач также значительно снизилась: медианное время выполнения сократилось на 44% (с 48 до 27 секунд) благодаря кэшированию промптов и устранению тупиковых циклов рассуждений.
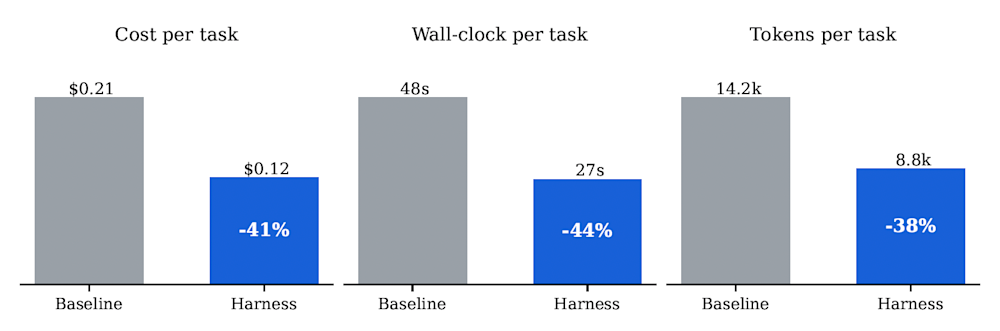
Выгоды от оптимизации обвязки (источник: arXiv)
Тем не менее, исследователи также обнаружили ограничения многоагентной оркестрации. Меньшие модели, такие как Gemini Flash 3.5 и Qwen 3.6, набрали баллы значительно ниже порога полезной надежности в задачах делегирования субагентам (0,45 и 0,42 соответственно) — эта функция пока еще недостаточно надежна для более легких моделей.
Оркестрация субагентов преодолела порог полезной надежности только на двух протестированных наиболее мощных моделях: собственной Palmyra X6 от Writer (0,86) и Claude Sonnet 4.6 (0,85).
Руководство для разработчика: практические выводы и компромиссы
Результаты исследования превращаются в руководство к действию для корпоративных разработчиков, создающих агентские рабочие процессы в масштабе. Первый шаг — внедрение того, что АльШих называет «двухзонным промптом» (Two-Zone Prompt) и «выгрузкой контекста» (Context Offloading).
Структурирование для кэширования системных промптов (двухзонный промпт): Современные API языковых моделей поддерживают кэширование промптов, но разработчики должны правильно структурировать полезную нагрузку (payload), чтобы запустить его. Разработчики должны разделять «стабильную зону» и «неустойчивую зону». Размещайте статичные, неизменяемые элементы (например, основные правила, крупные схемы инструментов и стандартные операционные процедуры) в верхней части промпта. Динамические элементы, такие как конкретный запрос пользователя или текущее состояние диалога, должны добавляться в самом низу. Такой порядок позволяет обвязке использовать закешированный префикс повторно в сотнях вызовов. «Это единственное разделение заставляет кэширование промптов реально работать и избавляет вас от необходимости повторно оплачивать те же инструкции на каждом из тридцати шагов агента», — сказал АльШих.
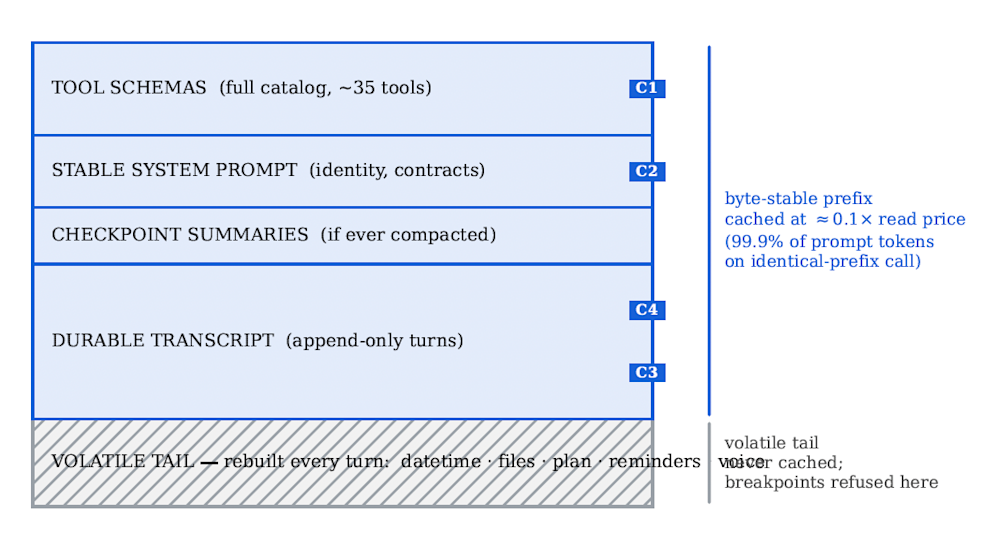
Двухзонный промпт (источник: arXiv)
Управление контекстом с помощью выгрузки контекста (Context Offloading): Избегайте забивания контекста, когда каждый шаг цикла добавляется в монолитный промпт до тех пор, пока окно не достигнет максимума. Вместо этого перемещайте историю и промежуточные артефакты из окна во внешнее хранилище с возможностью поиска и извлекайте только то, что требуется для текущего шага. Если возможно, делегируйте задачи специализированным субагентам, чтобы избежать раздувания контекста. Как отмечает АльШих, «самая большая статья расходов в бюджете агентов — это не рассуждения, а повторная отправка того, что модель уже видела».
Создание устойчивых циклов и переопределение ключевых показателей эффективности (KPI): Неуправляемые агентские циклы быстро истощают бюджеты API. Команды должны начать отслеживать количество завершений на миллион токенов (CPM), чтобы понимать реальную стоимость задач, но сама обвязка должна содержать физические средства защиты. «Основной принцип заключается в том, что вы никогда не просите модель контролировать собственные расходы», — сказал АльШих. «Ограда должна располагаться ниже модели, в коде, на вашей стороне API». Это требует трех жестких проверок:
-
Жесткие бюджеты токенов на задачу: выполнение прекращается при исчерпании бюджета, без исключений.
-
Ограничение генерации: ограничение шагов, вызовов инструментов и глубины рекурсии для остановки неконвергирующих агентов.
-
Управление затратами на сбои: ограничение суммы, которую выполнение может потратить после первой неудачной проверки, чтобы сбойная задача не стала вашей самой дорогой задачей.
Избегайте ненужной сложности: Оптимизация уровня оркестрации сопряжена с инженерными накладными расходами. Если вы находитесь на этапе прототипирования и исследований, эти накладные расходы не оправданы — итерируйте быстро с сильной моделью и легкой обвязкой. Как только вы масштабируетесь до миллионов запросов в день, экономия от оптимизации обвязки становится существенной.
Тем не менее, команды должны осознавать «рычаг обвязки». Добавление структурных лесов требует, чтобы модель удерживала этот контекст и подчинялась ему. Если модель слишком мала, она потратит свою ограниченную емкость на синтаксический анализ лесов вместо выполнения задачи, что приведет к падению точности и росту токенов. Правило добавления сложных функций оркестрации строго математическое: «Если функция добавляет больше координационных токенов, чем удаляет токенов задачи для данной конкретной модели, сократите ее», — сказал АльШих. «Ничто в обвязке не дается бесплатно».
Будущее корпоративной обвязки
Эпоха токенмаксинга и отношения к контекстным окнам как к бездонным бочкам подходит к концу. Направление дополнительных вычислительных мощностей на плохо спроектированные системы не является жизнеспособной стратегией для компаний, которым необходимо продемонстрировать окупаемость инвестиций в ИИ.
По мере того как базовые модели будут развиваться, естественным образом поглощая планирование, выбор инструментов и многошаговые рассуждения на уровне своих весов, роль обвязки сместится с компенсации слабостей модели на обеспечение соблюдения корпоративных политик.
«То, что никогда не перейдет внутрь модели, — это категории разрешенного: бюджеты, разрешения, границы данных, аудиторские следы, детерминированные аварийные выключатели», — сказал АльШих. «Пять лет спустя обвязка станет тоньше, но важнее. Будет меньше вспомогательных структур и больше управления. Какой бы мощной ни становилась модель, кто-то внешний по отношению к ней все равно должен определять, что ей разрешено тратить, видеть и к чему прикасаться. Этот уровень принадлежит предприятию, и его никогда нельзя брать в аренду».




