


Сжатие контекста LLM в 16 раз превосходит кэш KV
Источник: VentureBeat · Sean Michael Kerner


Контекстные окна становятся «узким местом» с точки зрения вычислений. Чем дольше работает агент, тем больше токенов накапливается из извлеченных документов, цепочек рассуждений и истории диалога, и тем больше памяти и вычислительных мощностей требует этот растущий контекст. Большинство существующих решений либо снижают точность модели, либо требуют загрузки всего контекста до начала сжатия, либо обеспечивают экономию памяти, которая не приводит к реальному ускорению на стандартной инфраструктуре обслуживания (сервинга).
Исследовательская группа из Нью-Йоркского университета, Колумбийского университета, Принстона, Мэрилендского университета, Гарварда и Ливерморской национальной лаборатории им. Лоуренса опубликовала на этой неделе статью, в которой предлагается оригинальное решение. Исследователи представили концепцию Latent Context Language Models (LCLM) — семейства моделей сжатия типа «энкодер-декодер», которые сжимают входной контекст еще до того, как он попадает в декодер. Исходный код и веса моделей опубликованы в открытом доступе на HuggingFace.
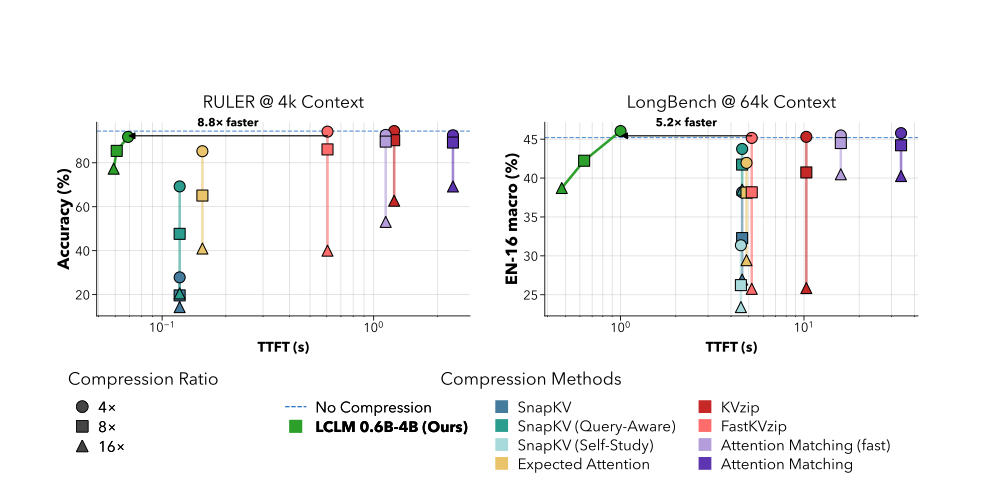
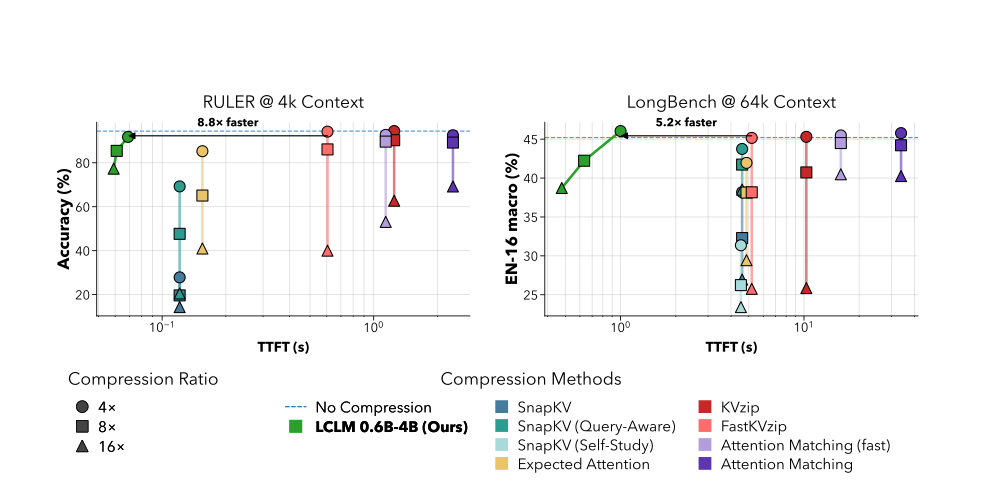
В отличие от методов сжатия KV-кэша — доминирующего подхода в этой области, при котором полный KV-кэш все равно материализуется перед удалением записей, — LCLM сжимают входную последовательность токенов до этапа предварительного заполнения (prefill) декодера. Благодаря этому более высокие коэффициенты сжатия напрямую снижают вычислительную нагрузку и потребление памяти на стороне декодера. В статье сообщается, что LCLM при 16-кратном сжатии генерировали результат в 8,8 раза быстрее, чем базовые методы на основе KV-кэша, на бенчмарке длинного контекста RULER.
«Этот разрастающийся контекст занимает память и вычислительные ресурсы, становясь узким местом для LLM, — рассказал VentureBeat Майка Голдблюм (Micah Goldblum), один из научных руководителей проекта и исследователь из Колумбийского университета. — Наша цель состояла в том, чтобы сквозным образом обучить языковые модели эффективно и точно обрабатывать очень длинный контекст. Если создать такую языковую модель, всё станет дешевле и быстрее».
На что способны LCLM
LCLM позволяют моделям обрабатывать гораздо более длинные контексты, чем это было практически возможно ранее, затрачивая лишь малую часть памяти и вычислений, и без снижения точности, из-за которого большинство методов сжатия оказываются невыгодным компромиссом в производственных условиях.
Согласно статье, при 4-кратном сжатии точность на бенчмарке RULER составила 91,76% по сравнению с 94,41% вообще без сжатия. Падение менее чем на 3 процентных пункта при сокращении контекста до четверти от его первоначального размера. При 16-кратном сжатии, когда удаляется 93,75% входных токенов, точность снизилась до 75,06%. Все протестированные методы сжатия KV-кэша при том же коэффициенте сжатия показали худшие результаты.
Преимущества сохраняются и на более коротких входных данных. В математических текстовых задачах GSM8K, где сжимается весь промпт, а не только извлеченные документы, LCLM превзошли все остальные протестированные методы независимо от степени сжатия.
Источник: научная статья End-to-End Context Compression at Scale https://arxiv.org/pdf/2606.09659
Как устроена модель
Архитектура объединяет энкодер на 0,6 млрд параметров с декодером на 4 млрд параметров. Энкодер сжимает блоки входных токенов в более короткие последовательности латентных эмбеддингов. Декодер обрабатывает их вместо исходных токенов. Обучение проводилось на более чем 350 миллиардах токенов.
Методика обучения сочетает три типа данных:
-
Данные для непрерывного предобучения (continual pre-training) с чередованием сжатых и несжатых фрагментов
-
Данные для контролируемой тонкой настройки (SFT), охватывающие задачи на логическое рассуждение и обработку длинного контекста
-
Вспомогательная задача реконструкции, побуждающая энкодер сохранять мелкие детали
Такая комбинация решает проблему компромисса, ограничивавшую более ранние работы по сжатию, когда сохранение точности реконструкции происходило в ущерб общей производительности при выполнении задач.
Поиск оптимальной архитектуры выявил наиболее эффективную конфигурацию. Авторы статьи обнаружили, что масштабирование декодера важнее, чем масштабирование энкодера.
Место в стеке агентных систем
LCLM — это не абстрактная исследовательская концепция. Архитектура разработана для работы с существующим стеком. «Вы можете просто заменить любую существующую LLM на LCLM, — пояснил Голдблюм. — Всякий раз, когда вы извлекаете данные, например документы, и хотите поместить их в контекст модели, просто предварительно пропустите эти документы через компрессор LCLM».
Он отметил, что в исследовательской статье авторы продемонстрировали, как создавать агентов, которые выборочно распаковывают полезный текст.
«Представьте, что человек бегло просматривает текст, прежде чем подробно вчитаться в нужные детали», — сказал Голдблюм.
Голдблюм также предупредил, что командам, внедряющим этот подход в существующие пайплайны агентов, потребуется соответствующим образом настроить свои RAG-системы.
«Мы также еще не работали над сжатием цепочек рассуждений в режиме онлайн, — сказал он. — Наивный подход с периодическим сжатием цепочки по мере ее генерации может сработать, но это еще предстоит выяснить».
Что это значит для бизнеса
Контекстные окна растут быстрее, чем инфраструктура инференса успевает развиваться, и бизнес уже инвестирует средства в решение этой проблемы. Данные опроса VB Pulse за первый квартал 2026 года среди организаций со штатом более 100 сотрудников показывают, что намерение внедрить гибридный поиск утроилось: с 10,3% в январе до 33,3% в марте. К марту оптимизация извлечения данных (retrieval) обогнала оценку качества (evaluation) в качестве главного инвестиционного приоритета, достигнув 28,9% среди квалифицированных респондентов.
Командам, оценивающим применимость технологии в проде, стоит обратить внимание на три момента:
-
Стоимость инференса масштабируется вместе с длиной контекста. При контексте в 1 миллион токенов несжатый инференс со стандартными методами KV-кэша приводит к нехватке памяти на одном GPU H200. В статье сообщается, что LCLM при 16-кратном сжатии укладываются в лимиты памяти при такой длине контекста.
-
Интеграция в RAG-пайплайн требует настройки. Командам с уже развернутыми RAG-пайплайнами перед масштабным внедрением потребуется проверить работу сжатия по метрикам качества извлечения данных.
-
Сжатие цепочек рассуждений остается нерешенной задачей. Для агентов с длинными цепочками рассуждений разрастание контекста из-за этих цепочек представляет собой проблему, отличную от извлечения документов. Голдблюм прямо признал этот пробел: наивный подход с периодическим сжатием цепочки может сработать, но пока не тестировался.
Модели доступны по адресу huggingface.co/latent-context, а код — на github.com/LeonLixyz/LCLM.
«Главное преимущество наших архитектур заключается в том, что они дают модели доступ к значительно большим контекстам. Кроме того, они открывают путь к разномасштабным подходам, когда модель может сверхбыстро бегло просматривать огромные объемы текста или кода и лишь затем углубляться и полностью прочитывать небольшую, наиболее полезную часть текста», — заключил Голдблюм.




