


Исследователи обучили поискового агента ИИ с открытым исходным кодом Harness-1, который превосходит GPT-5.4 в извлечении релевантной информации


Совместная исследовательская работа ученых из Университета Иллинойса в Урбана-Шампейне (UIUC), Калифорнийского университета в Беркли и платформы векторных баз данных с открытым исходным кодом Chroma представила Harness-1 — поисковый агент с открытым исходным кодом с 20 миллиардами параметров, созданный на базе открытой модели OpenAI gpt-oss-20B, который коренным образом меняет подход к выполнению сложных задач извлечения информации с помощью ИИ.
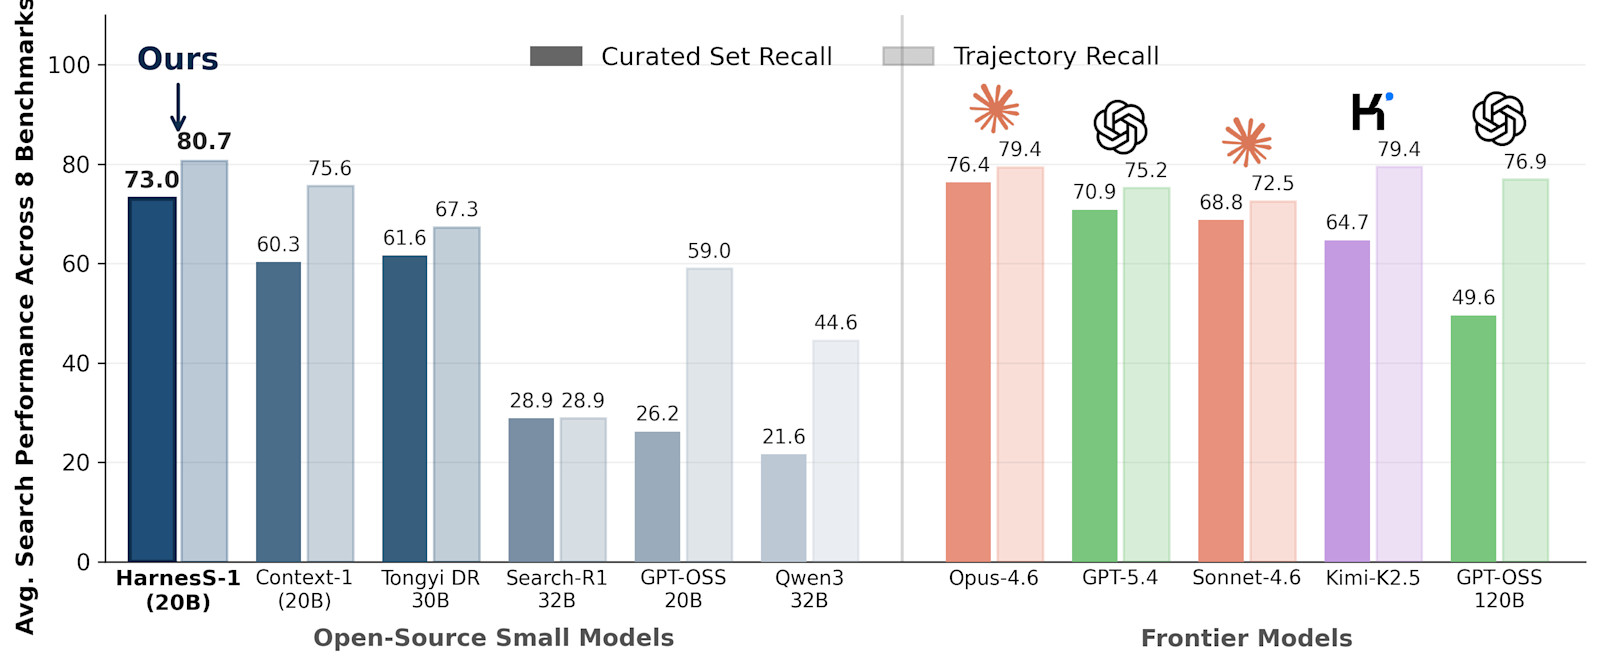
Harness-1 совершает огромный скачок в производительности, набирая в среднем 73% по показателю правильного воспроизведения релевантной информации из специально подготовленного набора данных, опережая даже GPT-5.4 (70.9%) и следующего по точности поискового агента с открытым исходным кодом, Tongyi DeepResearch 30B, на 11.4 процентных пункта. (Хотя GPT-5.5 также вышла более месяца назад, исследователи не проводили тестирование на этой модели, так как она была недоступна в период разработки их собственного решения.)
Производительность Harness-1 в бенчмарках точности по сравнению с другими ведущими поисковыми ИИ-агентами и моделями. Источник: Университет Иллинойса в Урбана-Шампейне, Калифорнийский университет в Беркли, Chroma
Что крайне важно для разработчиков, модель и ее окружение доступны незамедлительно по предельно лояльной лицензии Apache 2.0, а код модели и веса размещены на Hugging Face.
Harness-1 также служит доказательством эффективности другой разработки — Tinker, распределенного веб-API для обучения и тонкой настройки ИИ-моделей, созданного компанией Thinking Machines. Tinker использовался специально для обучения и запуска инференса Harness-1, что наглядно демонстрирует, как интерактивная инфраструктура активно способствует появлению автономных моделей нового поколения.
Так как же исследователям это удалось?
Бенчмарки расшифрованы (и почему Harness-1 может колоссально помочь предприятиям)
Чтобы проверить эти модели в реальных условиях, исследователи оценили Harness-1 и ее конкурентов по восьми сложнейшим поисковым бенчмаркам. Вместо ответов на простые вопросы на эрудицию эти тесты требовали от ИИ действовать как профессиональный исследователь, анализирующий разнообразные и насыщенные массивы данных.
Бенчмарки охватывали несколько различных областей, включая поиск по открытому веб-пространству, сложную финансовую отчетность Комиссии по ценным бумагам и биржам США (SEC), базы данных технических патентов патентного ведомства США (USPTO), а также задачи «многошагового» (multi-hop) ответа на вопросы, где ИИ должен был логически сопоставить разрозненные подсказки из нескольких разных документов для получения правильного ответа.
Когда результаты были получены, Harness-1 доминировала среди конкурентов с открытым исходным кодом в способности успешно находить и отбирать нужные факты. Что еще более впечатляет, эта относительно небольшая модель с 20 миллиардами параметров на равных конкурировала с массивными и дорогими проприетарными системами ИИ. Она действительно превзошла таких тяжеловесов, как GPT-5.4, Sonnet-4.6 и Kimi-K2.5, которые, как считается, насчитывают сотни миллиардов или триллионы параметров. Лишь одна гигантская передовая модель — Opus-4.6 — сумела с минимальным отрывом опередить ее по общей средняя производительности.
Harness-1 достигает прироста производительности за счет выгрузки рутинного «учета» поисковой сессии из рабочей памяти модели в структурированное программное окружение.
По мере того как корпоративные сценарии использования становятся все более сложными и требуют от моделей автономного просеивания тысяч корпоративных документов или финансовых отчетов, эти системы часто подвержены «поисковой амнезии» — они забывают свои первоначальные запросы, циклически возвращаются к уже отброшенным документам или теряют нить конкретных утверждений, которые пытаются проверить.
До сих пор преобладающим решением этой проблемы была грубая сила. Инженеры обычно заставляли модели постоянно перечитывать постоянно расширяющийся стенографический журнал их собственных действий, состоящий только из дополнений, загружая каждый поиск, прочтение и мысль обратно в массивное контекстное окно.
Harness-1 предлагает смену парадигмы, уходя от этого метода и доказывая, что узким местом для истинной искусственной автономности является не обязательно размер модели, а то, насколько эффективно ее рабочая среда управляет состоянием. Это еще раз подчеркивает, как ранее продемонстрировал Claude Code от Anthropic, что сама по себе исходная модель, возможно, менее важна, чем обвязка (harness) — или набор условий, — в которой она работает.
Технология: выполнение бумажной работы в окружении
Чтобы понять технический прорыв Harness-1, обратимся к аналогии из реального мира.
Представьте, что вы наняли блестящего научного сотрудника и поместили его в пустую комнату без письменного стола, блокнотов и картотеки. Вы просите его написать исчерпывающий отчет по сложнейшей теме, что требует прочтения десятков книг и удержания в голове каждой цитаты, каждой ссылки и каждого тупикового поиска в идеальном порядке. В конце концов, какими бы интеллектуальными ни были способности ассистента, его когнитивная нагрузка достигнет предела, и он начнет упускать факты или терять нить задания.
Именно так сегодня работают традиционные поисковые агенты. Они обучаются как стратегии на основе растущих стенограмм, что означает: модель ищет, читает, ищет снова и добавляет всё в свое собственное контекстное окно.
Как отметил ведущий исследователь Патрик (Пэнчэн) Цзян из Университета Иллинойса в X: «В какой-то момент модель перестает просто «искать». Ее также просят выполнять роль системы памяти, стенографиста, верификатора и библиотекаря».
Harness-1 решает эту проблему, предоставляя ИИ письменный стол и картотеку — то, что исследовательская группа называет «обвязкой с внешней выгрузкой состояния» (state-externalizing harness).
Эта обвязка представляет собой активное окружающее окружение, которое берет на себя рутинный учет, поддерживая восстанавливаемую рабочую память, включающую пул документов-кандидатов, проверенный набор доказательств с тегами важности, компактные ссылки на доказательства и записи верификации.
Разделяя семантический выбор и управление структурным состоянием, ИИ получает возможность заниматься тем, что удается ему лучше всего.
Стратегия по-прежнему определяет, что искать, решает, какие документы сохранять, и знает, когда остановиться, в то время как окружение просто удерживает состояние.
Ниже представлен подраздел, подробно описывающий методологию обучения и ее отличия от предыдущих поисковых агентов:
Обучение Harness-1: мастер-класс по эффективности данных
Конвейер обучения Harness-1 представляет собой фундаментальный сдвиг в том, как индустрия ИИ подходит к обучению агентов.
Исторически разработчики рассматривали поисковых агентов как стратегии, работающие с массивными, постоянно растущими стенограммами, заставляя алгоритмы обучения с подкреплением (RL) одновременно оптимизировать как семантические рассуждения, так и чистое запоминание поискового состояния.
Создатели Harness-1 выбрали радикально иной подход: поскольку их кастомная «обвязка» берет на себя всю рутинную бухгалтерию — такую как поддержание ссылок на доказательства, пулов кандидатов и записей верификации, — в процессе обучения требовалось лишь научить модель взаимодействовать с этим структурированным интерфейсом.
Это разделение труда кардинально упростило задачи, которые базовой модели с 20 миллиардами параметров действительно нужно было освоить.
Процесс начался с этапа узкоспециализированной контролируемой доводки (Supervised Fine-Tuning, SFT). Вместо сбора петабайтов новых поведенческих данных команда сгенерировала всего 899 отфильтрованных траекторий с помощью агент-преподавателя GPT-5.4, подключенного ровно к той же среде обвязки, которую впоследствии будет использовать модель-студент.
Целью этой фазы SFT было не внедрение огромного объема предметных знаний в модель, а обучение механическому ритму работы хорошего исследователя: как форматировать вызовы инструментов, как тегировать документы по степени важности и какова дисциплина проверки утверждения перед его добавлением в итоговый отобранный набор.
После SFT модель прошла обучение с подкреплением (RL) с использованием алгоритма CISPO, примененного на полных поисковых сессиях с ограничением до 40 шагов.
Команда разработала специфическую функцию терминальной награды, которая явно разделяла обнаружение и отбор. Модель получала вознаграждение не просто за поиск релевантного документа, а за его успешное включение в итоговый набор ответов, в то время как за нахождение ответа без его последующего отбора следовал штраф.
Исследователи также ввели бонус за «разнообразие инструментов»; без этого стимула, как выяснилось, стратегия быстро скатывалась к ленивому поисковому подходу, при котором модель рассылала спам из запросов, избегая более тяжелой работы по чтению и верификации текста.
Что делает Harness-1 действительно инновационной по сравнению с предыдущими разработками, так это ее беспрецедентная эффективность в использовании данных. Вся модель была обучена примерно на 4400 уникальных элементах — 899 траекториях SFT и 3453 запросах RL.
Для сравнения, конкурирующие модели с открытым исходным кодом требовали значительно больших наборов данных для достижения худших результатов: Context-1 использовала более 17 200 обучающих элементов, в то время как Search-R1 опиралась на колоссальные 221 300 элементов для освоения поискового поведения.
Доказывая, что более умная внешняя когнитивная архитектура способна заменить масштабирование данных грубой силой, Harness-1 предполагает, что будущее агентного ИИ кроется в создании лучших сред для работы моделей, а не просто в обучении более крупных моделей на больших объемах данных.
Продукт: корпоративная применимость и генерализация
С продуктовой точки зрения Harness-1 поставляется в виде высокопроизводительного агента с 20B параметрами, интегрированного в базовую архитектуру openai/gpt-oss-20b.
Для корпоративных технологических стеков применимость этого решения огромна, поскольку бизнесу требуется ИИ для проведения многоэтапных исследований в проприетарных базах данных без галлюцинаций и непомерных затрат на вычисления.
Harness-1 обеспечивает передовую производительность при том уровне затрат и задержек, который создатели описывают как «уровень Context-1». Поскольку контекстное окно строго управляется учитывающей бюджет обвязкой, а не постоянно расширяется, компании могут развертывать этого агента автономно, не неся экспоненциальных расходов на токены, обычно сопутствующих долгосрочным задачам ИИ.
Что еще более впечатляет, Harness-1 демонстрирует способность к генерализации далеко за пределами своих обучающих данных. По словам исследовательской группы, обучение обошлось невероятно дешево: было задействовано всего 899 отфильтрованных траекторий контролируемой доводки (SFT) и скромные 3453 запроса обучения с подкреплением (RL).
«Вместо того чтобы обучать модель выживанию в гигантской стенограмме, состоящей только из дополнений, мы учим ее использовать структурированный поисковый интерфейс: искать, отбирать, пересматривать, верифицировать и отправлять», — пояснил Цзян.
Эта экономичность доказывает ключевой факт для индустрии ИИ: разработчикам не обязательно нужны петабайты новых поведенческих данных, если они создают более совершенную когнитивную структуру, в рамках которой модель может функционировать.
Что означает Harness-1 для RAG?
На самом базовом уровне стандартная или «наивная» генерация с привлечением внешних данных (RAG) работает по простому одношаговому конвейеру: пользователь задает вопрос, система ищет в базе данных, а сырые результаты передаются в большую языковую модель (LLM) для генерации ответа. Будучи эффективной для простых запросов, наивная RAG часто дает сбой на сложных корпоративных задачах. Если первоначальный поиск не попадает в цель или если вопрос требует логического связывания подсказок из нескольких документов, система не может динамически адаптироваться — она просто выдает неверный или неполный ответ на основе собранных недостаточных данных.
Harness-1 не отменяет эту парадигму, а скорее совершает колоссальный скачок вперед к тому, что в индустрии все чаще называют «агентной» или «модульной» RAG. Отвечая на вопрос VentureBeat в X о том, сможет ли эта новая модель полностью заменить или исключить необходимость в RAG, ведущий исследователь Цзян уточнил масштаб проекта.
«Я бы не стал говорить, что она заменяет RAG. Harness-1 по-прежнему опирается на поиск и внешние данные, — сказал мне Цзян. — Наша цель — сделать поиск в стиле RAG более агентным и обучаемым за счет вынесения поискового состояния в обвязку и обучения модели эффективному использованию этой среды».
На практике это означает, что Harness-1 спроектирован как идеальный модуль извлечения данных в рамках продвинутой архитектуры ИИ. Вместо того чтобы просто извлекать документы и немедленно заставлять LLM генерировать ответ, Harness-1 действует как автономный субагент. Он может потратить до 40 шагов на активное исследование сложного запроса. На этом этапе он выполняет несколько разнообразных поисковых запросов, читает полные документы, явно сверяет утверждения с текстом и тщательно редактирует приоритетный «отобранный набор» доказательств. Уникальная «обвязка с внешней выгрузкой состояния» данной системы служит организованной рабочей памятью для всего этого процесса, отфильтровывая дубликаты и поддерживая структурированный блокнот лучших подсказок.
Часть RAG, отвечающая за «генерацию», происходит только в самом конце этого исчерпывающего поискового процесса. Как только Harness-1 формирует окончательный вариант отобранного набора документов, он передает этот тщательно проработанный массив данных совершенно отдельной «замороженной» передовой модели — такой как GPT-5.4, Sonnet-4.6 или Opus-4.6, — которая берет на себя роль финального генератора ответа. Четко разделяя тяжелую работу по многоэтапному сбору доказательств и финальный этап написания ответа, Harness-1 доказывает, что предоставление генераторам гораздо более качественного, тщательно отфильтрованного контекста обеспечивает значительно более высокую точность ответов по сравнению с наивными системами RAG.
Лицензирование: сила Apache 2.0
Одним из наиболее значимых аспектов релиза Harness-1 является его лицензирование. Говоря простым языком, Apache 2.0 — это высоко-лояльная, дружественная к бизнесу лицензия на программное обеспечение, которая фундаментально облегчает коммерциализацию.
В отличие от лицензий с «авторским левом» (copyleft, таких как GPL), которые могут обязать компании открывать исходный код собственного проприетарного ПО в случае интеграции кода, или лицензий «только для исследований», полностью запрещающих коммерческое использование, Apache 2.0 дает предприятиям зеленый свет на свободное создание, модификацию и монетизацию технологии.
Для разработчиков и стартапов это означает, что Harness-1 может быть бесшовно интегрирован в коммерческие корпоративные поисковые продукты, инструменты поиска по внутренним данным или ориентированные на клиентов ИИ-приложения без страха перед юридическими последствиями.
Единственное основное требование заключается в том, что пользователи должны включать исходное уведомление об авторских правах и явно указывать любые существенные изменения, внесенные в исходный код, что позиционирует Harness-1 как крайне жизнеспособный фундамент для предприятий.
Реакция сообщества: оглушительное подтверждение успеха
Анонс явно задел за живое разработчиков, подтвердив реальные проблемы, с которыми сталкиваются инженеры при создании агентных систем. Тред Цзян в X с многочастным анонсом быстро набрал огромную популярность, собрав более 256,1 тыс. просмотров, 3,7 тыс. лайков, 2,9 тыс. закладок и почти 300 репостов за считанные дни.
Эта высокая вовлеченность подчеркивает растущий консенсус в сфере ИИ: подход с грубым наращиванием контекстных окон исчерпал себя.
Когда Цзян написал в X: «Я задавался вопросом: может быть, поисковые агенты плохи в поиске отчасти потому, что мы заставляем их выполнять всю бумажную работу в уме», отклик последовал незамедлительно.
Для разработчиков, которые последний год боролись с ИИ-агентами, уверенно забывающими свои основные инструкции на середине поиска по базе данных, подход Harness-1 воспринимается как столь необходимая корректировка курса.
В конечном счете настроения в сообществе отражают сдвиг приоритетов в индустрии. Разработчики отходят от вопроса о том, насколько большим может стать контекстное окно модели ИИ, и вместо этого спрашивают, насколько эффективно окружение модели ИИ может управлять этим контекстом. Перекладывая рутинную работу на внешнюю среду, Harness-1 доказывает, что более мелкие и умные системы способны превосходить гигантов — при условии, что у них есть подходящий рабочий стол.




