


Агент Tongyi от Alibaba бросает вызов OpenAI


В это трудно поверить, но в начале 2025 года китайские генеративные ИИ-модели и агенты широко воспринимались как отстающие по производительности от сопоставимых продуктов американских лабораторий, таких как OpenAI, Anthropic, Google и даже Meta.
Все изменилось с январским релизом DeepSeek в 2025 году, и за прошедшие 8 месяцев этот разрыв сократился еще сильнее. Множество китайских технологических гигантов и стартапов — от Alibaba до Baidu, Z.ai, Kimi, Manus и других — представили впечатляюще мощные ИИ-продукты, причем большинство из них имеют открытый исходный код, доступны для бесплатного использования любому желающему по всему миру, а некоторые из них не уступают платным аналогам высшего эшелона из США или превосходят их.
Теперь этот момент, судя по всему, снова настал для ИИ-агентов — термин, который до сих пор остается в значительной степени размытым в индустрии искусственного интеллекта. Для целей данной статьи мы определим его как продукт генеративного ИИ, способный автономно выполнять многоэтапную работу в течение длительного времени (от 10 минут и дольше) на основе единого блока инструкций, заданных пользователем на естественном языке в свободной форме. Как правило (хотя и не исключительно), они работают на базе большой языковой модели (LLM) или мультимодальной модели.
На этой неделе другая исследовательская команда ИИ в компании Alibaba — Tongyi Lab (не путать с командой Qwen, которая выпускает базовые модели под тем же головным брендом) — представила мощного нового агента с открытым исходным кодом, специально предназначенного для проведения «глубоких исследований» (deep research) по всему интернету и составления тщательных, точных отчетов и других материалов для частных лиц и организаций.
Новый Tongyi DeepResearch Agent вызывает фурор среди продвинутых пользователей и экспертов по искусственному интеллекту по всему миру благодаря своим высоким показателям производительности: по словам его создателей, это «первый полностью открытый веб-агент, достигший производительности на уровне OpenAI Deep Research всего с 30 млрд параметров (активируется 3 млрд)».
Напомним, что параметры — это количество внутренних настроек, определяющих поведение LLM, причем большее число параметров обычно означает более высокую производительность модели. По имеющимся данным, старая модель GPT-4 от OpenAI имела почти 2 триллиона параметров. Чтобы представить 30 миллиардов параметров в перспективе: с учетом того, что при фактической обработке единицы информации (токена) задействуется всего 3 миллиарда, эта модель работает на уровне аналогов, превосходящих ее по размеру в 25 раз, как <отметил в X ИИ-исследователь и разработчик ПО Ахмад Осман (Ahmad Osman):
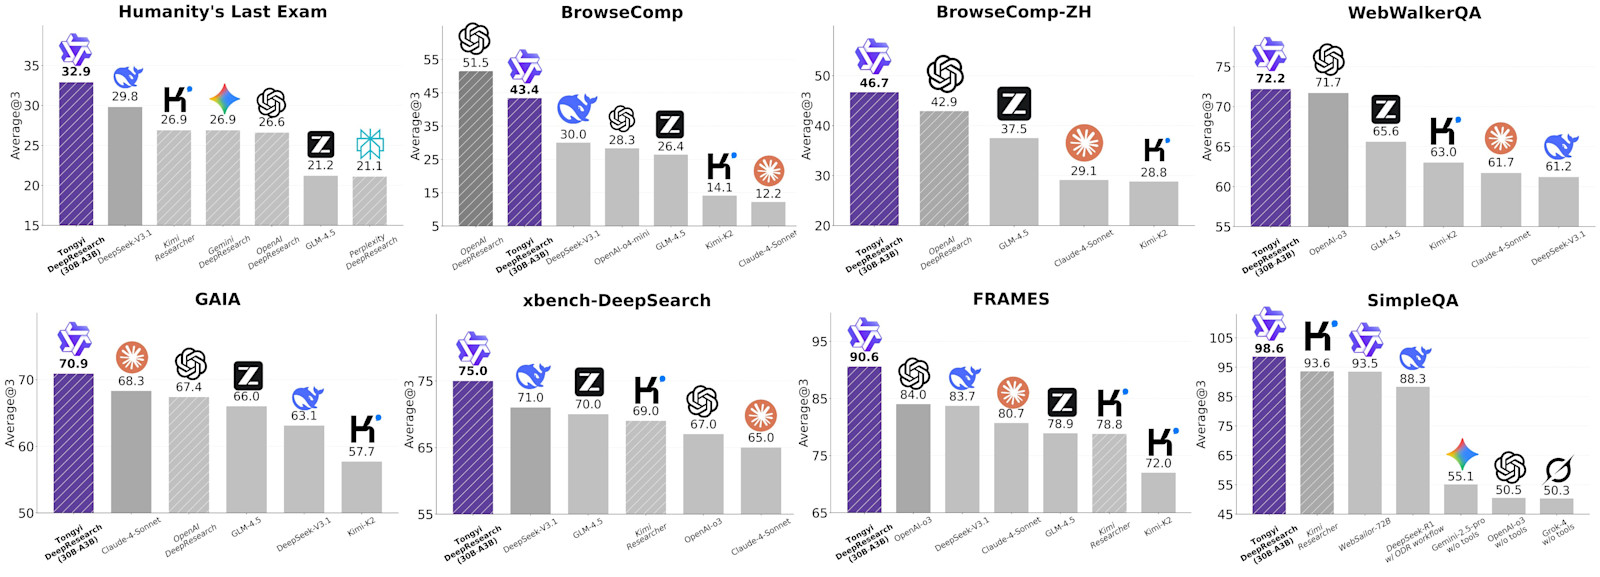
Действительно, бенчмарки, опубликованные Tongyi Lab, показывают, что Tongyi DeepResearch Agent может соперничать со многими более крупными или проприетарными альтернативами или превосходить их. Он набирает:
-
32.9 балла в Humanity’s Last Exam (HLE) — это наивысший результат среди всех протестированных моделей, который превосходит даже o3 от OpenAI.
-
43.4 балла в BrowseComp, приближаясь к показателю OpenAI o3, составляющему 49.7.
-
46.7 балла в BrowseComp-ZH, уступая лишь 58.1 балла от OpenAI o3.
-
75.0 баллов в xbench-DeepSearch.
-
72.2 балла в WebWalkerQA.
-
90.6 баллов в FRAMES — самый высокий показатель среди всех моделей.
Тесты производительности агента Tongyi DeepResearch по состоянию на сентябрь 2025 года. Источник: Alibaba Cloud Tongyi Lab
Эти результаты ставят Tongyi DeepResearch выше других моделей с открытым исходным кодом, таких как DeepSeek V3.1, Kimi K2 и Claude-4-Sonnet, в решении множества задач, несмотря на его относительно скромный размер.
В бенчмарках, ориентированных на юридические исследования, агент Tongyi DeepResearch превосходит агентов OpenAI и Anthropic Claude DeepResearch как по качеству цитирования судебной практики (64.26 против 57.56 и 40.43 соответственно), так и незначительно опережает их по точности ключевых положений (88.28).
Подобно модели Qwen3-30B-A3B LLM, на базе которой он создан, агент Tongyi DeepResearch доступен разработчикам и предприятиям бесплатно — для загрузки, настройки и развертывания (даже для коммерческих приложений, продуктов и рабочих процессов) через HuggingFace, GitHub и ModelScope — на условиях мягкой лицензии Apache 2.0.
Сквозной конвейер обучения агентов
Как исследователям удалось этого добиться?
Представители Tongyi заявляют, что агент был создан с использованием полностью автоматизированного конвейера обучения без привлечения размеченных человеком данных.
В частности, «агент обучается методом проб и ошибок в специализированной, высокостабильной смоделированной среде», которую исследователи создали на основе копии базы знаний Википедии. Это позволило агенту исследовать ее и выполнять действия, которые «точно повторяют условия реального мира», то есть открытого интернета. Данный подход также помог снизить затраты, исключив непредсказуемость и стоимость живых веб-API.
Они также использовали специальную песочницу инструментов (tool sandbox) для обеспечения предсказуемой работы инструментов (например, написания и выполнения агентом кода на Python для структурирования информации в выходных данных), в то время как механизм отбора данных (data curation engine) динамически адаптировал набор обучающих данных в ответ на производительность модели — иными словами, генерировал более изощренные или сложные синтетические данные по мере того, как агент доказывал свою способность с ними справляться. Как исследователи пишут в опубликованной сегодня белой книге (стр. 6), описывая свои методы:
«Качество данных напрямую определяет верхнюю границу способности модели к генерализации на сценарии вне распределения (out-of-distribution) посредством самоисследования. Чтобы решить эту задачу, мы оптимизируем данные в реальном времени под управлением динамики обучения. Эта оптимизация достигается за счет полностью автоматизированного конвейера синтеза и фильтрации данных, который динамически корректирует обучающий набор. Замкнув цикл между генерацией данных и обучением модели, такой подход не только обеспечивает стабильность обучения, но и приносит существенный прирост производительности».
Результатом стала компактная, но мощная модель, которая уже легла в основу реальных инструментов, включая Gaode Mate — ИИ-планировщик путешествий, встроенный в картографический сервис Amap, и Tongyi FaRui, помощника по юридическим исследованиям, который автономно извлекает и цитирует релевантную прецедентную практику и статуты.
Основу релиза DeepResearch составляют две взаимодополняющие агентские модели:
-
AgentFounder-30B, которая специализируется на предварительном обучении агентского поведения с помощью нового метода непрерывного претренинга (continual pretraining); и
-
WebSailor-V2-30B-A3B, которая улучшает постобучение посредством масштабируемого обучения с подкреплением в двойной среде (симуляция + реальность).
Обе модели используют одну и ту же базовую модель Qwen3-30B-A3B и выдают результаты, соперничающие с проприетарными агентами, превосходящими их по размеру в 20 раз.
Определяющей характеристикой Tongyi DeepResearch является конвейер обучения, охватывающий три этапа: непрерывное предварительное обучение агентов (Agentic CPT), обучение с учителем (SFT) и обучение с подкреплением (RL). Такая полностековая структура поддерживает развитие агентских возможностей от «сырых» данных взаимодействия до усовершенствованных многоэтапных рабочих процессов рассуждения.
Для предварительного обучения команда представляет AgentFounder — систематический движок данных, использующий графы знаний, документы и траектории использования инструментов для генерации крупномасштабных синтетических пар «вопрос-ответ».
Ключевой инновацией в AgentFounder является применение двух структурных подходов к моделированию агентского поведения: синтеза действий первого порядка (First-order Action Synthesis, FAS), который создает различные шаги планирования и рассуждения без выполнения инструментов, и синтеза действий высшего порядка (High-order Action Synthesis, HAS), который преобразует отброшенные или частичные траектории агента в наборы данных для пошагового принятия решений, повышая эффективность выборки и разнообразие.
Эти данные дополнительно уточняются с помощью формальных методов, включая моделирование структур рассуждений на основе теории множеств, что обеспечивает контролируемую сложность и масштабируемость.
Финальный этап RL использует модифицированный алгоритм групповой относительной оптимизации политики (Group Relative Policy Optimization, GRPO). Он применяет обучение на политике (on-policy learning) с градиентной оптимизацией на уровне токенов, оценкой преимуществ по методу исключения одного (leave-one-out) и тщательной фильтрацией низкокачественных негативных примеров.
Команда сообщает о стабильном росте сигналов вознаграждения и устойчивом поисковом поведении, связывая это во многом со структурой и качеством своих синтетических обучающих данных, а не только с настройками алгоритмов.
Модель WebSailor-V2, обученная в рамках этого стека, достигает 35.3 баллов в BrowseComp-EN, 44.1 в BrowseComp-ZH и 30.6 в HLE — результатов, которые превосходят все базовые показатели с открытым исходным кодом и бросают вызов моделям OpenAI и DeepSeek, превышающим ее по размеру более чем в 10 раз.
Два режима инференса: ReAct и Heavy Mode
Tongyi DeepResearch поддерживает два режима работы при инференсе:
-
Режим ReAct (ReAct Mode) – Этот режим следует циклу «Мысль-Действие-Наблюдение» (Thought-Action-Observation), демонстрируя возможности модели без сложного промптинга. Он предлагает простой способ оценки производительности агентов в чистой, повторяемой среде.
-
Тяжелый режим (Heavy Mode) – Построенный на базе парадигмы IterResearch, этот подход позволяет избежать недостатков излишне длинных контекстов за счет разбиения исследовательских задач на отдельные раунды. Каждый раунд воссоздает сфокусированное рабочее пространство, позволяя агенту решать, продолжать ли сбор информации или синтезировать ответ. Для особо сложных задач несколько таких циклов могут запускаться параллельно, а итоговый агент-синтезатор объединяет результаты.
Этот многоагентный механизм исследования и синтеза помогает модели эффективнее управлять когнитивной нагрузкой при выполнении многоэтапных задач, что команда называет ключевым фактором для расширения возможностей рассуждения до пределов 128-килобайтного контекстного окна модели.
В ходе тестов модель демонстрирует явное улучшение масштабируемости в плане эффективности инструментов и использования контекста, превосходя даже модели на 355B и 671B параметров (GLM-4.5 и DeepSeek-V3.1) как по длинному контексту, так и при ограниченном бюджете инструментов.
Реальные сценарии использования, уже внедренные в практику
Хотя техническая архитектура разработана для универсальных агентских рассуждений, Tongyi DeepResearch уже нашла применение в практических приложениях:
-
Gaode Mate: В сотрудничестве с Amap (Gaode) лаборатория Tongyi разработала внутриприложенного ИИ-помощника по имени Сяо Гао (Xiao Gao). Он поддерживает планирование поездок на естественном языке, осуществляя поиск живописных мест, определяя отели, дружелюбные к домашним животным, и составляя персонализированные маршруты при минимальном вводе данных от пользователя.
-
Tongyi FaRui: Этот агент для юридических исследований выполняет задачи, аналогичные тем, с которыми справляется начинающий юрист. Он осуществляет поиск прецедентного права, перекрестные ссылки на соответствующие статуты и синтезирует результаты в структурированные отчеты. В число результатов входят прямые цитаты, номера дел и статьи законов, что обеспечивает прозрачность и юридическую обоснованность.
Растущее семейство агентских моделей
Tongyi DeepResearch опирается на более широкую научно-исследовательскую работу команды Tongyi Lab. За последние шесть месяцев они выпустили целое семейство агентов, в том числе:
-
WebWalker (веб-обход),
-
WebSailor и WebSailor V2 (навигация с элементами рассуждения),
-
WebShaper (моделирование задач),
-
WebResearch (рассуждения на длинных горизонтах планирования),
-
WebWeaver (структурированные веб-свидетельства),
-
WebResummer, WebWatcher и другие.
Каждая субмодель вносит свой вклад либо в процесс генерации данных, либо предоставляет специфичные для задач инсайты в отношении различных аспектов агентских рассуждений. В совокупности эти исследования представляют собой одно из наиболее исчерпывающих исследований глубоких исследовательских агентов с открытым исходным кодом на сегодняшний день.
По словам исследователей Tongyi, эти агенты разделяют общую философию проектирования: обоснование рассуждений и синтеза в рабочих процессах агентского взаимодействия, а не просто статическая генерация текста. Это позволяет моделям лучше обобщать знания для работы в динамичных средах и долгосрочных задачах — и может сигнализировать о следующем этапе эволюции инструментов ИИ с открытым исходным кодом.
Ограничения и дальнейшие шаги
Команда признает наличие некоторых текущих ограничений. Контекстное окно в 128 000 токенов, хотя и эквивалентно объему информации 300–400-страничного романа, которым можно обменяться в рамках одного взаимодействия «ввод-вывод» с моделью, все же может оказаться недостаточным для самых масштабных и сложных задач. В настоящее время оно уступает стандартному окну в 256 000 токенов и более, предлагаемому GPT-5 от OpenAI и многими другими ведущими проприетарными моделями.
Кроме того, методы, использованные в Tongyi DeepResearch, пока не тестировались в масштабах, превышающих 30 миллиардов параметров.
Впереди также предстоит работа по дальнейшей оптимизации обучения с подкреплением с помощью таких методов, как частичный разверт (partial rollouts), хотя это потребует решения проблем, связанных с обучением вне политики (off-policy training).
Более фундаментально: исследователи Tongyi утверждают, что существующие методы оценки, такие как имитация траекторий или статическая проверка правильности ответов на вопросы, не в полной мере отражают возможности агентов. Их предложение сместить фокус в сторону пошагового контроля решений может указать путь вперед для всей сферы агентского искусственного интеллекта.
Даже с учетом этих оговорок, выпуск Tongyi DeepResearch знаменует собой значимый шаг вперед в развитии агентов с открытым исходным кодом.
Публикуя модель, инструменты, методы обучения и результаты, Tongyi Lab приглашает более широкое исследовательское сообщество присоединиться к работе, расширять возможности и тестировать новые идеи в этой развивающейся области.




