


Nemotron 3.5 и Switchyard от Nvidia сокращают расходы на ИИ-агентов
Источник: VentureBeat · Sean Michael Kerner


Предприятия, запускающие постоянно работающие ИИ-агенты, постоянно сталкиваются с одной и той же дилеммой. Отправка каждой задачи передовой модели быстро приводит к росту счетов. Создание собственной логики маршрутизации для перенаправления простых задач на более дешевые модели превращается в отдельный инженерный проект, который приходится поддерживать при каждом изменении рабочего процесса.
Nvidia предлагает решение, которое одновременно устраняет обе стороны этой проблемы. Во вторник компания представила Nemotron 3.5 Lightning — открытую 30-миллиардную модель на основе смеси экспертов (MoE), созданную для специализированных задач агентов с высоким объемом вычислений, а также NeMo Switchyard — библиотеку с открытым исходным кодом, которая направляет каждый шаг рабочего процесса агента к наиболее подходящей для него модели.
Главные цифры: по заявлению Nvidia, Lightning обеспечивает скорость генерации до 4 раз выше, чем у сопоставимых моделей своего класса, выполняя задачи агентов примерно на 30% быстрее, чем Qwen3.6-35B, при аналогичной точности. По словам представителей Nvidia, в связке с Switchyard эта комбинация сохраняет качество выполнения задач на уровне передовых моделей, при этом снижая затраты по бенчмаркам примерно до трети от стоимости работы одного лишь Opus 4.8.
Этот анонс ставит Nvidia в самый центр самого активного периода развития моделей с открытыми весами в отрасли за последние месяцы. Начиная с весны, компании Alibaba, Moonshot, Zhipu и DeepSeek выпустили из Китая конкурентоспособные открытые модели, причем некоторые из них достигли производительности на уровне передовых систем (или близко к нему), превосходя американские лаборатории по параметрам размера или цены. Meta добавила давления на рынок, выпустив собственную 30-миллиардную открытую агентскую модель Muse Glimmer. Модели с открытыми весами за считанные месяцы превратились из уникального преимущества в базовое требование рынка, и релиз Nvidia идеально вписывается в этот тренд, а не опережает его.
Главная идея кроется в синергии. Сама по себе модель не решает проблему затрат, а у отдельного маршрутизатора нет эффективных целей для перенаправления. Nvidia делает ставку на то, что открытый исходный код, применяемый как на уровне моделей, так и на уровне маршрутизации, — это то, что реально снижает затраты на агентский ИИ, а не единичная более дешевая модель или умный маршрутизатор, прикрученный к чужому стеку.
Реальными соперниками Switchyard являются не другие открытые модели, а Not Diamond, которая уже обеспечивает работу режима Auto в OpenRouter, и RouteLLM — фреймворк с открытым исходным кодом от UC Berkeley и LMSYS. Ни одна из них не поставляет собственную модель. Ставка Nvidia заключается в том, что контроль над обеими сторонами задачи в рамках одной открытой лицензии — это то, с чем не смогут конкурировать решения, состоящие только из маршрутизатора или только из модели.
«В этом и заключается сила системы моделей: подбор правильной модели для каждого этапа рабочего процесса», — отметила в ходе брифинга Кари Бриски (Kari Briski), вице-президент по генеративному ИИ в Nvidia.
Как маршрутизатор меняет рабочий процесс на практике
Маршрутизация моделей — далеко не новая концепция. OpenRouter, LiteLLM и горстка независимых стартапов в сфере маршрутизации уже позволяют разработчикам распределять трафик между несколькими провайдерами. Switchyard интегрируется с некоторыми из них, а не заменяет их полностью.
Основная проблема, которую решает Switchyard, заключается в том, что оптимальная модель меняется по мере того, как агент продвигается по задаче. Состояние агента меняется по мере возврата результатов инструментами, появления ошибок или когда шаг оказывается рутинным, а не сложным, и фиксированный выбор модели не способен ко всему этому адаптироваться.
Бриски описала стратегии маршрутизации, которые реагируют на это меняющееся состояние, а не на статичную категорию задач.
«Существует множество типов стратегий маршрутизации, — сказала Бриски. — У вас может быть случайный маршрутизатор, что не так уж здорово, либо маршрутизатор на основе состояния агента или классификатора. В зависимости от стратегии маршрутизации он стремится выбрать лучшую модель. В некоторых случаях для действительно эффективных задач вы хотите использовать такую модель, как Lightning, и маршрутизатор выберет именно Lightning, если она настроена в вашем пуле моделей».
Стоимость учитывается при принятии решения о маршрутизации напрямую, а не по остаточному принципу. Отвечая на вопрос издания VentureBeat, Бриски сообщила, что Switchyard может оценивать «многословность» модели (то есть количество токенов, которое данная модель обычно генерирует для задачи) и использовать этот прогноз для направления работы на более дешевый вариант до совершения вызова.
Избежать превращения этого процесса в отдельный сложный проект интеграции позволяет расположение самого Switchyard. Nvidia разделила своих партнеров на две группы: агентские фреймворки, которые вызывают Switchyard напрямую (включая Cognition, LangChain и Nous Research), и LLM-шлюзы, которые встроили поддержку Switchyard в собственные продукты (включая Kong, LiteLLM и OpenRouter). Kong поставляет Switchyard в составе Kong AI Gateway «из коробки». Бриски сослалась на этот же список партнеров-шлюзов, описывая интеграцию библиотеки в существующую экосистему маршрутизации.
«Мы любим экосистемы и хотим убедиться, что интегрированы в них, — заявила Бриски. — Мы стали партнерами OpenRouter, LiteLLM и Kong, и они уже интегрировали наш алгоритм маршрутизации, так что вы можете начать использовать его прямо там, где уже работаете с лучшими инструментами».
Nvidia поделилась результатами тестирования Switchyard девятью компаниями, причем некоторые привели конкретные цифры. LangChain сообщила о сокращении затрат на 74% при выполнении 145 многошаговых задач Deep Agents за счет перенаправления всего 7% вызовов на передовую модель при падении точности на 6%. В компании Ramp заявили, что достигли производительности передовой модели на платформе Ramp SWE-Bench, снизив затраты на 58% и сократив время выполнения на 33%. Компания Cognition внедрила поэтапный маршрутизатор Switchyard в Devin Desktop для внутреннего использования и сообщила о производительности, близкой к передовой, на FrontierCode Main, одновременно сократив средние затраты на 28% по сравнению с маршрутизацией всех запросов на единую передовую модель.
Архитектура Lightning и прирост производительности
Nemotron 3.5 Lightning — это самостоятельная открытая модель, созданная для специализированных агентских задач с высокой интенсивностью запросов, а не для общего применения.
Она развивает гибридную архитектуру Mamba-Transformer на основе скрытой смеси экспертов (MoE), представленную Nvidia в семействе Nemotron 3 в декабре 2025 года. Это та же линейка, что и Nemotron 3 Super, которую Nvidia использует в качестве базовой линии Lightning при сравнении результатов после посттренировки. В рамках настройки маршрутизации, подобной Switchyard, модель призвана занимать быструю и дешевую часть процесса принятия решений, а не премиальную, однако она работает и поставляется независимо от какого-либо маршрутизатора.
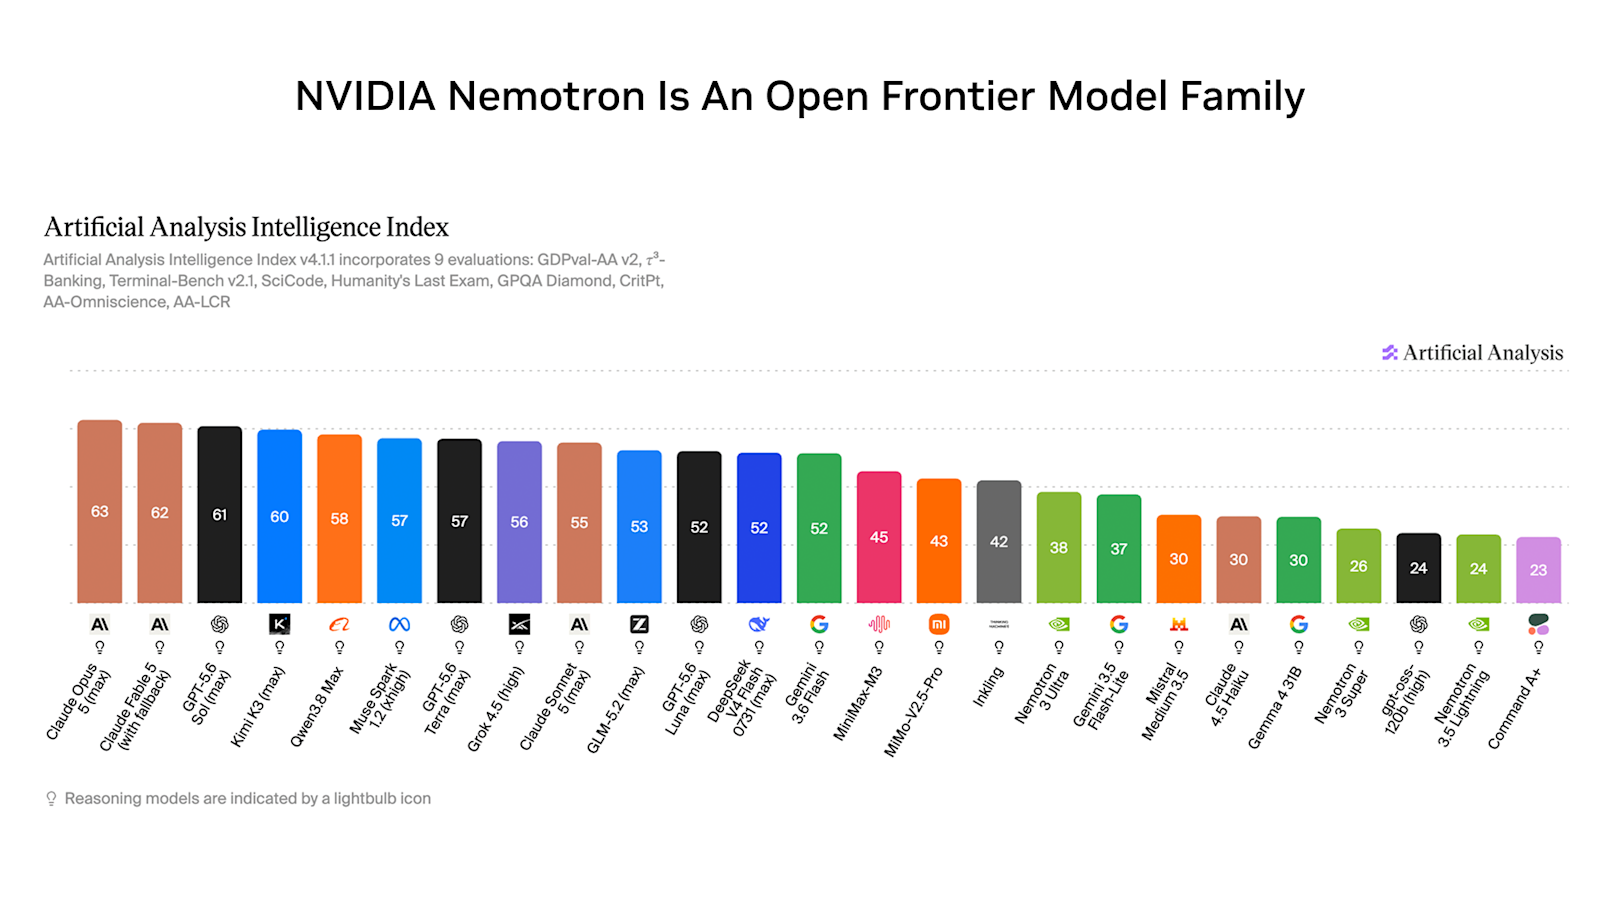
Согласно индексу искусственного интеллекта Artificial Analysis Intelligence Index, оценивающему общие возможности по девяти бенчмаркам, Lightning получает 24 балла, разделяя позицию с gpt-oss-120b и уступая Nemotron 3 Super, Gemma 4 31B, Claude 4.5 Haiku и Mistral Medium 3.5 (у всех по 30 баллов). Lightning не является лидером общего интеллекта в своем классе размеров, и Nvidia на это не претендует.
Реальное заявление звучит скромнее: согласно данным бенчмарка PinchBench, предоставленным Nvidia, Lightning достигает точности Qwen3.6-35B примерно на 30% быстрее и превосходит точность Gemma 4 26B за аналогичное время выполнения на PinchBench — реальном тестовом наборе агентских задач, охватывающем программирование, исследования и управление файлами. Это компромисс между скоростью и точностью, а не победа в абсолютных возможностях.
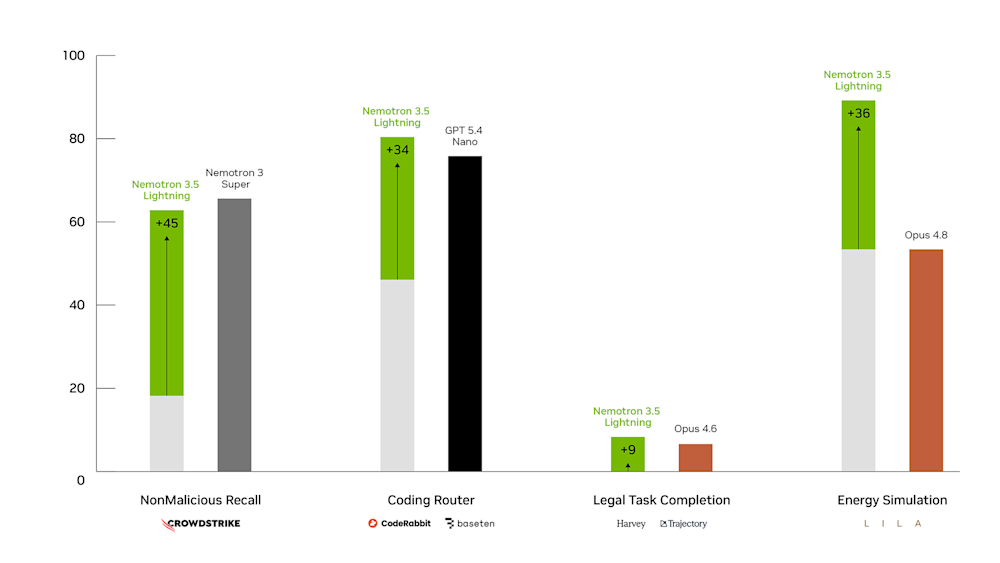
Посттренировка — это область, где, по заявлению Nvidia, проявляются наиболее существенные улучшения. Компания поделилась показателями «до и после» от четырех ранних партнеров: CrowdStrike (выявление вредоносного контента на базе Nemotron 3 Super), CodeRabbit (маршрутизация кода на базе GPT 5.4 Nano), Harvey и Trajectory (решение юридических задач на базе Opus 4.6), а также Lila Sciences (моделирование энергетики на базе Opus 4.8). Кейс CodeRabbit является наиболее конкретным: по словам Nvidia, стандартная рецептура модели NeMo Auto, обученная за одну эпоху, была встроена в рабочий агент-маршрутизатор всего за два часа при затратах в 85 долларов.
Источник: Nvidia
Что это значит для бизнеса
На растущем рынке открытых моделей нет недостатка в конкурентных предложениях. Новый релиз Nemotron Lightning станет еще одним вариантом, который организации могут взять на вооружение.
Что касается самих моделей, то на графике бенчмарков Lightning в качестве прямой точки для сравнения выбрана Qwen3.6-35B. Отвечая напрямую на вопрос VentureBeat о том, как Lightning соотносится с китайскими моделями в целом, Бриски не стала приводить результаты прямого сопоставления, указав вместо этого на открытость и возможности кастомизации как на главное отличие.
«Наше ценностное предложение заключается не просто в открытости, оно обладает высокой настраиваемостью», — сказала Бриски.
Для предприятий, создающих инфраструктуру для агентов, выделяются три ключевых тренда:
Принятие решений о маршрутизации становится динамичным, а не статичным. Предприятия, построившие конвейеры агентов вокруг одной модели по умолчанию, переходят на пошаговую маршрутизацию на основе живых сигналов, таких как состояние агента и стоимость токенов, вместо фиксированного назначения, заданного на этапе проектирования.
Открытый код теперь снижает затраты на двух уровнях, а не на одном. Связка открытой модели с открытым маршрутизатором, контролируемым одним вендором от начала и до конца, — это более сильный аргумент, чем просто более дешевые веса, и стоит проследить, последуют ли другие лаборатории этому примеру.
Конкурентный фокус смещается от лучшей модели к лучшей системе. По мере того как библиотеки маршрутизации развиваются, ключевым фактором дифференциации становится не то, какую модель предприятие выбирает по умолчанию, а то, насколько эффективно его уровень маршрутизации сопоставляет модели с задачами в рабочей среде. Это сложнее измерить в бенчмарках и сложнее продвигать на рынке.




