


LinkedIn объединяет ленту с помощью системы на базе языковых моделей (LLM)
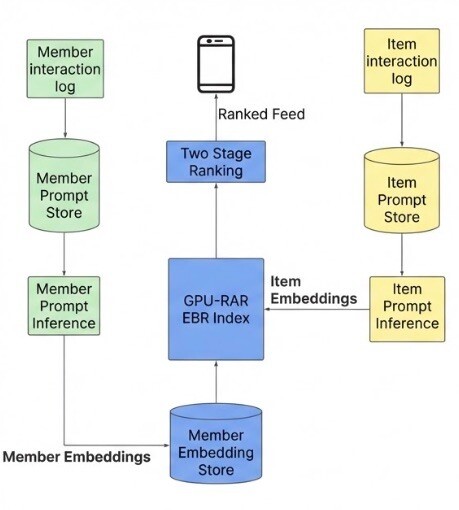


Лента LinkedIn охватывает более 1,3 миллиарда пользователей, однако ее архитектура перестала успевать за этим ростом. В системе накопилось пять отдельных конвейеров извлечения данных — каждый со своей инфраструктурой и логикой оптимизации, — которые обслуживали различные разделы того, что пользователи могли бы увидеть. Инженеры компании потратили последний год на то, чтобы демонтировать эту систему и заменить ее единым решением на базе LLM. По заявлению LinkedIn, в результате получилась лента, которая точнее понимает профессиональный контекст и обходится дешевле в обслуживании при масштабном использовании.
Масштабная переработка затронула три уровня стека: способ извлечения контента, алгоритм его ранжирования и управление базовыми вычислительными ресурсами. Тим Юрка (Tim Jurka), вице-президент по разработке в LinkedIn, рассказал VentureBeat, что за последний год команда провела сотни тестов, прежде чем достичь рубежа, который, по его словам, позволил полностью обновить значительную часть инфраструктуры.
«Начав со всей нашей системы извлечения контента, мы перешли на использование крупномасштабных LLM, чтобы гораздо глубже понимать контент в LinkedIn и иметь возможность подбирать его для пользователей на гораздо более персонализированной основе, — отметил Юрка. — Вплоть до методов ранжирования контента с использованием поистине огромных секвенциальных моделей и генеративных рекомендательных систем, объединив эту сквозную систему для того, чтобы сделать контент гораздо более релевантным и значимым для участников».
Одна лента, 1,3 миллиарда пользователей
Основная сложность, по словам Юрки, носит двусторонний характер: LinkedIn должна сопоставлять заявленные профессиональные интересы пользователей — их должность, навыки, отрасль — с их реальным поведением с течением времени, а также выводить на поверхность контент, который выходит за рамки публикаций их ближайшей сети. Эти два сигнала часто тянут систему в разные направления.
Люди используют LinkedIn по-разному: одни стремятся установить контакты с коллегами по отрасли, другие отдают приоритет идейному лидерству, а соискатели и рекрутеры используют платформу для поиска подходящих кандидатов.
Как LinkedIn объединила пять конвейеров в один
LinkedIn потратила более 15 лет на создание систем рекомендаций на базе искусственного интеллекта, в том числе наработки в области поиска работы и специалистов. Лента LinkedIn — та самая, которая встречает вас при открытии сайта, — была построена на гетерогенной архитектуре, сообщила компания в своем блоге. Контент поступал пользователям из различных источников, включая хронологический индекс сети пользователя, геотаргетинговые тренды, фильтрацию по интересам, отраслевой контент и другие системы на основе эмбеддингов.
По словам представителей компании, такой подход означал, что каждый источник имел собственную инфраструктуру и стратегию оптимизации. Но хотя это работало, затраты на обслуживание резко возросли. Юрка отметил, что использование LLM для масштабирования нового рекомендательного алгоритма также потребовало обновления сопутствующей архитектуры ленты.
«Здесь задействовано множество аспектов, включая то, как мы поддерживаем такой контекст участника в промпте, обеспечивая подачу правильных данных для наполнения модели, данных профиля, истории недавней активности и т. д., — пояснил он. — Второе — это то, как вы фактически выбираете наиболее значимые точки данных для последующей тонкой настройки (fine-tuning) LLM».
LinkedIn тестировала различные итерации сочетания данных в офлайн-среде тестирования.
Одной из первых трудностей при обновлении системы извлечения данных в LinkedIn стала конвертация данных в текстовый формат, пригодный для обработки большими языковыми моделями. Для этого компания создала библиотеку промптов, позволяющую генерировать шаблонные последовательности. Для публикаций внимание было сосредоточено на формате, информации об авторе, количестве взаимодействий, метаданных статьи и тексте самого поста. Для пользователей специалисты интегрировали данные профиля, навыки, историю работы, образование и «хронологически упорядоченную последовательность постов, с которыми они ранее взаимодействовали».
Одним из самых важных открытий на этапе тестирования стало то, как LLM работают с числами. Когда у поста было, например, 12 345 просмотров, эта цифра появлялась в промпте как «views:12345», и модель воспринимала ее как любой другой текстовый токен, лишая значимости сигнала о популярности. Чтобы исправить это, команда разделила показатели вовлеченности по перцентилям и обернула их в специальные токены, благодаря чему модель научилась отличать их от неструктурированного текста. Это вмешательство существенно улучшило способность системы оценивать охват публикаций.
Обучение ленты воспринимать профессиональную историю как последовательность
Разумеется, если LinkedIn хочет сделать ленту более персональной, а публикации — доносить до нужной аудитории, ей необходимо переосмыслить и подход к ранжированию постов. По утверждению компании, традиционные модели ранжирования неверно истолковывают то, как люди взаимодействуют с контентом: этот процесс не случаен, а подчиняется закономерностям, вытекающим из чьего-либо профессионального пути.
Для своей ленты LinkedIn создала проприетарную генеративную рекомендательную модель Generative Recommender (GR), которая рассматривает историю взаимодействий как последовательность или «профессиональную историю, рассказанную через посты, с которыми вы взаимодействовали с течением времени».
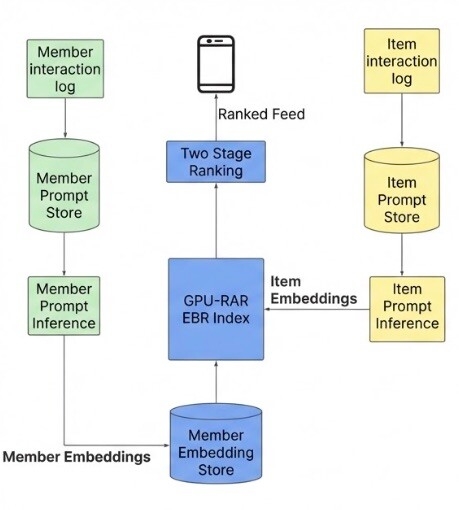
Источник: LinkedIn
«Вместо того чтобы оценивать каждый пост изолированно, GR обрабатывает более тысячи ваших прошлых взаимодействий, чтобы понять временные закономерности и долгосрочные интересы, — говорится в блоге LinkedIn. — Как и в случае с извлечением данных, модель ранжирования опирается на профессиональные сигналы и паттерны вовлеченности, полностью исключая демографические признаки, и регулярно проходит аудиты на предмет справедливого отношения ко всей нашей пользовательской базе».
Вычислительные затраты на запуск LLM в масштабах LinkedIn
Столкнувшись с необходимостью модернизации конвейера данных и ленты, LinkedIn столкнулась с еще одной проблемой: стоимостью графических процессоров (GPU).
Компания вложила значительные средства в новую инфраструктуру обучения, чтобы снизить нагрузку на графические процессоры. Крупнейшим архитектурным изменением стало разделение обработки признаков на CPU и ресурсоемкого инференса моделей на GPU — это позволило каждому типу вычислительных средств выполнять профильные задачи и избавило систему от узких мест, связанных с доступностью видеопамяти. Кроме того, команда написала собственные средства загрузки данных на C++, чтобы сократить накладные расходы, которые создавала многопроцессорность Python, а также разработала кастомный вариант Flash Attention для оптимизации вычислений механизмов внимания во время инференса. Механизмы контрольных точек (checkpointing) были распараллелены вместо последовательного выполнения, что помогло выжать максимум из доступной памяти GPU.
«Одной из задач, которую нам пришлось решать инженерным путем, была необходимость использовать гораздо больше графических процессоров, чем нам хотелось бы, — сказал Юрка. — Крайне важно осознанно подходить к координации рабочей нагрузки между CPU и GPU, поскольку приятная особенность такого рода LLM и контекста промптов, которые мы используем для генерации эмбеддингов, заключается в возможности их динамического масштабирования».
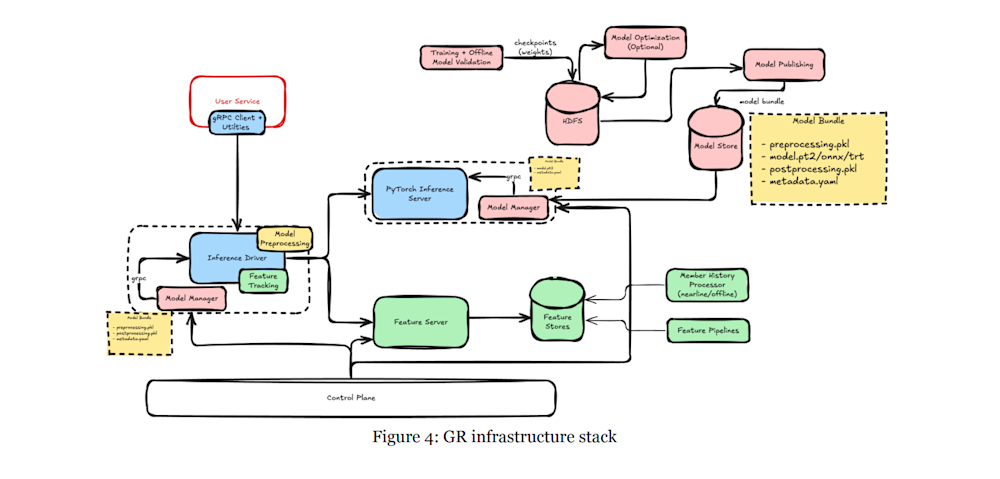
Источник: LinkedIn
Для инженеров, создающих рекомендательные системы или системы извлечения данных, редизайн от LinkedIn служит наглядным примером того, что на самом деле требуется для замены фрагментированных конвейеров единой моделью эмбеддингов: переосмысление представления числовых сигналов в промптах, осознанное разделение нагрузок между CPU и GPU, а также создание моделей ранжирования, которые воспринимают историю пользователя как последовательность, а не как набор независимых событий. Главный урок заключается вовсе не в том, что LLM волшебным образом решают проблемы ленты — а в том, что их масштабное развертывание заставляет решать совершенно иной класс задач по сравнению с теми, с которых все начиналось.




