


Модели gpt-oss-safeguard от OpenAI повышают безопасность ИИ


Стремясь обеспечить соответствие используемых ими моделей ИИ правилам безопасности и безопасного использования, предприятия дорабатывают большие языковые модели (LLM), чтобы они не реагировали на нежелательные запросы.
Тем не менее, значительная часть работы по обеспечению безопасности и тестированию на проникновение (red teaming) происходит до развертывания, что «зашивает» политики в модель еще до того, как пользователи смогут полностью протестировать ее возможности в рабочей среде. В OpenAI считают, что могут предложить предприятиям более гибкий вариант и побудить больше компаний внедрять политики безопасности.
Компания выпустила две модели с открытыми весами в рамках исследовательской версии (research preview), которые, по ее мнению, сделают предприятия и модели более гибкими с точки зрения средств защиты. Модели gpt-oss-safeguard-120b и gpt-oss-safeguard-20b будут доступны по разрешительной лицензии Apache 2.0. Они представляют собой доработанные версии открытой модели OpenAI gpt-oss, выпущенной в августе, что знаменует собой первый релиз в семействе oss с лета.
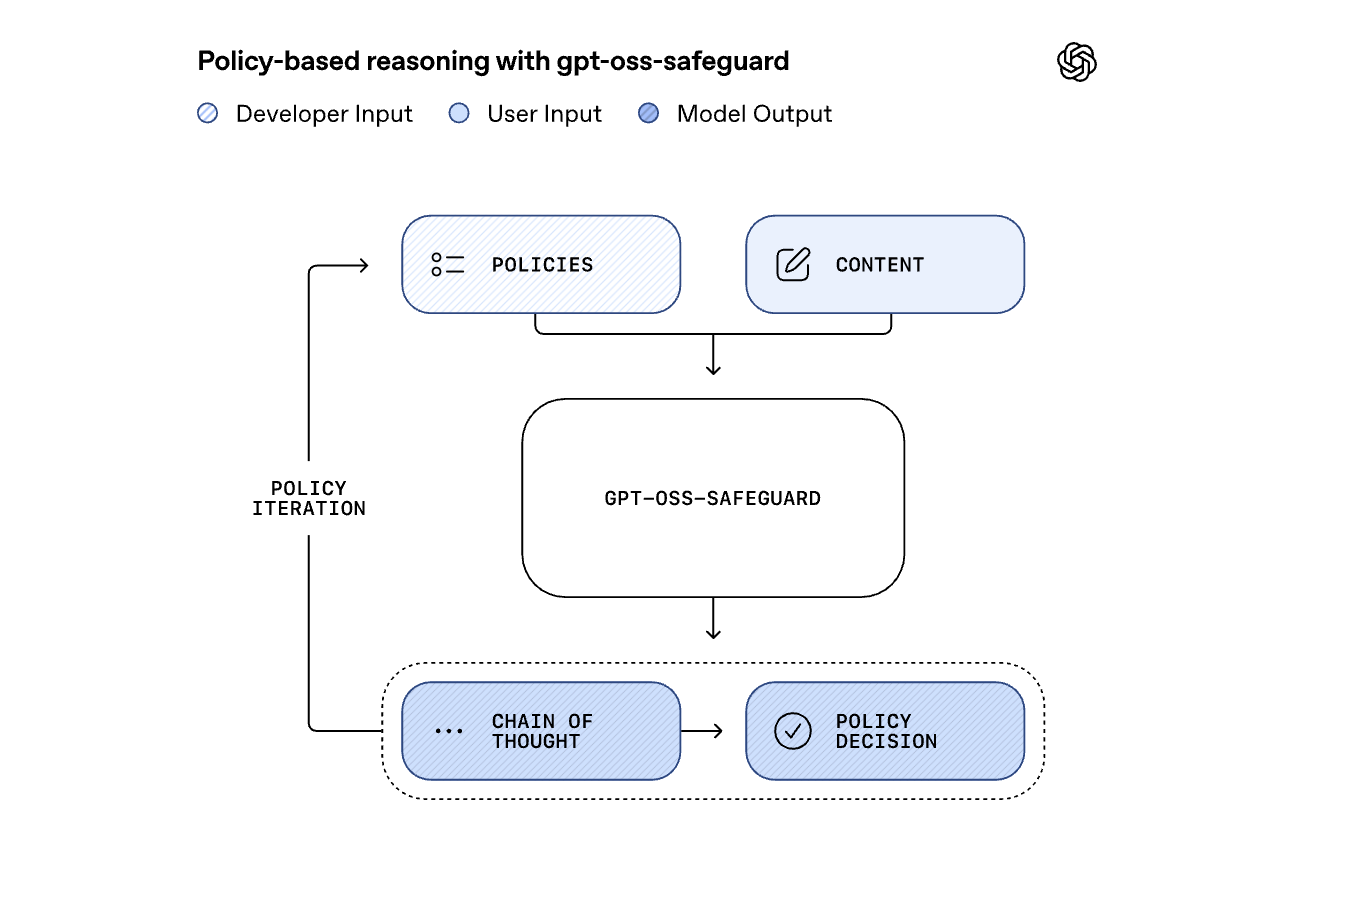
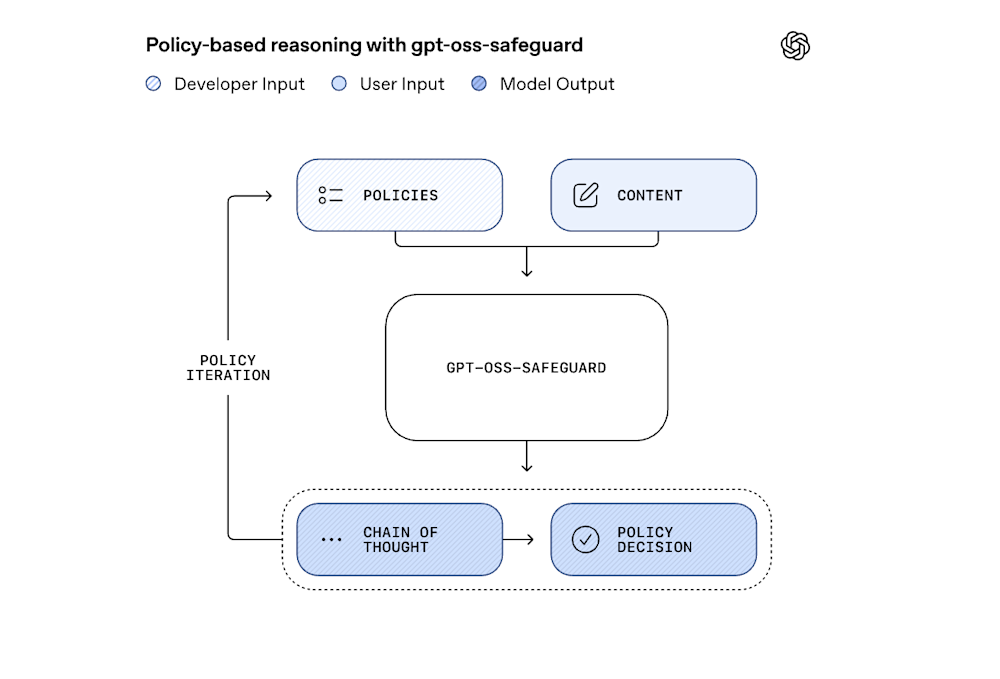
В своем блоге компания OpenAI сообщила, что oss-safeguard использует рассуждения «для непосредственной интерпретации политики разработчика-провайдера во время инференса, классифицируя сообщения пользователей, ответы и полные чаты в соответствии с потребностями разработчика».
Компания пояснила, что поскольку модель использует цепочку рассуждений (chain-of-thought, CoT), разработчики могут получать объяснения решений модели для проверки.
«Кроме того, политика предоставляется во время инференса, а не закладывается в модель в процессе обучения, поэтому разработчикам легко итеративно пересматривать политики для повышения производительности, — говорится в посте OpenAI. — Этот подход, который мы изначально разработали для внутреннего использования, значительно гибче традиционного метода обучения классификатора косвенному выведению границ решений на основе большого количества размеченных примеров».
Разработчики могут загрузить обе модели с платформы Hugging Face.
Гибкость против жесткой интеграции
Изначально модели ИИ не знают предпочтительных для компании триггеров безопасности. Хотя поставщики моделей тестируют модели и платформы на проникновение, эти средства защиты предназначены для более широкого использования. Такие компании, как Microsoft и Amazon Web Services, даже предлагают платформы для внедрения защитных барьеров (guardrails) в приложения ИИ и агентов.
Предприятия используют классификаторы безопасности, чтобы помочь обучить модель распознавать шаблоны хороших или плохих входных данных. Это помогает моделям усвоить, на какие запросы не следует отвечать. Это также помогает гарантировать, что модели не будут отклоняться от темы и станут отвечать точно.
«Традиционные классификаторы могут обеспечивать высокую производительность при низкой задержке и минимальных операционных расходах, — заявили в OpenAI. — Но сбор достаточного количества обучающих примеров может потребовать времени и затрат, а обновление или изменение политики требует повторного обучения классификатора».
Источник: OpenAI
Модель принимает на вход два параметра одновременно, прежде чем выдать заключение о том, в чем именно контент не соответствует требованиям. Она принимает политику и контент для классификации в соответствии со своими руководящими принципами. В OpenAI отметили, что модели лучше всего работают в следующих ситуациях:
-
Потенциальный вред является новым или эволюционирующим, и политики должны быстро адаптироваться.
-
Сфера применения крайне неоднозначна, и с ней сложно справиться меньшим по размеру классификаторам.
-
У разработчиков недостаточно примеров для обучения высококачественного классификатора для каждого риска на их платформе.
-
Задержка имеет меньшее значение, чем получение высококачественных, поддающихся объяснению результатов классификации.
В компании отметили, что модель gpt-oss-safeguard «отличается тем, что ее возможности рассуждения позволяют разработчикам применять любую политику», даже те, которые они написали во время инференса.
Модели созданы на основе внутреннего инструмента OpenAI — Safety Reasoner, который позволяет командам компании более итеративно подходить к настройке защитных барьеров. Они часто начинают с очень строгих политик безопасности «и используют относительно большие объемы вычислительных ресурсов там, где это необходимо», а затем корректируют политики по мере внедрения модели в производство и изменения оценок рисков.
Обеспечение безопасности
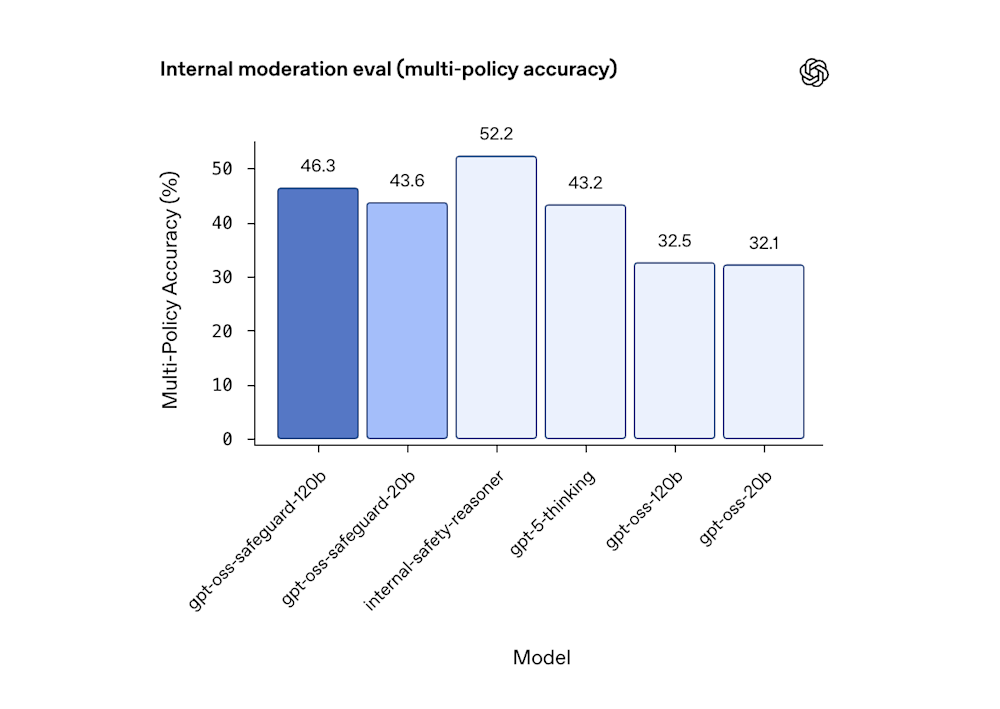
По данным OpenAI, модели gpt-oss-safeguard превзошли GPT-5-thinking и оригинальные модели gpt-oss по точности применения нескольких политик (multipolicy accuracy) на основе бенчмарк-тестирования. Компания также протестировала модели на публичном бенчмарке ToxicChat, где они показали хорошие результаты, хотя GPT-5-thinking и Safety Reasoner незначительно их опередили.
Источник: OpenAI
Однако существует опасение, что такой подход может привести к централизации стандартов безопасности.
«Безопасность — нечетко определенное понятие. Любая реализация стандартов безопасности будет отражать ценности и приоритеты создавшей ее организации, а также ограничения и недостатки ее моделей», — считает Джон Тикстон (John Thickstun), доцент кафедры компьютерных наук Корнельского университета. — Если индустрия в целом примет стандарты, разработанные OpenAI, мы рискуем институционализировать одну конкретную перспективу безопасности и заблокировать более широкие исследования потребностей безопасности для развертывания ИИ в различных секторах общества».
Стоит также отметить, что OpenAI не выпустила базовую модель для семейства oss, поэтому разработчики не могут полностью дорабатывать ее самостоятельно.
Тем не менее, в OpenAI уверены, что сообщество разработчиков сможет помочь усовершенствовать gpt-oss-safeguard. Компания проведет хакатон 8 декабря в Сан-Франциско.




