


Гиперсети и автономность ИИ-агентов: объяснение


Корпоративные команды снова и снова наблюдают одну и ту же картину. ИИ-агент прекрасно демонстрирует себя на презентации, отправляется в продакшн — и начинает буксовать: он работает короткое время, после чего ему требуется человек, чтобы пополнить контекст и проверить результаты, а обещанная эффективность улетучивается из-за постоянного контроля. Агент выполнил работу — но наблюдать за ним пришлось вам. Именно поэтому так много пилотных проектов с агентами никогда не превращаются в полноценные производственные системы.
Презентация по другую сторону этого барьера — это то, во что хочет верить каждая команда: агент, выполняющий долгую задачу самостоятельно, если нужно — всю ночь, оставляя человеку задачу валидировать лишь последние 10%. Достижимость этого упирается в проблему, которую обсуждения оркестрации в основном обходят стороной. Когда ИИ-компания Chroma протестировала 18 ведущих моделей, каждая из них теряла точность по мере роста входных данных. Это свойство работы механизма внимания, а не изъян, который можно исправить более мощной моделью. Агент, которому по мере работы скармливают все больше информации о вашем бизнесе, не становится стабильнее. Он начинает сбоить еще сильнее.
Это тот уровень, который лежит под гонкой оркестраций. Маршрутизация, надежное выполнение и наблюдаемость изначально исходят из того, что каждый агент уже достаточно компетентен для координации. Более глубокий вопрос заключается в том, как долго агент может работать до того, как придется вмешаться человеку, а это сводится к тому, где знания вашей компании находятся по отношению к модели. Оба стандартных решения оставляют человека в контуре управления.
Почему обучение модели вашему бизнесу оставляет вас в рабочем контуре
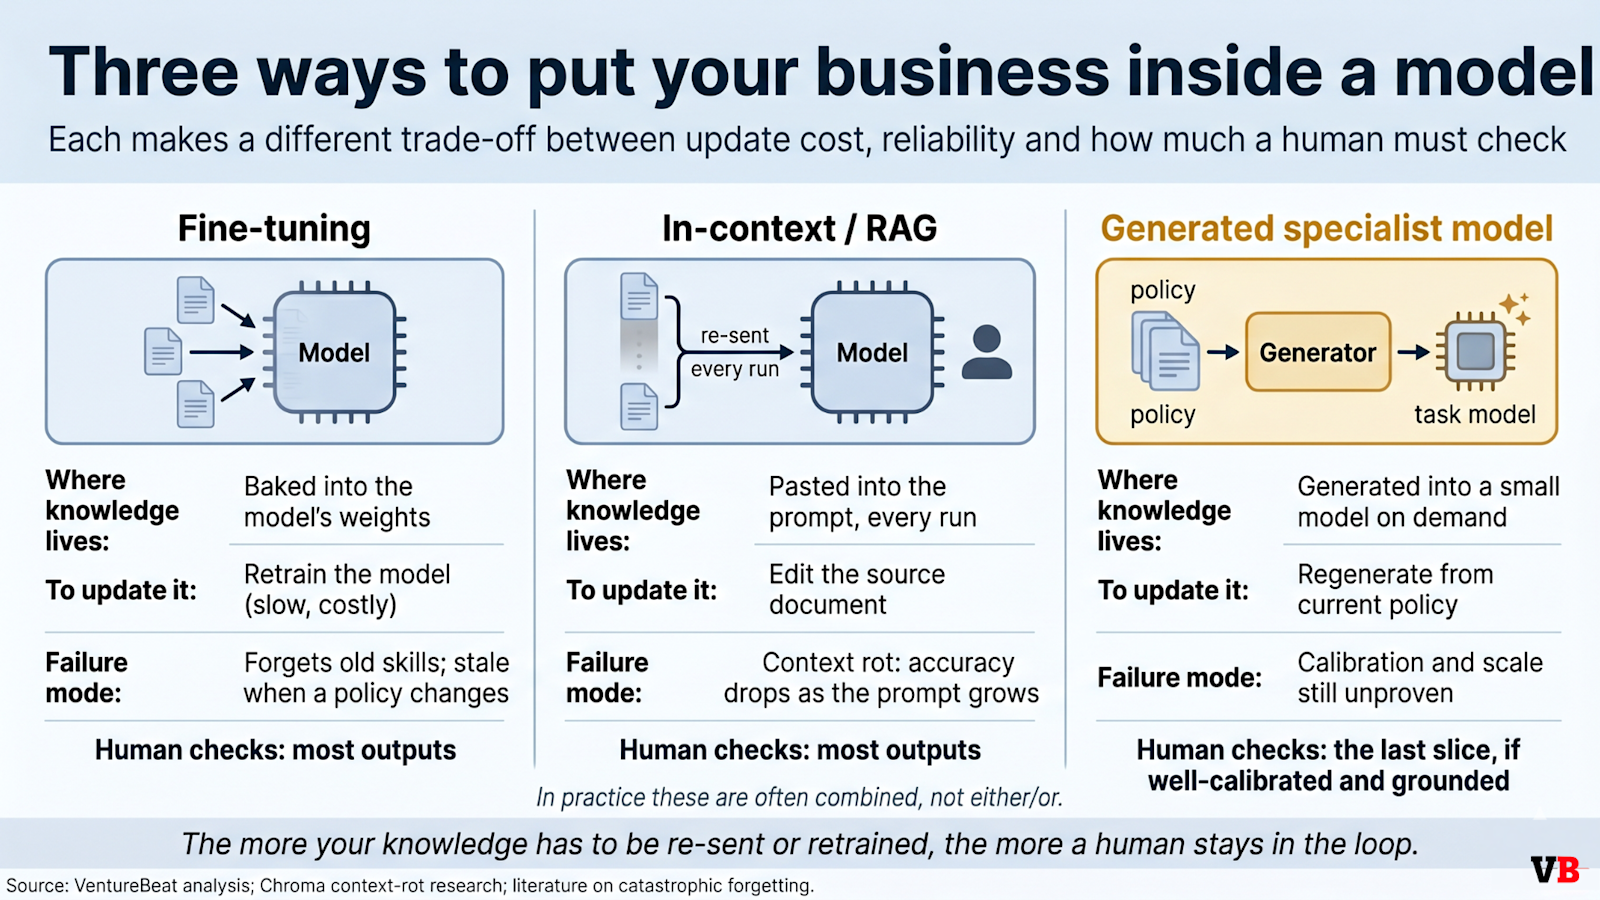
Передовые модели становятся все более функциональными, но разрыв не сокращается, потому что дело вовсе не в возможностях. Все дело в том, где располагаются ваши знания по отношению к модели, и у предприятий было два способа разместить их там.
Первый — дообучение (fine-tuning), которое зашивает знания непосредственно в веса модели. Оно по-прежнему подвержено катастрофическому забыванию — проблеме, выявленной еще в 1980-х годах и так и не решенной к 2026 году: обучение модели чему-то новому обычно приводит к стиранию того, что она уже знала. Команды обходят это, изолируя каждую задачу в ее собственной дообученной модели или адаптере, что порождает разросшееся хозяйство из множества моделей, что увеличивает затраты и накладные расходы на управление. К тому же дообученная модель — это лишь снимок состояния, устаревающий в день изменения какой-либо политики компании, после чего запускается дорогой и медленный цикл переобучения.
Второй подход — обучение в контексте (in-context learning), которое избавляет от необходимости переобучения путем помещения актуальных регламентов в промпт во время работы. Именно здесь дает о себе знать «гниение контекста» (context rot). Поиск (retrieval) сужает объем информации, попадающей в промпт, но ошибка поиска выглядит точно так же, как уверенный ответ, при этом и затраты, и задержка растут с каждым добавленным токеном.
Эти два сбоя похожи. При дообучении модель может с полной уверенностью руководствоваться регламентом прошлого квартала. При обучении в контексте она может с такой же уверенностью опираться на деталь, потерянную где-то в середине длинного промпта. В обоих случаях результат выглядит одинаково самоуверенно, поэтому невозможно определить, какие именно части неверны, не проверяя их все. Именно по этой причине человек никогда не может покинуть этот процесс. Некоторые команды часто используют оба метода одновременно: дообучают стабильные знания и подтягивают остальное через поиск. Это смягчает каждую из проблем, но не устраняет ни одну из них: для любого конкретного результата вы по-прежнему не можете быть уверены, что модель актуальна и работает с правильным контекстом, а значит, вам все равно приходится ее проверять.
Третий путь: генерация специализированной модели по запросу
Третий подход переходит из стадии исследований в разряд ранних продуктов. Вместо того чтобы переобучать одну модель или перегружать ее промпт, генератор создает небольшую, специализированную под конкретную задачу модель прямо во время инференса на основе ваших регламентов. Этот генератор представляет собой гиперсеть: сеть, чьим выходом являются веса другой сети.
Эту концепцию предложили в 2016 году; ее применение для создания специализированных языковых моделей из текста или документов — явление недавнее и активно развивающееся. Проект Sakana AI Text-to-LoRA, представленный на конференции ICML 2025, генерирует адаптер модели на основе описания на обычном языке за один проход, а система 2026 года под названием SHINE называет адаптацию с помощью гиперсетей многообещающим новым рубежом именно потому, что она позволяет обойти как затраты на переобучение при fine-tuning, так и ограничения контекста при промптинге.
Смысл генерации адаптеров вместо их обучения и хранения заключается в том, чтобы схлопнуть разросшуюся библиотеку LoRA-модулей для каждой отдельной задачи в единую сеть, способную создавать их по требованию, в том числе для задач, которые она еще не видела.
Самое изящное здесь то, как это замыкает круг описанной выше проблемы: адаптер для конкретной задачи, который команды вручную создают во избежание катастрофического забывания, — это тот же самый объект, который гиперсеть производит автоматически. Зоопарк моделей перестает быть головной болью для руководства и превращается в генерируемый результат.
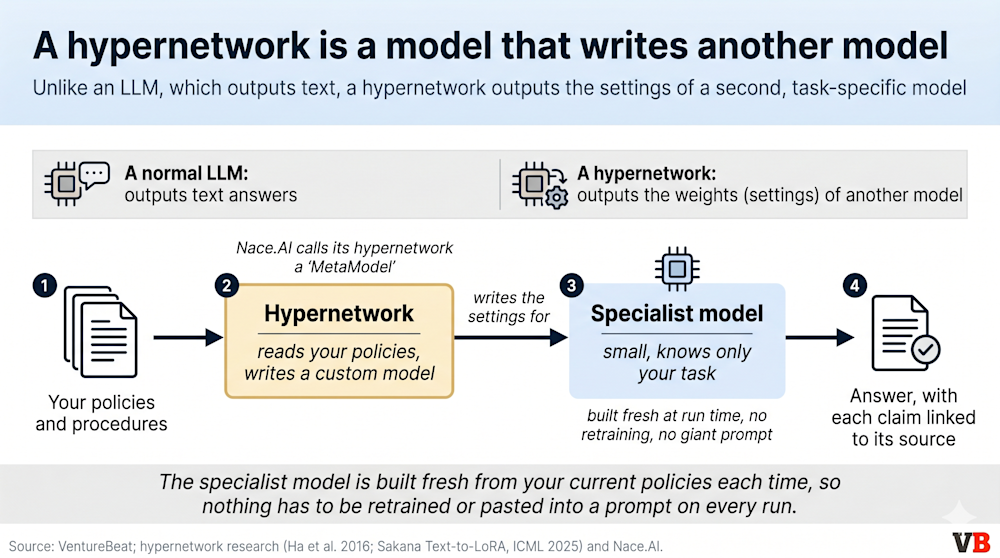
Аргументы в пользу перехода к компактным моделям наиболее прямолинейно были изложены в исследовании исследователей из Nvidia за 2025 год: для узких, рутинных задач, из которых состоят рабочие процессы агентов, небольшие модели обладают достаточными возможностями и стоят в 10–30 раз дешевле в исполнении, чем универсальные передовые модели. Ярчайшим коммерческим примером здесь выступает Nace.AI, компания из Пало-Альто, которая в мае привлекла посевное финансирование в размере 21,5 миллиона долларов. Ее ключевая технология — генератор под названием MetaModel — создает адаптации параметров для модели в момент инференса на основе регламентов компании, ориентируясь на регулируемые сферы: аудит, комплаенс, оценку рисков. Компания заявляет, что ее агенты справляются с основной частью рабочего процесса, в то время как эксперты-люди проверяют результат — такое разделение труда они позиционируют как соотношение 90/10.
Сравнение трех подходов
|
Дообучение (Fine-tuning) |
Контекстное обучение / RAG |
Модель, созданная гиперсетью |
|
|
Где хранятся бизнес-знания |
В весах модели |
В промпте, подгружаются при каждом запуске |
В генерируемых по запросу весах |
|
Стоимость обновления при изменении регламентов |
Высокая: требуется переобучение |
Низкая: правка исходных данных |
Низкая: перегенерация |
|
Устаревание данных |
Высокое: слепок на момент времени |
Низкое |
Низкое: генерируется из актуального регламента |
|
Стоимость и задержка на один вызов |
Низкие |
Высокие, растут вместе с контекстом |
Низкие во время работы |
|
Основной тип сбоев |
Забывание; разрастание зоопарка моделей |
Гниение контекста; скрытые промахи поиска |
Качество генератора; калибровка |
|
Кому принадлежит накапливаемый актив |
Тому, кто обучает модель |
Тому, у кого находится хранилище данных |
Зависит от того, где находятся генератор и обратная связь |
Почему модель, построенная гиперсетью, повышает планку автономности
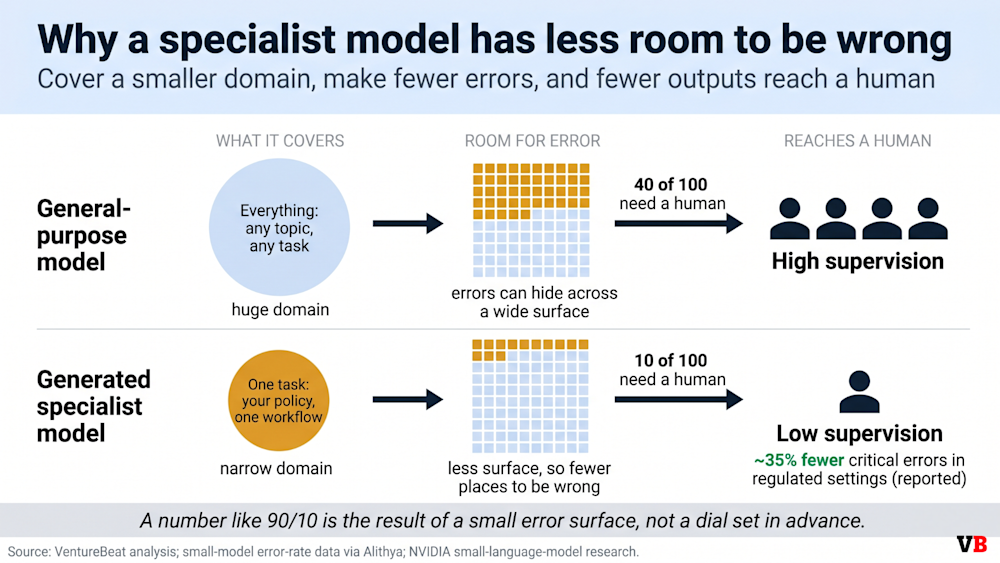
Узкоспециализированная, актуальная и компактная модель имеет гораздо меньшую площадь для совершения ошибок. Меньшее количество ошибок, ограниченных известной предметной областью, означает, что агенту реже приходится эскалировать задачу на человека — а это и есть реальная основа для любых заявлений о высокой автономности. Именно отсюда берется показатель вроде 90/10: это не тумблер, выставленный заранее, а следствие того, насколько мало система вынуждена возвращать на доработку. Заявляемую долю автономности лучше воспринимать как характеристику архитектуры, а не как настройку.
Два проектных решения определяют, является ли эта автономность надежной или просто быстрой. Первое — это привязка к источникам (grounding): привязка каждого результата к первоисточнику, чтобы проверяющий мог перепроверить данные, а не переделывать всё заново. Созданные специально для этого исследовательские модели, такие как HalluGuard, помечают каждое утверждение как подтвержденное или нет и цитируют фрагмент, на который они опирались. Nace поставляет своих агентов с моделями проверки источников и цепочками рассуждений ровно по той же причине. Проверка 10% работы имеет смысл только тогда, когда человек может подтвердить происхождение данных за считанные секунды.
Второе — цикл обратной связи, который заставляет задать вопрос, который должен задать каждый покупатель: когда ваши эксперты валидируют результат, чья модель при этом совершенствуется и где она находится? Это решает, кому принадлежит накапливаемый актив — поставщику или вам. Подходы различаются. Например, Nace использует внешнюю сеть сертифицированных экспертов для некоторых проектов, а для прямых внедрений на предприятиях — собственный персонал заказчика, причем результирующая модель хранится внутри облака самого клиента. Каждый такой выбор направляет обучение и права собственности в разные стороны.
Где третий путь дает сбой
Этот подход все еще находится на ранней стадии, и несколько вопросов определят, насколько далеко он продвинется. Калибровка — краеугольный камень: ценность зависит от того, насколько модель способна понимать, когда она не уверена в себе. И здесь пока нет полной определенности: недавние работы по созданию таких адаптеров показали, что они не улучшают калибровку автоматически по сравнению с обычным дообучением, а прирост достигается только при соблюдении специфических ограничений.
Качество сгенерированной модели также сильно зависит от данных регламентов, на основе которых она построена, что предъявляет высокие требования к кураторству данных. Масштабирование остается открытым фронтом для исследований: гиперсети, продемонстрированные в опубликованных на данный момент работах, были небольшими. Именно здесь собственная работа Nace становится интересной: в нашем интервью компания заявила, что масштабировала свой генератор далеко за пределы тех размеров, что фигурируют в публикациях, и вывела закон масштабирования роста производительности. Эти результаты компания начала публично освещать и сейчас отправляет на рецензирование. Если они подтвердятся, это поможет ответить на один из центральных открытых вопросов в этой области, и эту научную работу стоит взять на заметку.
Какой бы подход ни победил, работа все равно завершается участием человека, и эта точка передачи сама по себе представляет собой проблему проектирования. Когда Deloitte Australia подготовила правительственный отчет стоимостью около 440 000 австралийских долларов, в нем содержались вымышленные цитаты и придуманная цитата суда после прохождения старшей проверки — потому что рецензенты проверяли выводы, которые были здравыми, а не происхождение данных, которое таковым не являлось. Контролируемые исследования показывают, что эта закономерность носит общий характер: эксперты реже исправляли одинаковые ошибочные рекомендации, когда они были помечены как созданные искусственным интеллектом.
Статья 14 Закона ЕС об искусственном интеллекте (AI Act) теперь официально называет это предвзятостью к автоматизации (automation bias). Урок заключается вовсе не в каком-то конкретном вендоре: высокая доля автономности концентрирует внимание человека на узком, финальном срезе работы, поэтому ценность такой проверки целиком и полностью зависит от того, может ли человек быстро проверить происхождение данных, что снова возвращает нас к необходимости привязки к источникам.
Что создавать и о чем спрашивать перед покупкой
Честный вывод таков: то, что сдерживает ваших агентов — это обычно не оркестрация или размер модели, а то, насколько хорошо модель знает ваш бизнес, чтобы ее можно было оставить без присмотра, и правильное решение зависит от конкретной задачи. Чтобы автоматизировать длинный, рутинный и высокообъемный процесс от начала до конца, запустить большую часть внутреннего аудита ночью и дать собственным экспертам проверить лишь финальный срез — модель, созданная гиперсетью, является наиболее перспективным подходом, способным сделать это дешево и работать достаточно долго, чтобы это имело значение. Для короткой задачи, которая завершается за пару шагов и никогда не требовала автономного выполнения, разница между таким подходом и хорошо настроенной передовой моделью сокращается практически до нуля, и затраты на интеграцию себя не окупят.
Когда вендор рекламирует автономных или специализированных агентов, пробиться сквозь маркетинговую шелуху помогают четыре вопроса.
-
Где хранятся бизнес-знания: в весах, в промпте или генерируются по запросу?
-
Что прилагается к каждому результату, чтобы проверяющий мог его подтвердить, а не переделывать?
-
Что является решающим фактором для передачи задачи человеку?
-
И чья модель совершенствуется благодаря этой обратной связи и где она запускается?
Именно ответы на эти вопросы, а не рекламные соотношения, показывают, что именно вы покупаете.
Подход с использованием гиперсетей — это самая правдоподобная на сегодняшний день попытка заставить небольшую модель узнать конкретный бизнес, не забывая его и не пересказывая все заново при каждом запуске. Это также наименее проверенный метод, а самые важные его аспекты — калибровка и масштабирование — все еще проходят экспертную оценку. Для подходящей задачи запустите пилот прямо сейчас. Для неподходящей — затраты на интеграцию дадут вам лишь то, что и так может обеспечить хорошо промптированная передовая модель.




