Почему просто предоставить ИИ-агентам больше вычислительных ресурсов недостаточно — и что Meta предлагает взамен


ИИ-агентам часто трудно оценить собственный прогресс и решить, что делать дальше. Они могут тратить вычислительные ресурсы на неудачные подходы, упускать перспективные результаты или прекращать работу, не выполнив задачу. По мере того как агенты берутся за более длительные и сложные рабочие процессы, эти проблемы обходятся всё дороже.
Исследователи из Meta Superintelligence Labs разработали фреймворк под названием агентное метарассуждение, который решает эту проблему, позволяя агенту использовать отдельный поток рассуждений о том, что делать дальше. Фреймворк позволяет агентам оценивать прогресс, изучать альтернативные подходы и направлять ресурсы на наиболее перспективные следующие шаги.
На ProgramBench — бенчмарке для реконструкции программного обеспечения — фреймворк с GPT-5.5 показал среднюю долю прохождения скрытых тестов 71,5% против 58,0% у Codex в оценке исследователей.
В отличие от самосовершенствующихся оболочек, оптимизирующих программное обеспечение и конфигурации, на которых работают агенты, от запуска к запуску, метарассуждение улучшает то, как агенты направляют свою работу в ходе одного запуска. Это даёт корпоративным разработчикам ещё один способ повысить производительность агентов, не изменяя и не дообучая базовые модели.
Проблема управления работой агентов
Представим себе кодирующего агента, который разрабатывает программный компонент. Он написал основную функциональность, и несколько тестов прошли успешно, но некоторые граничные случаи всё ещё не обработаны. Стоит ли ему разобраться в причинах сбоев, переписать часть реализации, запустить дополнительные тесты, попробовать другой подход или остановиться? Каждый вариант расходует ресурсы, а неудачное решение может привести к тому, что оставшийся бюджет будет потрачен впустую, или повредить реализацию, которая в остальном работает.
Исследователи называют эту проблему метакогнитивным управлением и определяют его как «оценку собственного прогресса и использование этой оценки для решения, что делать дальше».
Для ИИ-агента метакогнитивное управление означает решение о том, каким промежуточным результатам доверять, на какие предыдущие наработки опираться и когда выделять дополнительные вычислительные ресурсы. Неверное решение может привести к дальнейшей трате вычислительных ресурсов на неудачный подход или заставить агента отказаться от уже найденного правильного решения.
В существующих агентах такие решения часто принимаются одновременно с выполнением задачи. Иными словами, агент выбирает следующее действие за один шаг, опираясь на накапливающуюся историю действий и взаимодействий со средой. По мере выполнения задачи важная информация может затеряться среди предыдущих попыток, результатов работы инструментов и ошибок.
У традиционных методов масштабирования на этапе инференса тоже есть ограничения. Такие подходы, как генерация нескольких вариантов, циклы критики и доработки, а также заранее заданные деревья поиска, обычно требуют заранее определить структуру вычислений. Число попыток, этапов проверки или циклов доработки задаётся до того, как станет понятно, какие вычисления будут наиболее полезны для решения задачи.
Исследователи Meta считают, что решения о том, что вычислять дальше, «заслуживают собственного агентного процесса рассуждения».
«У такого обдумывания есть собственная структура: оно обобщает установленные в ходе запуска факты, изучает возможные дальнейшие действия и оценивает ценность каждого варианта», — пишут они.
Как работает агентное метарассуждение
Предложенный исследователями Meta фреймворк агентного метарассуждения позволяет агенту рассуждать о собственном процессе инференса и влиять на него.
Фреймворк задаёт повторяющийся цикл: выполнить работу, оценить результаты, определить перспективные следующие шаги и выделить дополнительные вычислительные ресурсы. Предыдущие результаты остаются доступными на протяжении всего процесса, поэтому агент может опираться на прежние попытки, не обрабатывая каждый раз всю историю выполнения задачи.
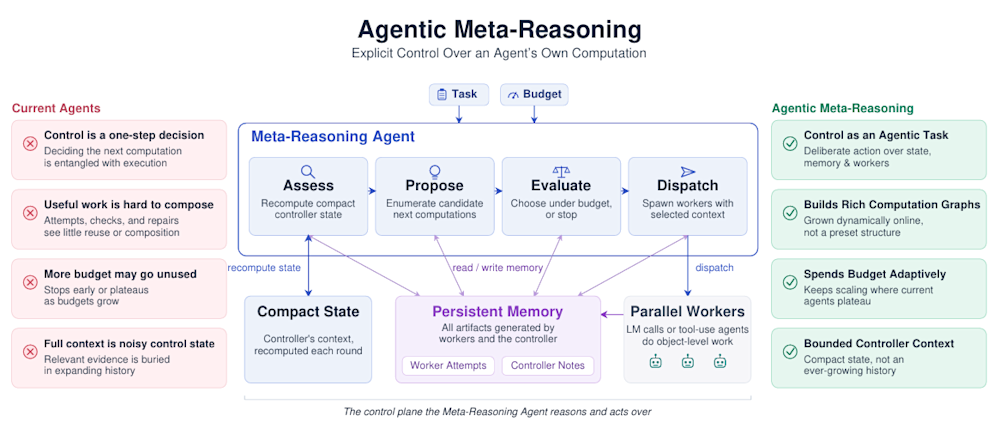
Агентное метарассуждение (источник: arXiv)
Исследователи реализовали этот подход в оболочке для инференса под названием Meta-Reasoning Agent. В ней разделены два компонента: «исполнители», выполняющие непосредственные задачи, и контроллер, который решает, какую работу нужно выполнить следующей.
Исполнителями могут быть отдельные запросы к большим языковым моделям (LLM) или кодирующие агенты, использующие инструменты для просмотра файлов, изменения кода и запуска тестов. Контроллер может изучать их результаты, фиксировать собственные выводы, запускать новых исполнителей с целевыми инструкциями и решать, когда остановиться.
Контроллер следует четырёхэтапному циклу рассуждений:
-
Оценка: контроллер изучает новые результаты работы исполнителей и обновляет своё понимание задачи. В случае с программированием он может зафиксировать, что основная функциональность работает, некоторые тесты не проходят, а обработка ошибок ещё не проверена.
-
Предложение: на основе этой оценки контроллер формирует возможные дальнейшие действия — например, разобраться с проваленными тестами, реализовать отсутствующую функциональность или независимо проверить существующий код. На этом этапе он рассматривает варианты, не ограничивая их оставшимся бюджетом.
-
Оценка вариантов: контроллер сопоставляет предложенные действия с доступным вычислительным бюджетом. Он может решить, что устранение известной ошибки принесёт больше пользы, чем переписывание работающего компонента.
-
Постановка задач: контроллер даёт инструкции исполнителям и предоставляет им контекст, опираясь на важные выводы из предыдущих попыток. В качестве альтернативы он может остановиться и отправить уже готовый результат.
Каждый этап может включать собственные обращения к модели и операции с памятью, позволяя контроллеру провести дополнительное исследование перед принятием решения.
Важная часть этой архитектуры — постоянная память артефактов. Результаты работы исполнителей и заметки контроллера сохраняются в виде артефактов с уникальными идентификаторами. Контроллер поддерживает краткую оценку состояния задачи и извлекает подробные артефакты только при необходимости.
Эти артефакты также образуют граф вычислений. Каждый раз, когда контроллер предоставляет прежний артефакт в качестве контекста для новой работы, система фиксирует связь между ними. Например, отчёт о тестировании может привести к целевому исправлению, которое затем проверит другой исполнитель.
Граф показывает, как агент изучает альтернативные подходы и опирается на предыдущие результаты. Он также позволяет анализировать, продуктивно ли агент использует вычислительные ресурсы, а не просто генерирует несвязанные между собой попытки.
Метарассуждение на практике
Исследователи оценили фреймворк на четырёх бенчмарках: IMO ProofBench-Advanced для математических доказательств, ARC-AGI-2 для абстрактного визуального рассуждения, LongCoT-mini для рассуждений на длинном горизонте в нескольких областях и ProgramBench для реконструкции программ по документации и исполняемым эталонным примерам.
Они протестировали три передовые модели: Gemini 3.1 Pro, GPT-5.5 и Opus 4.8. Основным базовым вариантом стал Direct Control Agent — разновидность Meta-Reasoning Agent, которая принимает управляющие решения за один шаг на основе накопленной истории, а не использует отдельный контроллер. Исследователи также сравнили фреймворк с существующими исследовательскими оболочками и агентами для программирования, включая Codex, Claude Code и рекурсивные языковые модели (RLM).
При самых больших проверенных бюджетах метарассуждение показало более высокие результаты во всех 12 сопоставлениях.
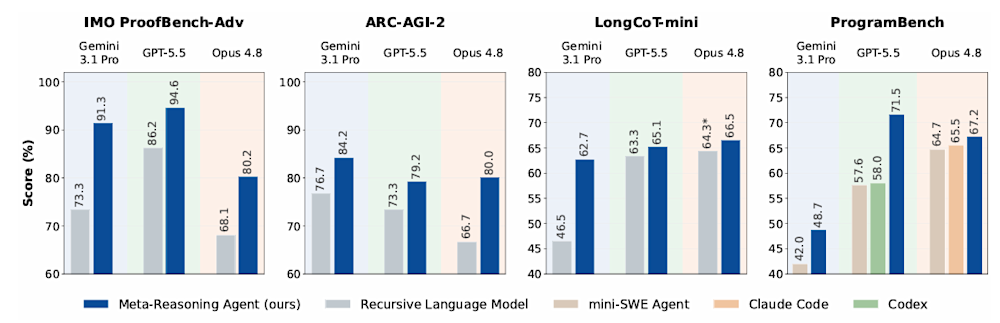
Результаты агентного метарассуждения (источник: arXiv)
Одним из наиболее интересных выводов стало то, как агенты реагировали на увеличение вычислительного бюджета.
Когда лимит на ProgramBench увеличили с 400 до 1 200 обращений к модели, результат метарассуждения с GPT-5.5 вырос с 64,1% до 71,5%. В то же время результат прямого управления оставался около 64%, а при максимальном лимите агент использовал лишь примерно 18% доступных обращений.
Важную роль в обеспечении такого поведения играет компонент с графами артефактов. Метарассуждение генерировало больше промежуточных результатов и больше связей между ними. В одном из примеров ARC-AGI-2 прямое управление породило шесть независимых попыток и четыре неглубоких продолжения, тогда как метарассуждение изучило больше вариантов и связало последующую работу с предыдущими результатами.
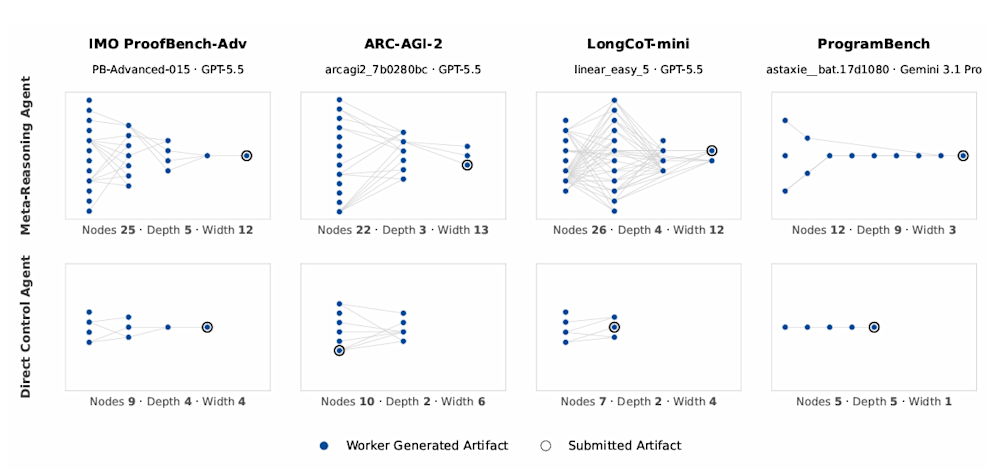
Метарассуждение использует продвинутые методы построения графов (источник: arXiv)
Внедрение агентного метарассуждения
В материалах к исследованию исследователи не предоставили официальную готовую к запуску реализацию, однако в статье подробно описаны запросы к контроллеру, инструкции для исполнителей, интерфейсы памяти и инструменты.
Разработчики могут использовать эти спецификации для экспериментов: добавить отдельный контур управления к существующим системам агентов, вести постоянные записи о промежуточной работе и явно оценивать затраты и выгоду предлагаемых действий.
Реализация для ProgramBench содержит практические выводы для кодирующих агентов. Исполнители фиксируют свои изменения в Git, а контроллер может просматривать репозиторий через интерфейс только для чтения, чтобы проверить их утверждения. В текущей оценке состояния он отдельно учитывает реализованную, неработающую, непроверенную и ещё не изученную функциональность. Фреймворк также ограничивает параллельное изменение кода в общем рабочем пространстве, чтобы исполнители не перезаписывали изменения друг друга.
Однако метарассуждение вносит дополнительные накладные расходы и требует дополнительных обращений к LLM в ходе цикла управления. При небольших бюджетах фреймворк иногда показывал результаты хуже прямого управления, но затем опережал его при увеличении доступных вычислительных ресурсов.
Для корпоративных команд, работающих с ИИ, эти выводы означают, что способность управлять вычислениями следует явно учитывать при оценке и оптимизации агентов. По мере того как агенты берутся за более длительные рабочие процессы, они должны уметь приостанавливать работу и определять, как наилучшим образом распределить ресурсы.