H-JEPA обучает модели мира планировать на нескольких уровнях абстракции


Исследователи из лаборатории Advanced Machine Intelligence (AMI Labs) Яна ЛеКуна и академических учреждений разработали H-JEPA — архитектуру модели мира, которая учится планировать на разных временных горизонтах, используя отдельные представления окружающей среды.
По сравнению с плоскими моделями мира JEPA, H-JEPA повышает точность выполнения навигационных задач и при этом требует меньше вычислительных ресурсов для планирования.
Эта работа посвящена одной из проблем разработки систем искусственного интеллекта, способных понимать физический мир и действовать в нём. Например, роботу, который перемещается по зданию, нужно решить, куда направиться, и одновременно каждое мгновение управлять своими движениями. H-JEPA решает эту задачу, планируя на разных уровнях абстракции: система может рассуждать о пункте назначения на высоком уровне, а затем постепенно преобразовывать планы в точные физические действия.
Зачем моделям мира JEPA нужна иерархия
Архитектуры предиктивного совместного встраивания (JEPA) учатся моделировать мир, не предсказывая каждую деталь на низком уровне. В отличие от генеративных моделей, которые пытаются предсказывать мельчайшие детали, например пиксели, модели JEPA кодируют наблюдения — например, изображения или видео — в латентные представления, то есть компактные наборы признаков, содержащих информацию о сцене. Благодаря этому они гораздо эффективнее генеративных моделей и хорошо справляются с такими задачами, как навигация в физической среде или манипулирование объектами, для которых не требуется генерировать пиксели.
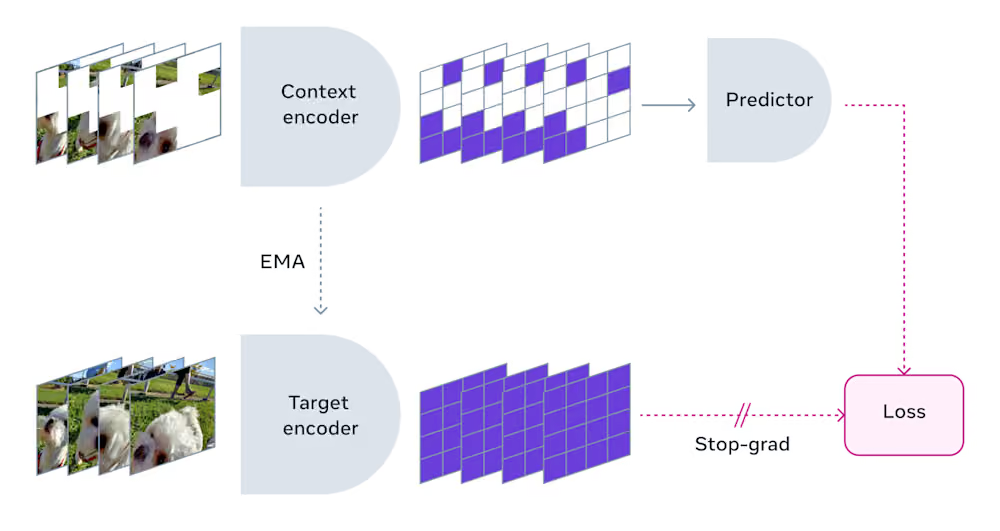
Архитектура V-JEPA (источник: Meta)
В JEPA с учётом действий модель получает не только визуальные данные, но и действия. Она может моделировать последствия различных последовательностей действий и сравнивать предсказанный результат с целью.
Существующие подходы сталкиваются с двумя связанными проблемами. Чтобы предсказать отдалённый результат, может потребоваться смоделировать множество небольших шагов, что увеличивает вычислительные затраты и может приводить к накоплению мелких ошибок. В то же время модель должна в одном и том же представлении отслеживать тонкие физические процессы и оценивать прогресс на пути к долгосрочной цели.
Представим четвероногого робота, который проходит лабиринт. Положение его конечностей важно для управления движениями. Но планировщику, выбирающему маршрут, в первую очередь нужно знать местоположение робота. Если кодировать и местоположение робота, и детальную информацию о его движениях в одном латентном представлении, задачи становятся сложными и плохо поддаются обучению.
H-JEPA решает эту проблему, обучаясь формировать представления на разных уровнях. Для долгосрочного планирования можно использовать информацию, отличную от той, на основе которой модель управляет непосредственными действиями.
Как H-JEPA обучается и планирует
H-JEPA обучается на последовательностях наблюдений и связывающих их действиях. Самый низкий уровень кодирует визуальные наблюдения и предсказывает следующее латентное состояние на основе предыдущих состояний и действий. Уровни выше используют представления нижележащего уровня и предсказывают переходы за более длительные интервалы времени.
У каждого уровня есть собственный кодировщик состояний, кодировщик действий и предиктор. Кодировщик состояний формирует представление среды в масштабе времени, соответствующем этому уровню. Кодировщик действий обобщает действия за соответствующий интервал. Предиктор учится моделировать изменения представленного состояния.
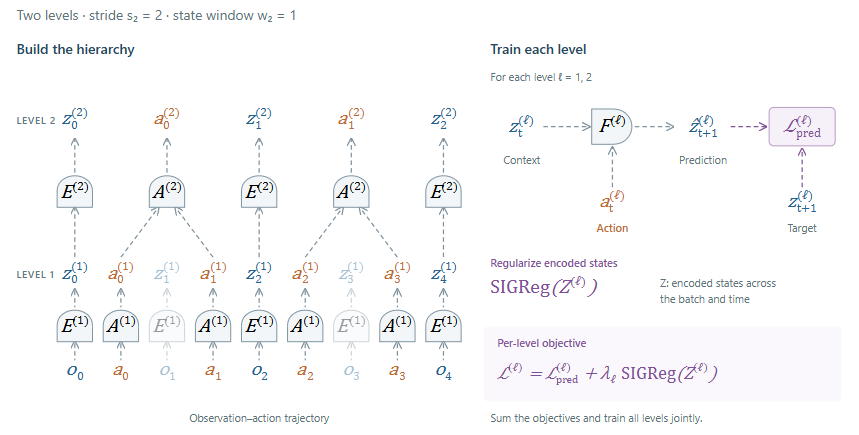
Архитектура H-JEPA (источник: страница проекта H-JEPA)
Исследователи обучали иерархию целиком. На каждом уровне предсказанное представление сравнивается с наблюдаемым представлением будущего состояния. Механизм регуляризации не позволяет модели выдавать одно и то же представление для всех наблюдений. Сигналы обучения с верхних уровней также передаются через кодировщики нижних уровней.
Интервалы между уровнями задаются заранее, но информация, сохраняемая в их представлениях, определяется в процессе обучения. Если части среды меняются с разной скоростью, верхние уровни могут сохранять более медленно меняющиеся признаки, которые остаются предсказуемыми в течение длительного времени, и отбрасывать быстро меняющиеся детали.
В примере с лабиринтом нижнему уровню нужны сведения о конфигурации суставов робота, чтобы предсказывать его непосредственные движения. Верхний уровень может сохранять информацию о местоположении робота, не удерживая все эти детали.
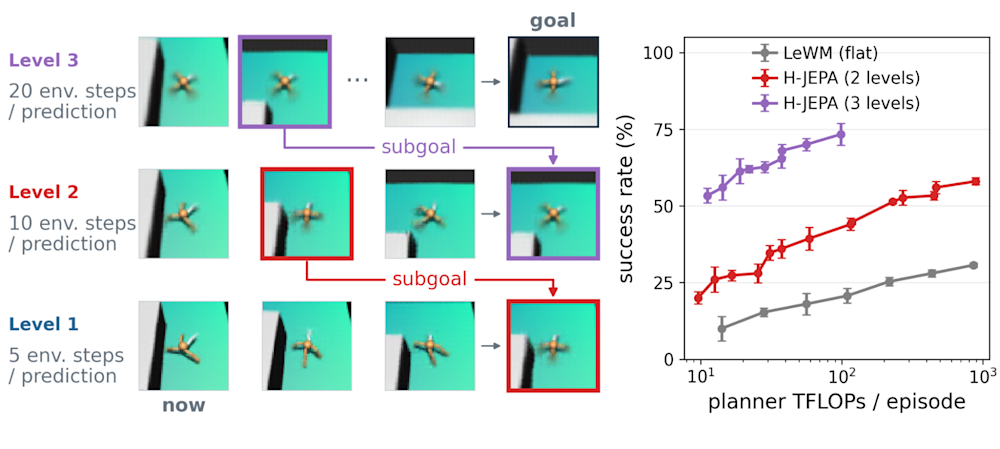
При планировании H-JEPA кодирует текущее наблюдение и целевое наблюдение на каждом уровне. Планировщик верхнего уровня ищет действия, предсказанные результаты которых в латентном пространстве ближе к цели.
Предсказанные им состояния становятся подцелями для следующего уровня, который ищет действия для их достижения. Каждый уровень уточняет план, пока нижний уровень не сформирует элементарные действия для выполнения.
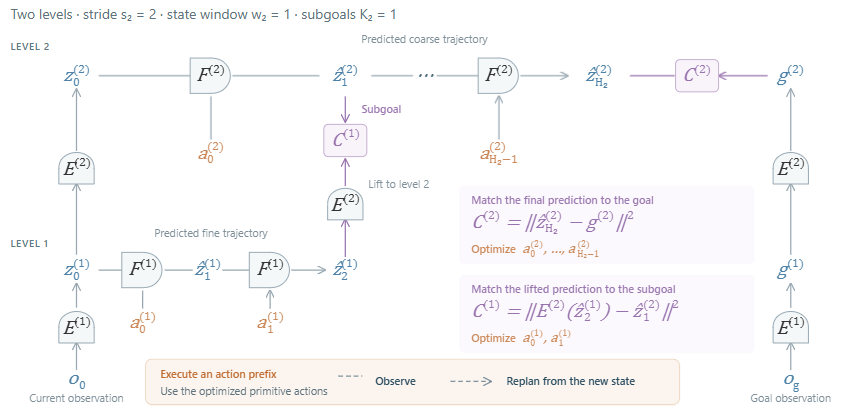
Процесс планирования H-JEPA (источник: страница проекта H-JEPA)
В лабиринте верхний уровень может сосредоточиться на продвижении к пункту назначения, а нижние уровни — отвечать за короткие переходы и физические движения.
Выполнив короткую последовательность действий, система обновляет план с учётом новых наблюдений и обнаруженных отклонений от предсказанной траектории.
H-JEPA в действии
Исследователи оценили H-JEPA в четырёх симулируемых средах для навигации и манипулирования объектами: FourRoom Distractors, Visual AntMaze, Push-T и OGBench Cube. Они сравнили её с LeWM — одноуровневой JEPA — и HWM, другой моделью мира, которая выполняет иерархическое планирование в общем латентном пространстве.
В FourRoom, AntMaze и Cube добавление уровней — вплоть до трёхуровневой иерархии — в целом повышало успешность и сокращало вычислительные затраты на планирование. Преимущество обучения отдельных представлений было наиболее заметным в AntMaze, где трёхуровневая H-JEPA достигла почти вдвое более высокого показателя успешности, чем HWM.
Результаты H-JEPA на отраслевых тестах (источник: страница проекта H-JEPA)
В AntMaze положение робота можно восстановить по представлениям верхних уровней, тогда как информация о конфигурации его конечностей постепенно утрачивается. Верхние уровни также позволяют точнее оценивать расстояние до цели вдоль коридоров лабиринта, давая планировщику более чёткий сигнал для обхода стен.
Затем команда проверила H-JEPA на DROID — наборе данных с видео манипуляций реальных роботов, снятых с разными объектами, при разном освещении и на различном фоне. При обучении только на предсказаниях модель, как правило, сохраняла статичные детали сцены и теряла информацию о движущемся роботе. Тогда исследователи добавили целевую функцию «обратной динамики», предсказывающую действие, которое связывает два наблюдаемых состояния; это помогло сохранить информацию, важную для действий. H-JEPA точнее базовых моделей планировала по имеющимся данным и требовала от планировщика меньше вычислений.
H-JEPA может оказаться полезной для навигации роботов, автоматизации складов и систем манипулирования объектами, которым необходимо согласовывать долгосрочные цели с точными физическими движениями. Однако у модели есть и ограничения. Эксперименты показывают, что более глубокая иерархия не всегда лучше, а её преимущества зависят от охвата обучающих данных.
Исследователи предлагают связать представления верхних уровней с языком. В перспективе это может позволить агентам получать цели в виде инструкций, а не целевых изображений. Пока же H-JEPA демонстрирует потенциал обучения разным представлениям для непосредственных движений и отдалённых целей.