По данным VB Intelligence, доля предприятий, доверяющих ИИ-агентам самостоятельно вносить изменения в производство, снизилась с 75% до 56%


Компании всё неохотнее предоставляют ИИ-агентам полную свободу развёртывать код или вносить изменения в системы в производственной среде без одобрения человека, хотя продолжают инвестировать в инструменты для оценки надёжности агентов.
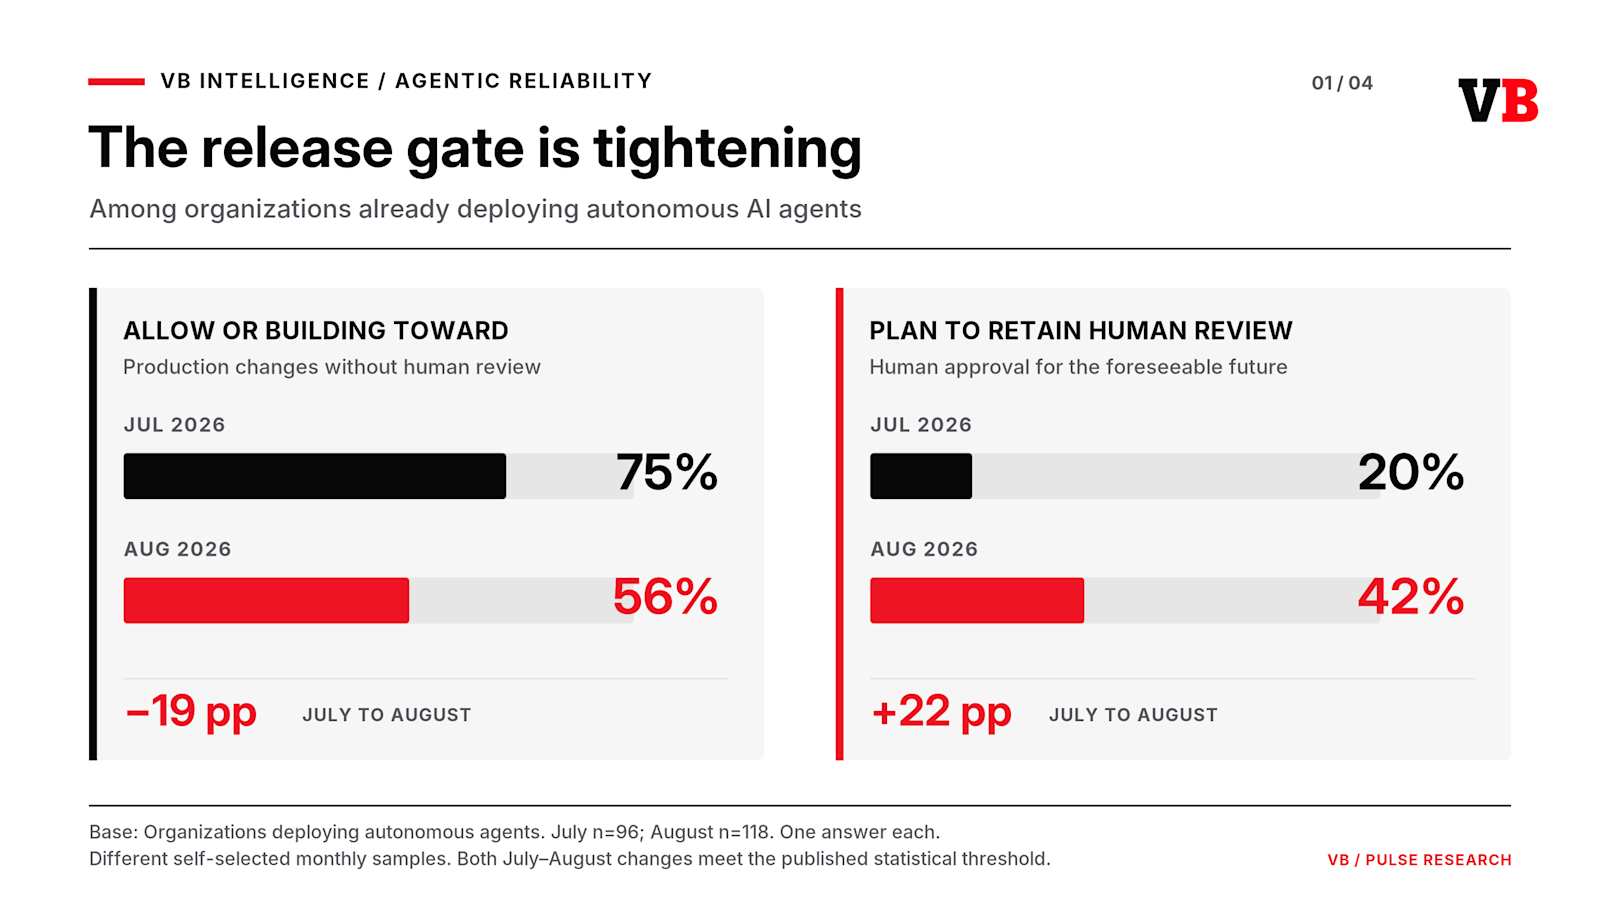
В августовской волне исследования VentureBeat «Надёжность и оценка автономных ИИ-агентов» 56% респондентов, в чьих организациях используются автономные ИИ-агенты, заявили, что уже разрешают вносить некоторые изменения в производственной среде исключительно на основании результатов автоматизированной оценки, без проверки человеком, либо разрабатывают системы, которые позволят делать это в течение следующего года. Это заметно меньше, чем 75% в июльском опросе VentureBeat.
Источник: VentureBeat Intelligence
Одно из возможных объяснений — состав респондентов: более половины (53%) из 140 участников августовского опроса принимали окончательные решения о закупках ИИ, тогда как в июле таких было 44%.
Однако снижение наблюдалось и внутри этой группы. Среди лиц, принимавших окончательные решения о закупках в организациях с автономными агентами, доля тех, кто разрешает вносить изменения в производственной среде без проверки или движется к этому, упала с 88% в июле до 61% в августе.
Таким образом, результаты указывают на существенный сдвиг среди опрошенных организаций, который нельзя объяснить лишь различиями в составе участников. Тем не менее в обоих опросах участвовали разные группы читателей и членов панели VentureBeat, самостоятельно решивших принять участие, поэтому результаты не обязательно отражают аналогичные изменения на всём корпоративном рынке.
Примечательно, что этот сдвиг произошёл до того, как генеральный директор Anthropic Дарио Амодей опубликовал своё резонансное эссе «Мы должны сдерживать темпы развития передовых ИИ-систем» (12 сентября), в котором призвал замедлить развитие передовых ИИ-систем и усилить надзор за безопасностью. Позднее другие лидеры отрасли, в том числе генеральный директор OpenAI Сэм Альтман и Демис Хассабис из Google DeepMind, выразили поддержку более осторожному подходу.
Поскольку опрос проводился в августе, сдвиг не мог быть прямой реакцией на эссе Амодея. Однако данные не позволяют установить, что именно заставило компании осторожнее относиться к автономному развёртыванию.
Наиболее показательно расхождение между готовностью компаний доверять автоматизированной оценке решения о развёртывании в производственной среде и продолжающимся внедрением самих инструментов оценки. Хотя поддержка отказа от одобрения человеком снизилась, использование встроенных инструментов оценки OpenAI существенно выросло — с 31% в июле до 59% в августе.
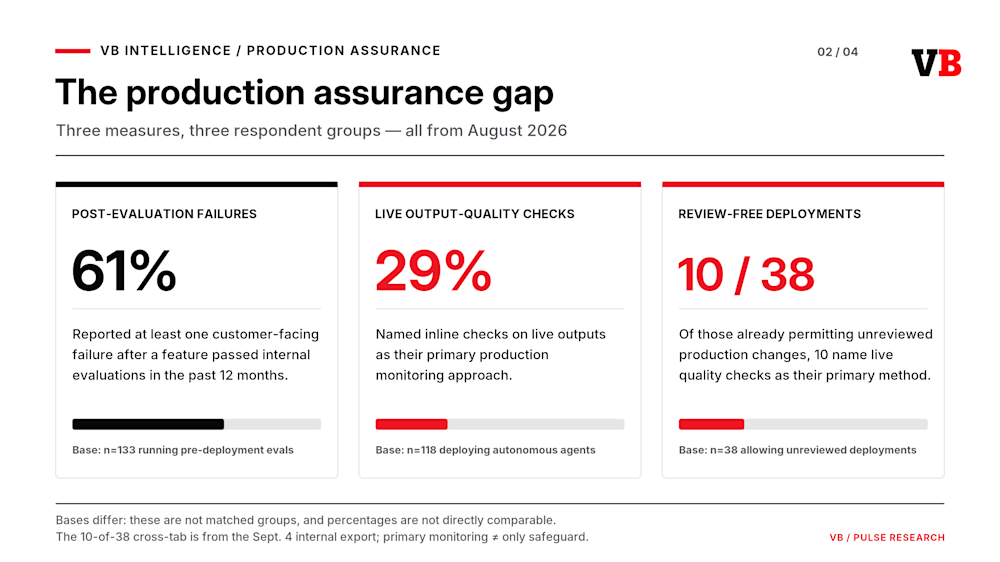
Тем временем 61% респондентов, в чьих организациях проводят оценку до развёртывания, сообщили как минимум об одном случае за последние 12 месяцев, когда ИИ-агент или функция на базе большой языковой модели (LLM) прошли внутреннее тестирование, но впоследствии привели к сбою, затронувшему клиентов .
Источник: VentureBeat Intelligence
В совокупности результаты говорят о том, что компании проводят различие между использованием автоматизированных оценок для проверки ИИ-систем и опорой на такие оценки как на единственное основание для допуска изменений в производственную среду.
Разрыв в доверии сохраняет центральную роль человеческого надзора в корпоративном ИИ
По результатам августовского опроса компании разделились на несколько групп. Более четверти (27%) уже разрешают некоторым агентам с низким уровнем риска вносить изменения без проверки человеком, тогда как 35% не планируют этого в обозримом будущем, а 20% разрабатывают системы, которые позволят это делать в течение 12 месяцев. Ещё 16% вообще не используют автономных агентов. Оставшиеся 2% затруднились с ответом. Эти данные охватывают всех 140 участников августовского опроса, в том числе организации, не использующие автономных агентов.
Если исключить респондентов, чьи организации не используют автономных агентов, 32% уже разрешают вносить в производственной среде изменения без проверки — для отдельных агентов или изменений с низким уровнем риска, а ещё 24% работают над внедрением такой возможности. Ещё 42% рассчитывают сохранять проверку человеком в обозримом будущем.
Последняя цифра отражает одно из наиболее явных изменений по сравнению с предыдущим опросом: доля респондентов из организаций, использующих агентов, которые рассчитывают сохранить одобрение человеком, выросла с 20% в июле до 42% в августе. Это статистически значимый рост.
Однако переход к сохранению одобрения человеком, по-видимому, не сопровождается сопоставимым изменением приоритетов в расходах на надёжность.
Источник: VentureBeat Intelligence
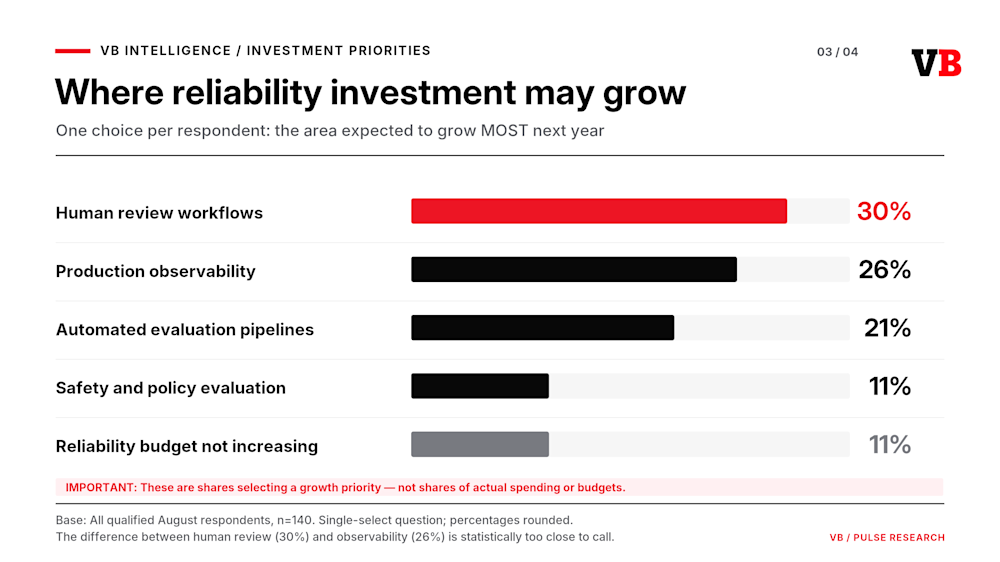
Отвечая на вопрос, в какую единственную область, связанную с надёжностью или оценкой, в следующем году будут больше всего инвестировать, участники августовского опроса выбрали:
-
Процессы проверки человеком: 30%
-
Инструменты наблюдения за работой в производственной среде: 26%
-
Автоматизированные конвейеры оценки: 21%
-
Оценка безопасности и соблюдения политик: 11%
-
Бюджет на надёжность не увеличится: 11%
Эти цифры показывают, в какой области респонденты ожидают наибольшего роста инвестиций, а не то, как организации распределяют фактические расходы.
Июльские результаты были в целом схожими: 31% выбрали процессы проверки человеком, 30% — наблюдение за работой в производственной среде, 19% — автоматизированные конвейеры оценки и 16% — оценку безопасности и соблюдения политик.
Таким образом, в августе процессы проверки человеком по-прежнему чаще всего выбирали как область роста инвестиций, хотя их преимущество перед наблюдением за работой в производственной среде было слишком небольшим, чтобы считать различие статистически значимым. Результаты также не доказывают, что компании сокращают расходы на оценку или перераспределяют средства, отказавшись от автоматизации.
Оценка безопасности и соблюдения политик выходит за рамки проверки точности модели: она включает анализ того, откажется ли агент от выполнения запроса в необходимых случаях, будет ли следовать политикам и не станет ли выдавать вредоносные результаты.
Хотя доля тех, кто назвал оценку безопасности и соблюдения политик областью с наиболее быстрым ростом инвестиций, снизилась с 16% до 11%, это не означает, что фактические расходы на такую деятельность сократились. Это лишь говорит о том, что в августе меньше респондентов выбрали эту категорию как единственную область, в которой их организация ожидает наибольшего роста инвестиций в надёжность.
Опрос показывает, что компании продолжают развивать как человеческий, так и автоматизированный надзор, одновременно пересматривая, какие решения можно доверить только машинам.
Внутренние оценки по-прежнему не предотвращают инциденты, затрагивающие клиентов
Одна из причин, по которой компании могут не спешить отказываться от проверки человеком, — сохраняющийся разрыв между результатами внутренних оценок и работой в реальных условиях. Однако опрос не доказывает напрямую, что сбои оценки стали причиной изменения отношения к развёртыванию.
VB спросила участников, случалось ли, что функция на базе ИИ или LLM, прошедшая внутреннюю оценку, впоследствии приводила к сбою, затронувшему клиентов.
Если исключить 5% респондентов, в чьих организациях оценку перед развёртыванием не проводят, 61% сообщили как минимум об одном сбое за последние 12 месяцев. Поразительно, но 22% сообщили более чем об одном таком сбое.
Для корректного сравнения в июле этот показатель составил 53% среди 101 респондента, а не ранее опубликованные 49% среди всех 108 участников июльского опроса.
Августовский показатель был численно выше, однако разница не достигла статистической значимости. Это значит, что опрос не подтверждает фактический рост доли организаций, столкнувшихся со сбоями после успешного прохождения оценки.
Одно более узкое наблюдение всё же выявило статистически значимое изменение: доля респондентов, сообщивших ровно об одном таком сбое, выросла с 27% в июле до 39% в августе.
Это различие важно, поскольку результаты показывают, сколько опрошенных организаций столкнулись как минимум с одним сбоем, а не то, как часто сбоит отдельный агент или развёртывание. У организации, внедрившей сотни функций на базе ИИ, больше возможностей столкнуться с инцидентом, затрагивающим клиентов, чем у той, которая использует лишь несколько таких функций.
Доверие к системам, предназначенным для выявления подобных проблем, соответственно, невелико: лишь 9% участников августовского опроса выбрали ответ «сегодня мы доверяем автоматизированной оценке», когда их спросили, какое ограничение сильнее всего снижает их доверие к автоматизированной оценке агентов. В июле так ответили 13%, а в июне — 5%.
Снижение с июля по август не было статистически значимым. Кроме того, поскольку респондентов просили выбрать лишь одну главную проблему, эти данные нельзя трактовать как свидетельство того, что 91% вовсе не доверяют автоматизированной оценке.
Главное возражение состоит в том, что системы оценки не согласуются с результатами работы в реальных условиях (так считают 27% респондентов). Среди других опасений — недостаточная объяснимость (24%), предвзятость или непоследовательность оценок (16%), утечки данных или проблемы с конфиденциальностью (13%) и незрелость инструментов (12%).
Примечательно, что респонденты, столкнувшиеся со сбоями после успешного прохождения оценки, не проявляли заметно меньшей склонности к автономному развёртыванию, чем те, у кого такого опыта не было.
Среди участников августовского опроса из организаций, использующих автономных агентов, 59% тех, кто сообщил о сбое после успешного прохождения оценки, уже разрешают вносить изменения в производственной среде без проверки или работают над внедрением такой возможности. Среди респондентов, не сообщавших о подобных сбоях, этот показатель составил 55% — разница слишком мала, чтобы говорить о значимой взаимосвязи.
Это заметно отличается от результатов июльского опроса, согласно которым организации, столкнувшиеся со сбоями после успешного прохождения оценки, казались более склонными стремиться к развёртыванию без участия человека. В августе эта связь не подтвердилась.
В конечном счёте результаты августовского опроса позволяют сделать более тонкий вывод, чем простое утверждение, будто компании отказываются от автоматизации, поскольку автоматизированная оценка не работает. Организации всё менее охотно отказываются от одобрения человеком при развёртывании в производственной среде, продолжая при этом инвестировать в инфраструктуру оценки и внедрять её.
Теперь вопрос не в том, будут ли компании автоматизировать оценку агентов, а в том, какой объём полномочий они предоставят результатам такой оценки без вмешательства человека.
Как компании тестируют агентов после развёртывания
Но тестирование перед развёртыванием — лишь один из уровней контроля. Не менее важно, чтобы компании понимали, что делает агент после запуска.
Среди 118 участников августовского опроса, в чьих организациях используются автономные агенты, лишь 29% заявили, что их основной подход к мониторингу в производственной среде включает автоматизированную проверку качества результатов работы агента в реальном времени.
Для сравнения, 36% в первую очередь полагаются на журналирование трасс транзакций, фиксирующее активность инфраструктуры, количество токенов, входные и выходные данные для последующей отладки, но не обязательно оценивающее правильность ответа агента.
Это вызывает беспокойство, поскольку быстрый и уверенно сформулированный неверный ответ может оставить безупречную трассу и код состояния 200, то есть запрос HTTP был успешно обработан.
Полное распределение основных подходов к мониторингу в производственной среде среди организаций, использующих автономных агентов, выглядело так:
-
Журналирование трасс транзакций: 36%
-
Проверка качества запросов в реальном трафике: 29%
-
Отслеживание инфраструктуры через шлюз API: 16%
-
Не знаю или это не моя сфера ответственности: 11%
-
Неформальная проверка: 8%
В совокупности 53% назвали основным подходом трассировку транзакций или мониторинг шлюза. И то и другое помогает выявлять проблемы инфраструктуры, но в анкете не было сказано, что эти методы напрямую проверяют правильность результатов, сгенерированных агентами.
Особенно заметен пробел в мониторинге среди организаций, уже разрешающих автономное развёртывание в производственной среде. Согласно анализу исходных данных августовского опроса VentureBeat Intelligence, лишь 10 из 38 респондентов, чьи организации уже разрешают вносить некоторые изменения в производственной среде без одобрения человека, назвали автоматизированную проверку качества результатов в реальном времени основным подходом к мониторингу.
Это составляет примерно 26% — близко к 28%, зафиксированным среди 40 сопоставимых респондентов в июле. Результаты говорят о том, что отказ от одобрения человеком при развёртывании не обязательно означает, что компании считают автоматизированный мониторинг качества результатов своей главной мерой защиты в производственной среде.
Однако результаты не доказывают, что в остальных организациях отсутствуют другие механизмы контроля качества. Возможно, некоторые из них проводят дополнительные автоматизированные проверки или используют другие формы контроля, которые не учитывались в вопросе с одним вариантом ответа.
Тем не менее результаты показывают, что во многих компаниях мониторинг в производственной среде по-прежнему в большей степени нацелен на то, чтобы выяснить, работает ли ИИ-система, а не на то, выдаёт ли она правильные ответы.
Это особенно важно, когда организации позволяют ИИ-агентам вносить изменения без этапа одобрения человеком.
Отказ от проверки человеком при развёртывании не обязательно означает отказ от автоматизированных механизмов, позволяющих обнаруживать проблемы после запуска. Но если организация в основном полагается на мониторинг инфраструктуры, внешне правдоподобный, но неверный результат работы агента может не вызвать ошибки или оповещения.
Августовский опрос не позволяет определить, сколько компаний, допускающих развёртывание без проверки, вовсе не отслеживают качество результатов в реальном времени и выявляют ли они проблемы обычно с помощью автоматических оповещений, сотрудников или жалоб клиентов.
Однако он выявляет практическую проблему, с которой сталкиваются компании, стремящиеся расширить автономность агентов: автоматизированная оценка должна выявлять не только сбои инфраструктуры. Она должна также обнаруживать результаты, которые синтаксически корректны, успешно доставлены, но при этом неверны.
Для организаций, расширяющих использование агентов, ключевой вопрос — как наладить эффективный контроль качества после развёртывания, не полагаясь исключительно на клиентов или сотрудников, которые могут заметить проблему.
Рынок поставщиков
Картина на рынке инструментов для оценки и наблюдения за работой ИИ также неоднозначна.
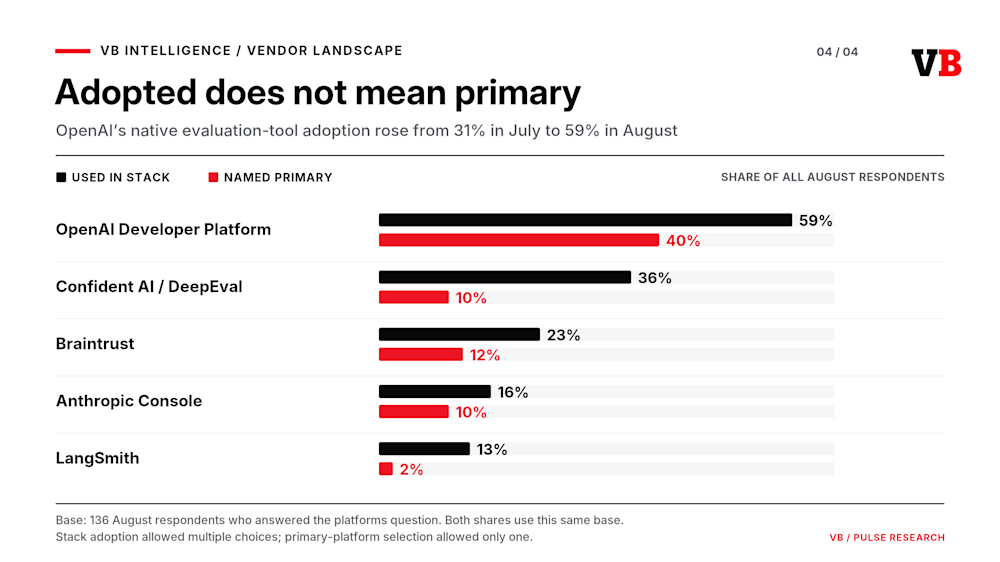
Платформа разработчика OpenAI используется в 59% технологических стеков (по сравнению с 31% в июле) — это статистически значимый рост. Её также назвали основной платформой для оценки 40% участников августовского опроса, ответивших на вопрос о платформе.
Источник: VentureBeat Intelligence
Среди организаций, использующих встроенные инструменты оценки OpenAI, примерно 69% назвали их своей основной платформой. Это два разных показателя: первый отражает долю OpenAI среди основных платформ у всех респондентов, а второй — как часто организации, уже использующие OpenAI, выбирают её в качестве основной платформы.
Confident AI используется в 36% технологических стеков; 10% всех респондентов назвали её основной платформой. Среди организаций, использующих Confident AI, 29% назвали её своей основной платформой.
Между тем Braintrust входит в 23% стеков и является основной платформой для 12% всех респондентов; Anthropic присутствует в 16% стеков и выступает основной платформой для 10% всех респондентов; LangSmith входит в 13% стеков и является основной платформой для 2% всех респондентов.
Для сопоставимости в приведённом ниже сравнении используется одна и та же выборка из 136 участников августовского опроса — как для оценки внедрения платформ, так и для определения основной платформы.
|
Платформа |
Используется в стеке |
Основная платформа |
|
Платформа разработчика OpenAI |
59% |
40% |
|
Confident AI (DeepEval) |
36% |
10% |
|
Braintrust |
23% |
12% |
|
Anthropic Claude Console / Workbench |
16% |
10% |
|
LangSmith |
13% |
2% |
Респонденты могли указать несколько используемых инструментов, но только одну основную платформу, поэтому показатели внедрения не являются взаимоисключающими.
Самое заметное изменение за месяц — рост использования OpenAI с 31% до 59%. Показатель Confident AI также вырос — с 27% в июле до 36% в августе, хотя это различие не было статистически значимым.
VentureBeat Intelligence не сравнивала доли поставщиков среди основных платформ за эти два месяца: в июльском опросе респонденты могли назвать основной платформу, которую не указывали среди используемых, что затрудняет прямое сопоставление.
Что касается планов развития инфраструктуры, 62% участников августовского опроса собираются в течение 12 месяцев внедрить новую платформу оценки, добавить её к имеющимся или заменить существующую. Более трети (35%) рассчитывают сделать это в течение трёх месяцев.
Эти планы не обязательно означают, что организации недовольны нынешними поставщиками инструментов оценки или собираются от них отказаться. В опросе участвовали как компании, планирующие добавить ещё одну платформу к уже используемым инструментам, так и те, кто рассматривает замену.
Для поставщиков это указывает на разрыв между теми, кто играет ключевую роль в технологическом стеке, и теми, кто просто присутствует в нём. По мере развития технологий это может повлиять на конкурентные позиции и риски при продлении контрактов.
Однако опрос напрямую не измеряет удержание клиентов, долю продления контрактов или вероятность отказа от платформы организациями, использующими её как дополнительный инструмент. Пока это лишь потенциальные последствия для конкуренции, а не подтверждённые результаты.
Разрыв в доверии к корпоративному ИИ меняется, но не исчезает
В совокупности результаты августовского исследования VentureBeat Intelligence выявляют противоречие на рынке корпоративного ИИ: организации продолжают внедрять инфраструктуру оценки, но всё осторожнее относятся к использованию её автоматизированных результатов для допуска изменений в производственную среду без одобрения человека.
Доля респондентов из организаций, использующих автономных агентов, которые уже разрешают развёртывание без проверки или работают над внедрением такой возможности, существенно снизилась — с 75% до 56%. Доля тех, кто рассчитывает сохранять проверку человеком в обозримом будущем, более чем удвоилась — с 20% до 42%.
В то же время большинство респондентов, в чьих организациях проводят оценку до развёртывания, сообщили как минимум об одном инциденте, затронувшем клиентов, после того как функция прошла внутреннее тестирование. При этом лишь 29% участников из организаций, использующих автономных агентов, назвали проверки качества результатов в реальном времени основным подходом к мониторингу.
Эти результаты указывают на сохраняющиеся пробелы в системах, с помощью которых компании оценивают надёжность агентов. Однако они не доказывают, что оценки становятся менее эффективными или что именно упомянутые сбои заставили организации пересмотреть подход к автономному развёртыванию.
И компании отнюдь не отказываются от технологии: использование инструментов оценки OpenAI заметно выросло, а почти две трети участников августовского опроса рассчитывают в течение года внедрить платформу оценки, добавить её к уже используемым или заменить существующую.
Вывод для команд, занимающихся корпоративным ИИ, таков: автоматизация оценки и автоматизация одобрения развёртывания — разные решения, и последствия ошибки в исходных тестах у них тоже разные.
По мере того как агенты получают возможность вносить изменения в всё более важные бизнес-системы, компаниям нужно решать не просто, полезны ли автоматизированные оценки, а когда их результатам можно доверять настолько, чтобы убрать человека из процесса окончательного одобрения.
Августовский опрос показывает: для всё большей доли его участников этот порог пока не достигнут.