


DataFlow-Harness устраняет разрыв в точности конвейеров данных ИИ
Источник: VentureBeat · Ben Dickson


Если вы попросите ИИ-агент для написания кода создать автономный скрипт на Python для синтаксического анализа одного файла JSON, он, скорее всего, выдаст идеальный ответ за секунды. Но этот же агент часто дает сбой, если поручить ему построить систематический конвейер (пайплайн) обработки данных — например, загрузку тысяч неструктурированных документов, разбиение текста на фрагменты, оценку качества и фильтрацию шума для системы дополненной генерации (RAG), которая соответствует вашему конкретному корпоративному стеку.
Хотя большие языковые модели (LLM) отлично справляются с генерацией кода для разовых задач, их результаты для сложных задач обработки данных обычно представляют собой произвольные, одноразовые скрипты. Эти скрипты оторваны от управляемых абстракций рабочих процессов, на которые полагаются команды MLOps в продакшене, что затрудняет их аудит или визуальное редактирование.
Чтобы решить эту проблему, исследователи из Пекинского университета, академии Чжунгуаньцунь и Шанхайского института перспективных исследований в области алгоритмов представили DataFlow-Harness — проект с открытым исходным кодом, который направляет ИИ-агент на создание структурированных визуальных рабочих процессов обработки данных шаг за шагом, вместо того чтобы писать «сырой» код с нуля.
Этот фреймворк делает создаваемые ИИ конвейеры более простыми в управлении и интеграции в существующие архитектуры, поскольку полученные артефакты являются постоянными и легко поддаются редактированию.
Исследователи сообщают, что платформа достигает 93,3% успешности выполнения в сквозном режиме (end-to-end) на бенчмарке задач по инженерии данных, состоящем из 12 задач. По сравнению со стандартным Claude Code, она снижает затраты на API до 72,5% и задержку ответа на 49,9%, достигая при этом практически такого же уровня успешности, что и ИИ, которому предоставлена вся кодовая база для написания стандартных скриптов. Для корпоративных команд это означает получение скорости автоматизации с помощью ИИ без накопления неуправляемого технического долга, что гарантирует безопасность, возможность аудита и готовность конвейеров к продакшену.
«Разрыв NL2Pipeline»
ИИ, ориентированный на данные, требует рабочих процессов для таких задач, как генерация синтетических данных, дополненная генерация (retrieval augmentation) и обучение моделей. Хотя LLM могут переводить естественный язык в исполняемый код для выполнения этих задач, высокой точности выполнения недостаточно для развертывания в продакшене.
«Первой преградой обычно является вовсе не написание кода на Python, — рассказал VentureBeat Ранмин Хэ (Runming He), ведущий автор статьи о DataFlow-Harness. — Современные агенты для написания кода часто могут быстро создать правдоподобный скрипт. Более сложная проблема заключается в привязке этого скрипта к действующей производственной платформе: использовании фактически установленных операторов, сопоставлении со схемой реального набора данных, обращении к зарегистрированным наборам данных и модельным сервисам, сохранении зависимостей между этапами и создании артефакта, который другой инженер сможет понять и доработать».
ИИ-агенты общего назначения часто галлюцинируют зависимости, полагаясь на недоступные операторы или устаревшие предположения платформы. Вместо того чтобы оставлять артефакт, который другой инженер сможет понять и доработать, они генерируют одноразовый код, который трудно подвергнуть аудиту с помощью инструментов управления рабочими процессами.
Исследователи называют эту проблему «разрывом NL2Pipeline» (natural language to pipeline — от естественного языка к конвейеру): несоответствие между формулированием пользователем требований к рабочему процессу на естественном языке и потребностью производственной среды в структурированных и постоянных ресурсах конвейера.
Исследователи продемонстрировали этот разрыв в своих экспериментах. Например, когда Claude Code получил возможность писать стандартные произвольные скрипты с использованием контекста кодовой базы, показатель успешности составил 94,2%. Однако при ограничении использованием только специфических строительных блоков платформы для создания нативного графа рабочего процесса показатель успешности упал до 83,3%. Этот разрыв является главным выводом статьи: агенту значительно сложнее создавать нативные, управляемые конвейеры, чем одноразовый код.
«Преодоление этого разрыва требует большего, чем просто повышение точности генерации кода: создание должно оставаться привязанным к семантике платформы и производить артефакты, которые интегрируются с хост-платформой», — пишут исследователи.
Как четыре компонента работают вместе
«DataFlow-Harness изменяет пространство действий агента, — говорит Хэ. — Вместо того чтобы просить агента выдавать произвольный код, он извлекает активный реестр операторов и текущее состояние конвейера через MCP и применяет типизированные, инкрементные изменения к персистентному направленному ациклическому графу (DAG)».
Для этого платформа организует синтез рабочих процессов вокруг четырех компонентов: бэкенда конвейера данных (DataPipeline Backend), уровня взаимодействия (DataFlow-WebUI), слоя инструментов MCP (MCP Tools Layer) и слоя рекомендаций ИИ (DataFlow-Skills).
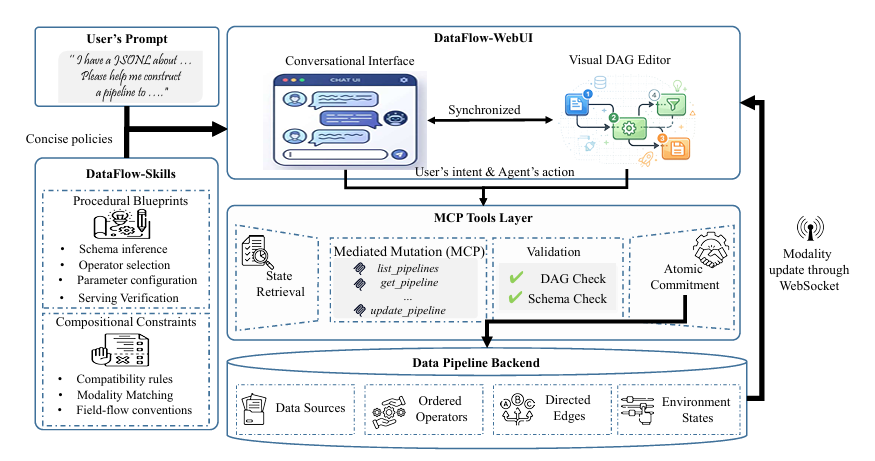
Архитектура DataFlow-Harness (источник: arXiv)
Бэкенд конвейера данных служит авторитетным источником достоверных данных (source of truth) для интерфейсов диалога, визуальных и программных средств. Он представляет конвейер в виде направленного ациклического графа (DAG) — структурированной карты рабочего процесса, содержащей источники данных, настроенные готовые модули обработки (которые исследователи называют «операторами») и зависимости выполнения. Вместо генерации произвольного кода агенты взаимодействуют с этим бэкендом посредством «типизированных мутаций», таких как добавление оператора или соединение ребер.
DataFlow-Skills представляют собой файлы в формате Markdown, которые внедряют доменно-специфичные знания в контекстное окно модели, направляя ее в вопросах выбора шаблонов операторов, вывода схем и процедур сборки. Навыки не позволяют ИИ гадать, как собирать компоненты, а предоставляют ему правила совместимости, обучая правильно сопоставлять различные форматы данных и обрабатывать сложные структуры данных без нарушения работы конвейера.
Слой инструментов MCP дает ИИ доступ к реестру операторов и текущему состоянию рабочего процесса данных. ИИ предлагает структурированные изменения через слой инструментов. Система проверяет эти изменения, чтобы гарантировать выполнение рабочего процесса в правильной последовательности и использование каждым подключенным модулем единого языка данных.
DataFlow-WebUI предоставляет два интерфейса, позволяющие людям и ИИ создавать рабочий процесс совместно. Разработчики могут описывать требования к рабочему процессу на естественном языке с помощью интерфейса чата. Они также могут работать с рабочим процессом как с графической картой в визуальном редакторе DAG. Здесь они могут напрямую изучать изменения, предложенные ИИ, и вносить в них правки.
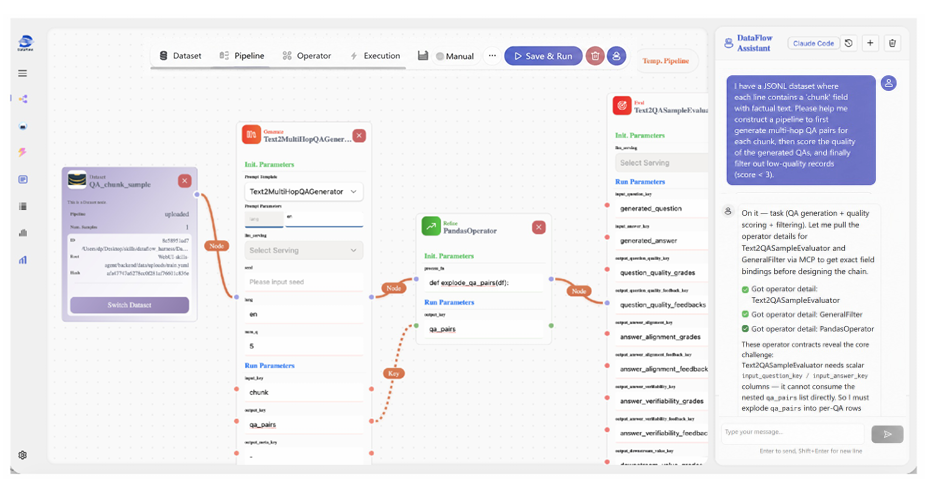
DataFlow-WebUI (источник: arXiv)
«Текущая реализация выполняет статическую проверку метаданных платформы перед принятием изменений в конвейере, — пояснил Хэ. — Она включает в себя проверку зарегистрированных наборов данных, операторов и ссылок на развертывание моделей, потоков полей, некоторого некорректного использования параметров, а также структурной валидности. Результат отображается в графическом редакторе и может быть изменен либо вручную, либо агентом на последующих этапах».
Результаты: 93,3% успешных прогонов, снижение затрат на 72,5%
Исследователи протестировали DataFlow-Harness на бенчмарке, состоящем из 12 задач в шести сценариях промышленной обработки данных, таких как генерация вопросов и ответов (QA), модерация отзывов и нормализация схем. В качестве базовой (backbone) модели в экспериментах использовалась Claude Opus 4.7.
Они сравнили DataFlow-Harness с тремя базовыми подходами (базовыми линиями):
-
Vanilla CC: некондиционированная базовая линия написания кода с использованием стандартного Claude Code.
-
Context-Aware CC: агент, имеющий доступ к кодовой базе DataFlow в своем контекстном окне.
-
MCP-only: агент, имеющий доступ к инструментам MCP DataFlow и получивший инструкцию генерировать нативные для платформы DAG (без доступа к DataFlow-Skills).
DataFlow-Harness достиг показателя успешности сквозного выполнения в 93,3%, улучшив результат варианта MCP-only на 10,0 процентных пунктов, обогнав Vanilla CC (91,7%) и приблизившись на расстояние 0,9 процентных пункта к Context-Aware CC (94.2%).
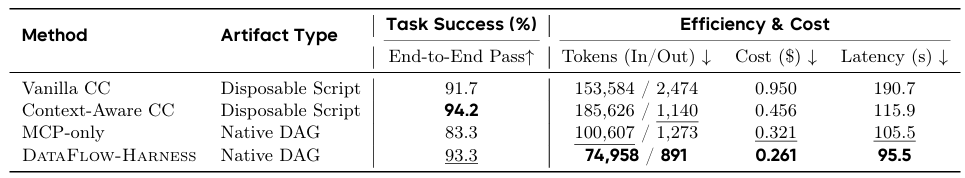
Производительность DataFlow-Harness на бенчмарках обработки данных (источник: arXiv)
Важно отметить, что он снизил затраты на API до $0,261 за задачу, что на 72,5% меньше по сравнению с Vanilla CC и на 42,8% по сравнению с Context-Aware CC. При генерации рабочих процессов он работал на 49,9% быстрее, чем Vanilla CC, и на 17,6% быстрее, чем Context-Aware CC.
DataFlow-Harness доказал свою особую эффективность в решении сложных задач, зависящих от неявных предметных знаний, таких как генерация вопросов и ответов. Базовый подход MCP-only часто генерировал структурно правильные DAG, но испытывал трудности с выведением специфических для задачи процедур только на основе описаний операторов.
Чтобы показать, как это работает в реальных условиях, исследователи подробно описали задачу извлечения данных из учебников для визуального ответа на вопросы (VQA). Эта работа потребовала от ИИ объединения таких возможностей, как синтаксический анализ PDF, восстановление разметки, распознавание текста (OCR), извлечение иллюстраций, мультимодальное понимание и сопоставление вопросов и ответов на больших дистанциях. DataFlow-Harness достиг точности 97,2% и коэффициента охвата 87,3%, с легкостью превзойдя базовые показатели. За счет того, что ИИ собирал воедино существующие ресурсы платформы, а не писал код для сложных задач с нуля, система извлекла из документа больше валидных пар «вопрос-ответ».
Их эксперименты также показали, что DataFlow-Harness чрезвычайно эффективен при создании конвейеров генерации данных. Например, в задаче генерации синтетических данных для инструкций агент построил многоступенчатый конвейер, который генерировал пары «кандидат инструкции и ответа», критиковал и переписывал их, оценивал с помощью судьи на базе LLM и фильтровал низкокачественные результаты перед обучением.
«Создание таких рабочих процессов обходится дорого, а их поддержка в виде набора специальных скриптов ненадежна, — отметил Хэ. — Этот инструмент не делает их автоматически безопасными, но превращает их в явные, редактируемые этапы, которые инженеры могут проверять, тестировать и контролировать с помощью стандартных производственных средств управления».
Аналогичным образом, при постановке задачи создания конвейера очистки и синтеза математических данных, данные, полученные с помощью пайплайна DataFlow-Harness, позволили обучить более эффективную модель с более высокой средней точностью на бенчмарках AIME24 и AIME25 по сравнению с данными, созданными с помощью стандартного конвейера Claude Code.
Соответствие техстеку и компромиссы при внедрении
Для инженерных команд, оценивающих DataFlow-Harness, важно понимать, как он вписывается в существующую инфраструктуру. Выпущенный под лицензией Apache 2.0, текущий проект требует определенных инженерных усилий для интеграции в популярные технологические стеки.
«Текущая реализация является нативной для платфорлы DataFlow; это не готовый плагин для Airflow, Prefect или Spark», — сказал Хэ. Чтобы использовать эти системы в качестве основы для выполнения, командам необходимо создать адаптер, соединяющий реестр их организации, метаданные и интерфейсы выполнения со слоем управления агента.
Кроме того, организации должны инвестировать в определение границ, которые ИИ должен соблюдать. Это требует ведения реестра операторов, определения схем и кодирования повторяющихся процедур предметной области в виде навыков (Skills). Из-за этих накладных расходов Хэ не рекомендует использовать фреймворк для небольших разовых преобразований, где достаточно простого скрипта, или в устаревших средах, которые не могут предоставить надежные метаданные.
Наконец, хотя платформа предотвращает нелогичные соединения путем проверки структурных свойств, она является слоем инженерного контроля, а не заменой процедурам комплаенса. «Этот инструмент все равно следует рассматривать как слой инженерного контроля, а не как замену политике соответствия требованиям, проверенным моделям обнаружения, средствам контроля доступа, аудиту логирования или человеческому одобрению», — подчеркнул он.
Платформа имеет открытый исходный код, и разработчики могут получить доступ к исходному коду и документации непосредственно через репозиторий проекта на GitHub.
По мере стандартизации таких протоколов, как MCP, грань между инженерами-людьми и агентами ИИ будет смещаться. «Цель состоит не в автономной инженерии данных без надзора, — резюмировал Хэ. — Это лучшее разделение труда: агенты выполняют рутинное строительство внутри четких границ, в то время как инженеры продолжают нести ответственность за семантику, политику и важные решения, требующие подотчетности в рамках предметной области».




