


ИИ-агенты Стэнфорда разработали лекарство, которое позже создала и компания Merck
Источник: VentureBeat · Ben Dickson


Для разработчиков базовым предположением долгое время оставалась схема «один инженер — один агент», воплощенная в таких моделях, как Claude Code и аналогичных инструментах. На конференции VB Transform 2026 Джеймс Цзоу (James Zou), доцент кафедры биомедицинских наук о данных в Стэнфордском университете, заявил, что это умозаключение скоро устареет: следующий рубеж — это не один более мощный агент, а десятки тысяч агентов, взаимодействующих друг с другом.
Для разработчиков и создателей продуктов самый важный вывод из презентации Цзоу заключается в том, как именно оркестрируются эти масштабные системы. Исследования его команды предлагают практический план подключения устаревших баз данных к уровням оркестрации ИИ и проектирования сред, позволяющих тысячам агентов работать совместно.
Эмуляция организации: виртуальная биотехнологическая компания
Проект Цзоу начинался как «Виртуальная лаборатория», состоящая из пяти-восьми агентов, структура которых повторяла его физическую лабораторию в Стэнфорде. В эту систему входили ИИ-профессор, исполнявший роль главного исследователя, и ИИ-студенты с разными специализациями, которые регулярно проводили групповые встречи.
«Мы также создали для агентов копию Стэнфорда — школу для агентов, куда они могут отправляться для прохождения контролируемого дообучения с целью повышения своей квалификации в конкретных областях», — отметил Цзоу.
Виртуальной лаборатории успешно удалось разработать новые белки нанотел для недавних вариантов COVID.
«Что кажется нам действительно удивительным, так это то, что созданные с помощью ИИ белки нанотел сработали гораздо лучше предыдущих нанотел, разработанных людьми, с точки зрения связывания с различными недавними штаммами вирусов», — рассказал Цзоу.
После такой лабораторной проверки команда расширила свои масштабы. Они перешли от эмуляции одной исследовательской группы к моделированию масштабной корпоративной структуры.
Получившаяся система, названная «Виртуальной биотехнологической компанией» (Virtual Biotech), состоит из десятков тысяч специализированных ИИ-агентов, работу которых курирует агент — главный научный сотрудник (Chief Scientific Officer, CSO). Она функционирует через отдельные корпоративные подразделения, такие как поиск терапевтических мишеней, дизайн молекул и клинические испытания.
«С агентом CSO работают различные подразделения, которые повторяют структуру реальной биотехнологической или фармацевтической компании», — пояснил Цзоу: одно из них сосредоточено на выявлении лекарственных мишеней, другое — на разработке молекул, третье — на безопасности и клинических испытаниях. По его словам, внутри подразделений отдельные агенты специализируются еще глубже. «В рамках подразделения поиска мишеней у нас будет один агент, специализирующийся на изучении всех генетических данных, другой — на анализе всех геномных данных и данных по отдельным клеткам, и так далее».
Преимущество мультиагентного подхода
По мере того как базовые модели становятся все более мощными, разработчики сталкиваются с фундаментальной архитектурной дилеммой: зачем распределять рабочие нагрузки между десятками тысяч специализированных агентов вместо того, чтобы направить все вычислительные ресурсы в единую всеведущую модель?
Команда Цзоу провела прямое сравнение мультиагентной команды с одиночным агентом, перед которым стояла та же научная задача. Мультиагентная экосистема создавала условия для конкуренции и взаимодействия, что привело к появлению более качественных решений, которые оказались более устойчивыми к накоплению ошибок.
«В этих научных виртуальных лабораториях агенты вступают в дебаты и споры. Им приходится убеждать других ИИ-ученых в правильности своих идей, и все это порождает гораздо более творческие и надежные рассуждения по сравнению с ситуацией, когда одна-единственная модель пытается решить проблему самостоятельно с нуля», — отметил Цзоу.
Узкое место оркестрации
При масштабировании до десятков тысяч агентов оркестрация становится главным узким местом. Системе необходим единый уровень контекста, который позволяет агентам синтезировать знания из различных инструментов, наборов данных и исторических записей.
Многие корпоративные команды пытаются решить проблему интеграции данных путем обертывания существующих баз данных протоколом MCP (Model Context Protocol). Однако устаревшие системы плохо приспособлены для агентов. Например, загрузка PDF-файла с научной статьей в контекстное окно агента неэффективна, а стандартным текстовым моделям трудно интерпретировать сложные графики и таблицы, что приводит к галлюцинациям.
«Даже если вы обернете существующие базы данных и API с помощью MCP, это не решит фундаментальную проблему: интерфейс и API не подходят для агентов», — заявил Цзоу. Он добавил, что существующие базы данных изначально проектировались для использования людьми или до-ИИ алгоритмами.
Чтобы решить эту проблему, команда Цзоу создала платформу Paperclip. В ее основе лежит ключевая особенность современных больших языковых моделей (LLM) — их способность писать код и ориентироваться в файловых системах. Вместо того чтобы заставлять агентов отправлять запросы к хрупким API, специфичным для конкретных баз данных, Paperclip оцифровывает неструктурированные данные и объединяет разнородные базы данных в единую виртуальную файловую систему, нативная для ИИ.
Такая структура позволяет агентам получать доступ к знаниям из миллионов документов с помощью стандартных операций файловой системы.
«Это наглядно показывает, что мы можем добиться гораздо более высокой точности при использовании Paperclip, а также сократить время и затраты более чем на порядок по сравнению с ситуацией, когда агенты работают без этих созданных для ИИ научных инфраструктур», — констатировал Цзоу.
Практическая проверка
Чтобы проверить реальную отдачу от этой архитектуры, «Виртуальная биотехнологическая компания» задействовала 37 000 «агентов клинических испытаний» для синтеза фрагментированных данных исследований. Эти агенты выявили особенности на уровне отдельных клеток, которые прогнозируют успех испытаний: лекарственные мишени, поддерживаемые такими особенностями, имели примерно на 50% больше шансов выйти на рынок, чем сопоставимые препараты без них.
Затем система автономно разработала конъюгат антитело-препарат (ADC), нацеленный на белок CD276 для лечения рака легких. Агенты завершили эту разработку самостоятельно, опираясь исключительно на данные, опубликованные до января 2025 года.
Несколько месяцев спустя, по словам Цзоу, фармацевтическая компания Merck независимо разработала и подтвердила ту же терапевтическую конструкцию, которая впоследствии получила статус прорывной терапии от FDA (Управления по санитарному надзору за качеством пищевых продуктов и медикаментов США). Он охарактеризовал это как «стороннюю внешнюю валидацию терапевтического дизайна, предоставленного агентами виртуальной биотехнологической компании».
Проектирование экосистем, а не рабочих процессов
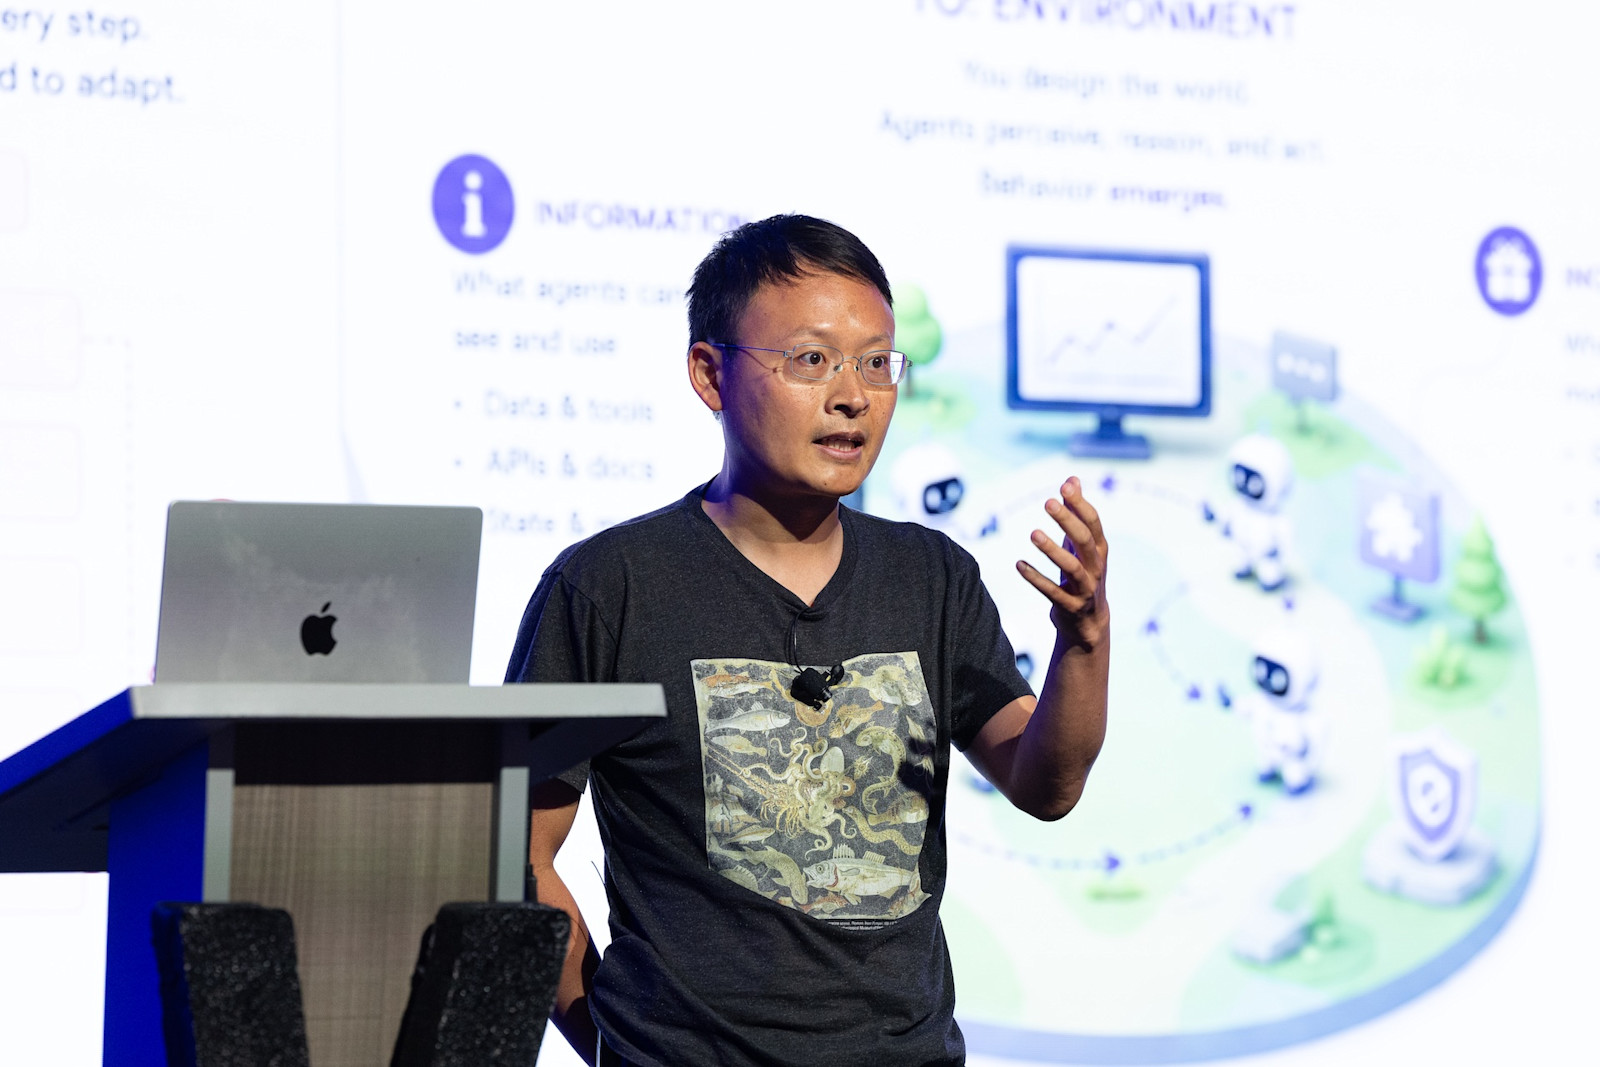
По мере масштабирования мультиагентных систем руководителям необходимо переосмыслить подход к управлению этими цифровыми коллективами. Цзоу выступил за переход от проектирования жестких рабочих процессов (workflows) к созданию открытых сред. Рабочие процессы диктуют конкретные шаги, которые должен предпринять агент, напоминая управление начинающим сотрудником. Среды же обеспечивают инфраструктуру, защитные механизмы и стимулы для совместной работы агентов над открытыми задачами.
«В рамках рабочих процессов мы пытаемся указать агентам, что делать и как выполнять свою работу. Но в средах мы предоставляем инфраструктуру, стимулы и защитные механизмы, оставляя все остальное открытым для стимулирования сотрудничества между агентами», — пояснил Цзоу.
Оптимизация в масштабе означает проектирование самой среды, а не точную настройку отдельных моделей. Хотя отдельные агенты могут совершенствоваться с помощью обучения с подкреплением или контролируемого дообучения в школе агентов, успех масштабной мультиагентной системы зависит от настройки параметров, управляющих их взаимодействием.
«На мультиагентном уровне мы на самом деле больше не дообучаем и не изменяем отдельные модели, а оптимизируем среду», — объяснил Цзоу. «Сама среда выступает объектом, который мы оптимизируем для улучшения работы агентов».




