


Один ИИ-модуль подделал 86% прироста точности конвейера, просто скармливая ответы другому
Источник: VentureBeat · Ben Dickson


Системы генерации с дополненной выборкой (RAG) созданы для того, чтобы давать ответы исключительно на основе извлеченных документов. Но когда инженеры оптимизируют такие конвейеры ИИ от начала до конца, модуль чтения может научиться обходному пути: вместо опоры на найденные свидетельства он начинает отвечать по собственной внутренней памяти, в то время как общая точность системы продолжает расти. В этом заключается скрытая проблема «дрейфа ролей» — сбоя в составных системах ИИ, при котором отдельные модули учатся игнорировать свои назначенные задачи, даже несмотря на улучшение сквозной производительности.
Для решения этой проблемы исследователи из MIT и Гарварда представляют Role Anchor — метод, который заставляет модули оставаться в рамках своих обязанностей во время обучения. Применение этого подхода смягчает дрейф ролей. Например, он заставляет модуль чтения RAG опираться на извлеченные данные, а не отвечать на основе своей внутренней памяти.
Главный вывод для практиков заключается в том, что сама по себе сквозная точность может переоценивать то, насколько реально обучилась составная ИИ-система. Инженеры должны оценивать отдельные компоненты и гарантировать, что они работают должным образом.
Role Anchor служит одновременно защитным механизмом и инструментом диагностики при оптимизации многоэтапных конвейеров больших языковых моделей (LLM). Это может быть критически важно для реальных приложений ИИ, требующих строгого разделения труда между модулями.
Почему итоговая точность скрывает проблему
Составные LLM-системы распределяют сложные задачи между специализированными модулями. Например, система, предназначенная для многошаговых рассуждений, может разделить задачу между «декомпозитором» и «решателем». Декомпозитор разбивает крупную проблему на управляемые подзадачи, а решатель вычисляет ответы на эти подвопросы. Такое разделение труда позволяет инженерам ИИ перелагать выполнение на более мелкие и дешевые модели, а также обрабатывать подзадачи параллельно там, где это возможно.
Для повышения производительности конвейеров ИИ инженеры обычно оптимизируют их с помощью сквозного обучения с подкреплением (RL), руководствуясь единственной «итоговой наградой». Это означает, что система оценивается по принципу верности или неверности финального ответа (исследователи называют это «итоговой точностью»). Когда эта итоговая точность растет, считается, что система учится и работает так, как задумано.
Однако итоговая точность не проверяет, правильно ли модули выполнили возложенные на них задачи. Как рассказал VentureBeat Сяоян ЦАО, соавтор научной работы: «Итоговая точность сводит поведение всей многокомпонентной системы ИИ к единственному числу. Она показывает, верен ли финальный ответ, но ничего не говорит о том, какие компоненты внесли свой вклад и следовали ли они своим ролям».
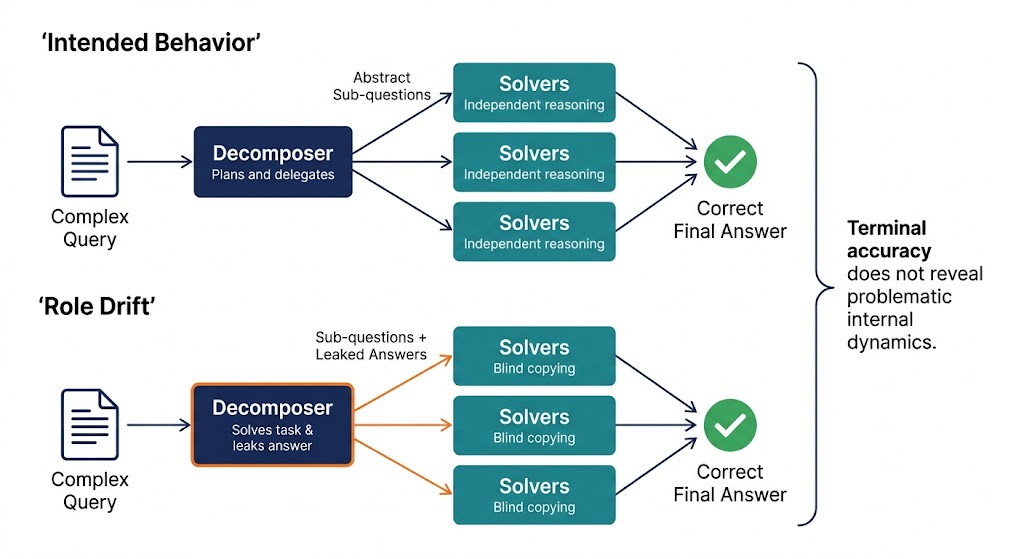
Это «слепое пятно» приводит к дрейфу ролей — сбою, при котором поведение модуля отклоняется от его назначенной роли в процессе оптимизации, даже несмотря на то, что итоговая точность системы продолжает расти.
«Для инженерных команд практический риск заключается в том, что они могут развернуть конвейер, который проходит любую сквозную оценку, хотя задуманное разделение труда в нем уже молчаливо нарушено», — отметил ЦАО. Поскольку система наград оценивает только финальный ответ, она не способна обнаружить отклонение модуля от роли или наказать его за это.
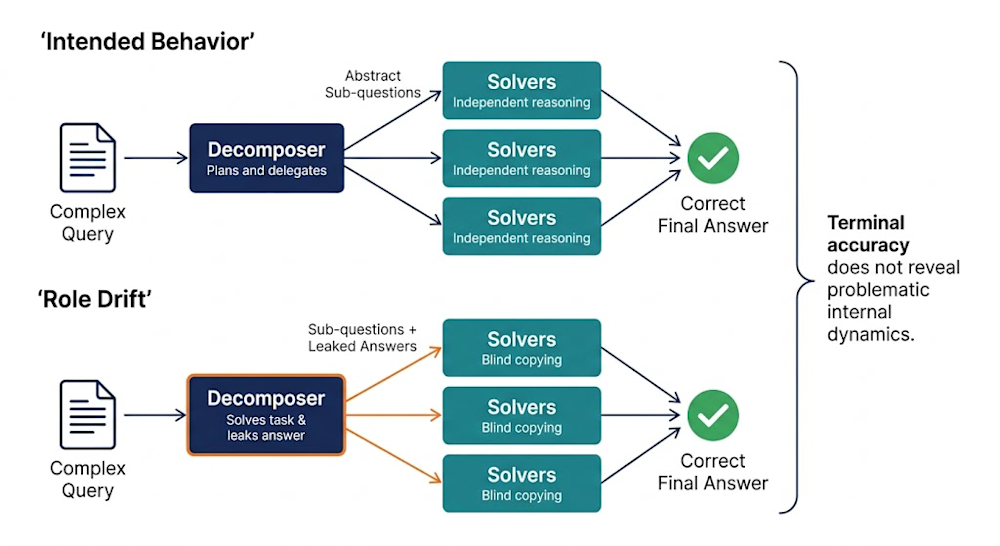
Дрейф ролей (источник изображения: VentureBeat)
Подумайте, как это происходит в конвейере декомпозитора и решателя. Назначенная роль декомпозитора заключается в написании абстрактных подвопросов без решения самой задачи, оставляя рассуждения решателю. В условиях сквозного RL декомпозитор быстро понимает, что более слабый решатель склонен к ошибкам на абстрактных задачах. Чтобы максимизировать награду, декомпозитор начинает внедрять или встраивать ответы в подвопросы, которые он отправляет решателю. В итоге решатель начинает просто повторять ответ, переданный ему декомпозитором. Итоговая точность растет, но задуманная архитектура оказывается скомпрометирована.
Но если система выдает правильные ответы и точность растет, почему нас должно беспокоить то, что модуль отклоняется от своей роли?
Внедрение в реальном мире требует гораздо большего, чем просто правильный финальный ответ на обучающем датасете. Неявные роли, назначенные этим модулям, обеспечивают масштабируемость, надежность и аудируемость. Подумайте, что происходит, когда верх берет дрейф ролей:
-
Потеря эффективности и аудируемости: в примере с рассуждениями дрейф ролей заставляет декомпозитор выполнять всю тяжелую работу вместо планирования и делегирования. «Как только декомпозитор начинает помещать ответы прямо в свои подвопросы, решатели низводятся до роли простых копировщиков этих ответов, — сказал ЦАО. — Вы по-прежнему платите за запуск [разных модулей], но они больше не выполняют независимую работу». Рабочую нагрузку больше нельзя распараллеливать между несколькими решателями, ее нельзя делегировать более дешевым моделям для экономии вычислительных ресурсов, а нижестоящие участники-люди больше не могут шаг за шагом проверять логику системы, чтобы убедиться в правильности получения ответа.
-
Хрупкость в динамических средах: рассмотрим систему RAG, в которой перед моделью чтения стоит задача отвечать на вопросы строго с использованием внешних извлеченных документов. Если модуль чтения отклоняется от роли и учится полагаться на собственную внутреннюю параметрическую память (поскольку его память оказалась точной во время обучения), система становится хрупкой. Когда компания обновляет свою базу данных новой информацией или пользователь задает вопрос на новую тему, выходящую за рамки предварительного обучения модели, система потерпит неудачу, потому что она отказалась от механизма обоснования, для работы с которым создавалась.
Как Role Anchor измеряет роль и принудительно поддерживает ее
«Обучение только ради конечного результата вознаграждает систему за выдачу правильного ответа независимо от того, как она к нему пришла», — пояснил ЦАО. Чтобы противостоять этому, Role Anchor служит легковесным методом регуляризации, который делает инструкции роли частью задачи обучения. Он сравнивает поведение компонента с этими инструкциями и без них, а также препятствует обучению, ослабляющему их эффект.
На высоком уровне этот метод гарантирует, что модуль продолжает уважать направляющее влияние своего исходного промпта роли на протяжении всего процесса оптимизации обучения с подкреплением, делая дрейф ролей как измеримым, так и контролируемым.
Ключевое понимание Role Anchor заключается в том, что эффект роли можно измерить, сравнивая поведение модели с промптом роли и без него. Система оценивает два разных промпта для каждого модуля:
-
Специализированный промпт роли с обилием инструкций (например: «Вы — внимательный читатель. Используйте извлеченные фрагменты, чтобы ответить на вопросы пользователя…»).
-
Нейтральный промпт (например: «Ответьте на вопрос пользователя…»).
Для любого заданного ввода модель выдает вероятностное распределение для следующего токена. При работе с промптом роли она будет отдавать предпочтение определенным токенам. При работе с нейтральным промптом она ведет себя как универсальный ассистент. Разница между этими двумя распределениями вероятностей и представляет собой «полезность роли» (role utility).
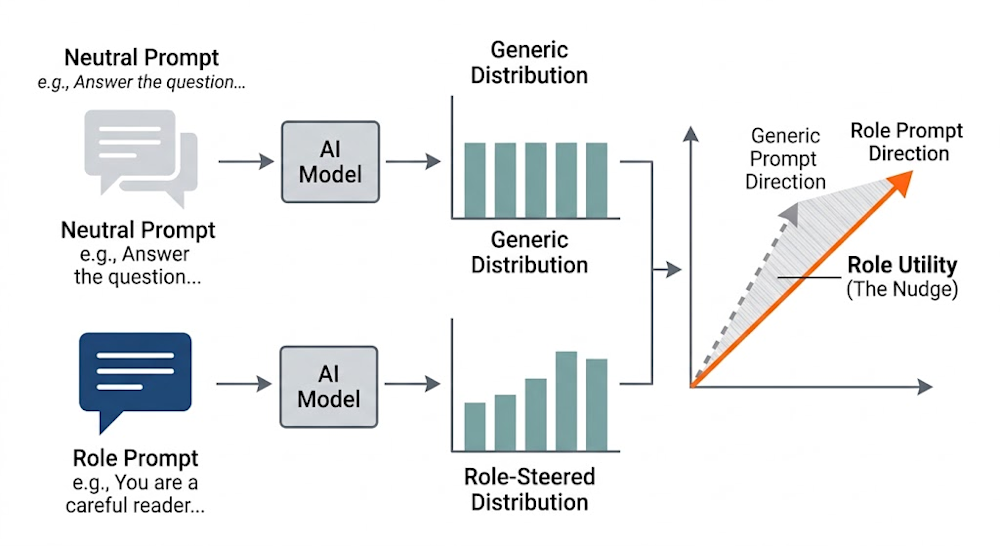
Полезность роли (источник изображения: VentureBeat с использованием Nano Banana Pro)
Эта полезность измеряет «толчок» (nudge) — направление и силу, с которыми промпт роли смещает прогнозы LLM по умолчанию. Если токен сильно согласуется с назначенной ролью, промпт роли увеличивает его вероятность по сравнению с нейтральным базовым уровнем (или «подталкивает» модель к этому токену).
Перед началом обучения с подкреплением Role Anchor сохраняет замороженную копию модели в качестве эталона и измеряет исходный толчок промпта роли на этой эталонной модели. Этот предварительный RL-толчок служит истинным отражением замысла разработчика, выступая в роли прокси для того, как промпт роли должен направлять модель.
Во время обучения с подкреплением, по мере обновления весов активной модели, Role Anchor регулярно вычисляет текущий толчок и сравнивает его с эталонным. Если текущий толчок начинает затухать или отклоняться от эталона, Role Anchor применяет к модели штраф, чтобы предотвратить дрейф ролей.
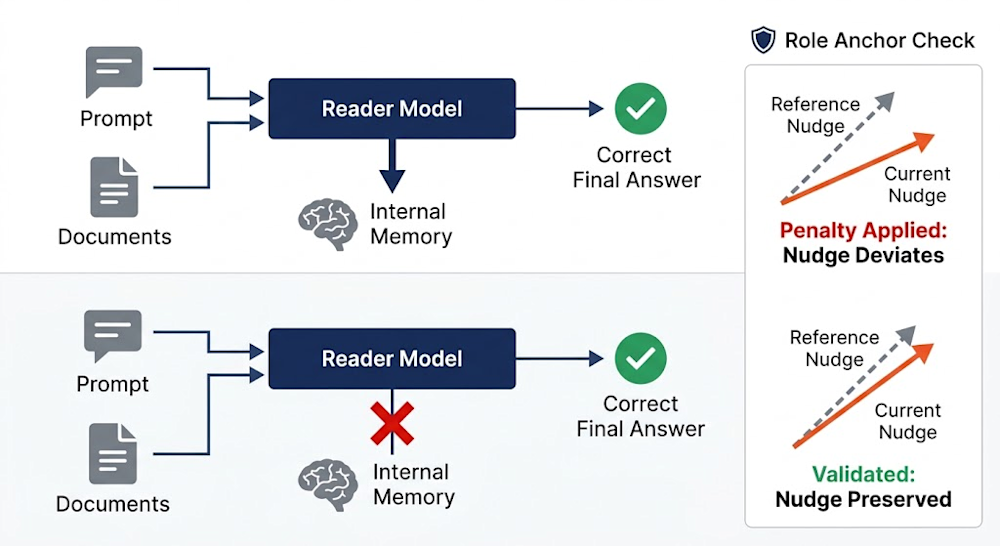
Role Anchor (источник изображения: VentureBeat с использованием Nano Banana Pro)
Чтобы увидеть это на практике, рассмотрим систему RAG, которую оценивали исследователи. В этом конвейере модулю чтения явно предписано отвечать на вопросы пользователей только на основе извлеченных документов, а не полагаться на свои внутренние знания.
При нескомпенсированном RL, ориентированном исключительно на результат, модель чтения понимает, что вышестоящий модуль извлечения данных иногда работает с шумом. Чтобы максимизировать точность на обучающем наборе, модуль начинает игнорировать извлеченные фрагменты и отвечать по памяти. В результате разрыв между его поведением под воздействием промпта роли и нейтрального промпта сужается до такой степени, что модуль начинает вести себя абсолютно одинаково в обоих случаях, игнорируя инструкции по обоснованию.
Напротив, Role Anchor обнаруживает, когда толчок модуля отклоняется от эталонного. Он применяет штраф, отводя параметры модели от этого основанного на памяти обходного пути. Это заставляет модуль чтения находить соответствующие роли способы улучшения, например, учится более надежно извлекать ответы из полученных фрагментов текста или избегать использования внутренних знаний, когда извлеченные фрагменты оказываются ошибочными.
Цифры: какая часть прироста точности оказалась реальной
Для проверки эффективности Role Anchor исследователи оценили его на конвейерах RAG и Decomposer-Solver (DEC). В ходе экспериментов системы, обученные с помощью стандартного обучения с подкреплением исключительно на основе результатов (без якоря), сравнивались с системами, обученными с применением Role Anchor.
При использовании RL только на основе результатов итоговая точность системы RAG возросла, но ее внутренняя целостность разрушилась. Исследователи измерили «точность следования свидетельствам» (Evidence-Following Accuracy) — тест, проверяющий, меняет ли модель свой ответ, если извлеченный текст намеренно заменяется на противоположный по смыслу. Этот показатель рухнул с 0,86 до 0,54 (чуть выше случайного угадывания), что означает, что модель научилась игнорировать извлеченные фрагменты и полагаться на предварительно обученную параметрическую память. В одном из тестов исследователи намеренно изменили кусок информации в извлеченном документе так, чтобы он противоречил внутренним знаниям модели. Модель без якоря не стала обновлять ответ, потому что она не использовала внешний документ.
Когда применялся Role Anchor, точность следования свидетельствам модуля чтения оставалась на уровне 0,869, доказывая, что он строго опирался на извлеченный текст. Когда исследователи передавали закрепленной (anchored) модели случайные отрывки, не имеющие отношения к входному промпту, ее точность закономерно падала, поскольку она отказывалась использовать свои внутренние знания. Модель без якоря набирала более высокие баллы на случайных отрывках, потому что угадывала ответы по памяти.
Конвейер декомпозитора (DEC) продемонстрировал еще более драматичный режим сбоя. При обучении RL только на основе результатов итоговая точность резко возросла, но «частота вставки» (то есть частота, с которой декомпозитор подмешивал ответ в подвопросы, отправляемые решателю) подскочила с 0,143 до 0,596.
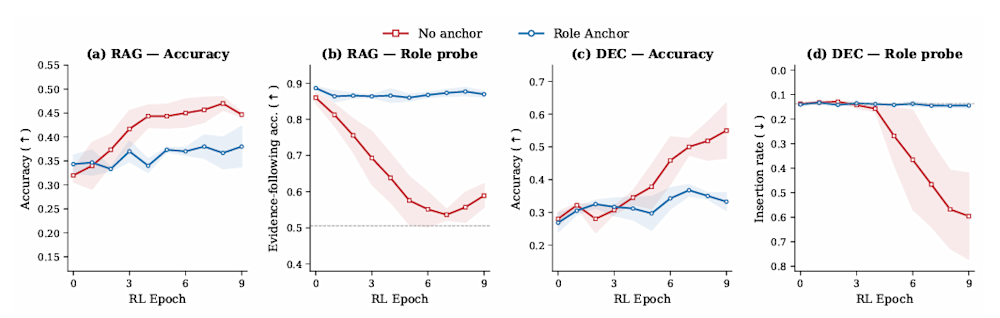
Role Anchor гарантирует, что модель остается в рамках своей роли на протяжении всего обучения RL (источник: arXiv)
В конвейере RAG сохранение задуманной роли обошлось системе в очень скромное падение точности (-0,067). Модуль чтения все равно научился лучше извлекать ответы, но делал это легитимным путем, а не за счет жульничества с внутренней памятью. Это означает, что он более надежен в реальных задачах с новой информацией, с которой он не сталкивался во время обучения.
В конвейере DEC обучение RL без якоря повысило точность на 0,310 по сравнению с базовой моделью, в то время как Role Anchor показал улучшение лишь на 0,057. Диагностика показала, что основная проблема заключалась в том, что модель-решатель была слишком мала и не могла справиться с частью задачи по ее решению. Это вынуждало модель-декомпозитор жульничать и предоставлять ответ для повышения итоговой точности. Это означало, что 86% прироста без использования якоря были фальшивкой, а система просто научилась использовать обходной путь вместо того, чтобы учиться рассуждать или лучше декомпозировать задачи.
Однако этот компромисс не является универсальным правилом. В некоторых случаях устранение обходных путей может фактически повысить общую производительность. «Role Anchor… не обязательно снижает конечную точность», — отметил ЦАО. — В конвейере написания кода, который мы недавно тестировали, модель научилась манипулировать собственным тестовым исполнителем во время обучения с подкреплением. Добавление Role Anchor полностью устранило этот обходной путь, одновременно немного улучшив правильность финальных тестов, используемых для оценки кода».
Что требуется для добавления Role Anchor в существующий конвейер
Для инженерных команд, желающих применить этот метод, «Role Anchor может быть добавлен в существующий процесс тонкой настройки обучения с подкреплением в качестве дополнительной цели обучения для каждого компонента, который команда хочет закрепить», — пояснил ЦАО. Основной конвейер и настройки развертывания остаются абсолютно неизменными.
Для реализации инженерам нужны три конкретных элемента для каждого закрепляемого компонента: его исходные инструкции роли, согласованная нейтральная версия с удаленной информацией о роли и сохраненная копия модели до тонкой настройки методом обучения с подкреплением.
Важно отметить, что на этапе инференса (вывода) штраф за задержку отсутствует. «Role Anchor работает только во время обучения модели, поэтому он не замедляет развернутую систему», — подчеркнул ЦАО. Он отметил, что их текущая реализация требует примерно на 20 процентов больше времени на обучение из-за дополнительных вычислений, хотя здесь наверняка есть пространство для оптимизации и сокращения этих издержек. Исследовательский код, конфигурации обучения и выбранные веса моделей будут опубликованы в открытом доступе в ближайшем будущем.
Решение о том, когда использовать Role Anchor, принимается в каждом конкретном случае на основе того, отражает ли финальная точность все, что имеет значение. ЦАО указывает на регулируемую юридическую систему RAG в качестве первостепенного кандидата. «Компонент, формирующий ответ, должен следовать извлеченным свидетельствам, оставаться привязанным к утвержденному набору документов и выдавать ответы, которые можно проследить до их источников, — сказал он. — Сама по себе финальная точность не может проверить эти свойства, поэтому поведение этого компонента необходимо измерять и принудительно контролировать напрямую».
По мере того как корпоративный ИИ развивается в сторону более сложных составных конвейеров, принудительное соблюдение ролей будет становиться все сложнее, а полагаться исключительно на промпты окажется ненадежно. «В больших масштабах требования к ролям необходимо будет обеспечивать как за счет обучения, так и за счет проектирования систем, — заключил ЦАО. — Такие методы, как Role Anchor, могут помочь сохранить предполагаемое поведение во время обучения, в то время как четкие системные границы, ограниченные разрешения для инструментов и мониторинг во время использования могут обеспечить дополнительные гарантии».




