


Voxtral TTS от Mistral бросает вызов ElevenLabs


Рынок корпоративного голосового искусственного интеллекта переживает период активного передела сфер влияния. Компания ElevenLabs и корпорация IBM объявили на этой неделе о сотрудничестве, цель которого — интегрировать функции премиального синтеза речи в платформу IBM watsonx Orchestrate. Google Cloud продолжает расширять возможности своих моделей HD-голосов Chirp 3. OpenAI продолжает совершенствовать собственные технологии синтеза речи. При этом рынок, лежащий в основе всей этой активности, колоссален: объем мирового рынка голосового ИИ в 2026 году превысил 22 миллиарда долларов, а по оценкам экспертов, один лишь сегмент голосовых ИИ-агентов к 2034 году достигнет 47,5 миллиарда долларов.
В четверг утром компания Mistral AI вступила в эту борьбу с принципиально иным предложением. Парижане выпустили Voxtral TTS — первую модель преобразования текста в речь передового уровня (frontier-quality) с открытыми весами, разработанную специально для корпоративного использования. В то время как каждый из основных конкурентов в этой сфере развивает проприетарный бизнес по принципу API-first (предприятия арендуют голос, но не владеют им), Mistral публикует веса модели целиком, предлагая компаниям скачивать Voxtral TTS, запускать ее на собственных серверах или даже на смартфонах и никогда не передавать ни единого аудиофрагмента третьим лицам.
Это ставка на то, что будущее корпоративного голосового ИИ будут определять не те, кто создаст самую благозвучную модель, а те, кто предоставит компаниям максимальный контроль над ней. Продукт появляется в момент, когда Mistral, чья стоимость после раунда финансирования серии C на сумму 2 миллиарда долларов под руководством нидерландского производителя чипов ASML в сентябре прошлого года составила 13,8 миллиарда долларов, активно собирает воедино компоненты полноценного корпоративного стека ИИ, находящегося в собственности компаний. Сюда входят платформа кастомизации Forge, представленная на конференции Nvidia GTC в начале этого месяца, производственная инфраструктура AI Studio, а также модель распознавания речи Voxtral Transcribe, выпущенная всего несколько недель назад.
Voxtral TTS выступает в качестве выходного слоя, завершающего эту картину и предоставляющего предприятиям сквозной конвейер преобразования речи в речь, который можно запускать автономно, не полагаясь на каких-либо внешних провайдеров.
«Мы рассматриваем аудио как серьезную ставку, как важнейший и, возможно, единственный будущий интерфейс для взаимодействия со всеми моделями ИИ», — заявил Пьер Сток (Pierre Stock), вице-президент Mistral по науке и первый сотрудник компании, в эксклюзивном интервью для VentureBeat. — «Это то, о чем давно просили клиенты».
Модель с 3 миллиардами параметров, которая помещается на ноутбуке и работает в шесть раз быстрее реального времени
Технические характеристики Voxtral TTS выглядят как намеренное опровержение сложившихся в отрасли норм. Если большинство передовых моделей синтеза речи отличаются большими размерами и высокой ресурсоемкостью, то Mistral создала модель примерно в три раза меньше того, что принято считать отраслевым стандартом для аналогичного качества.
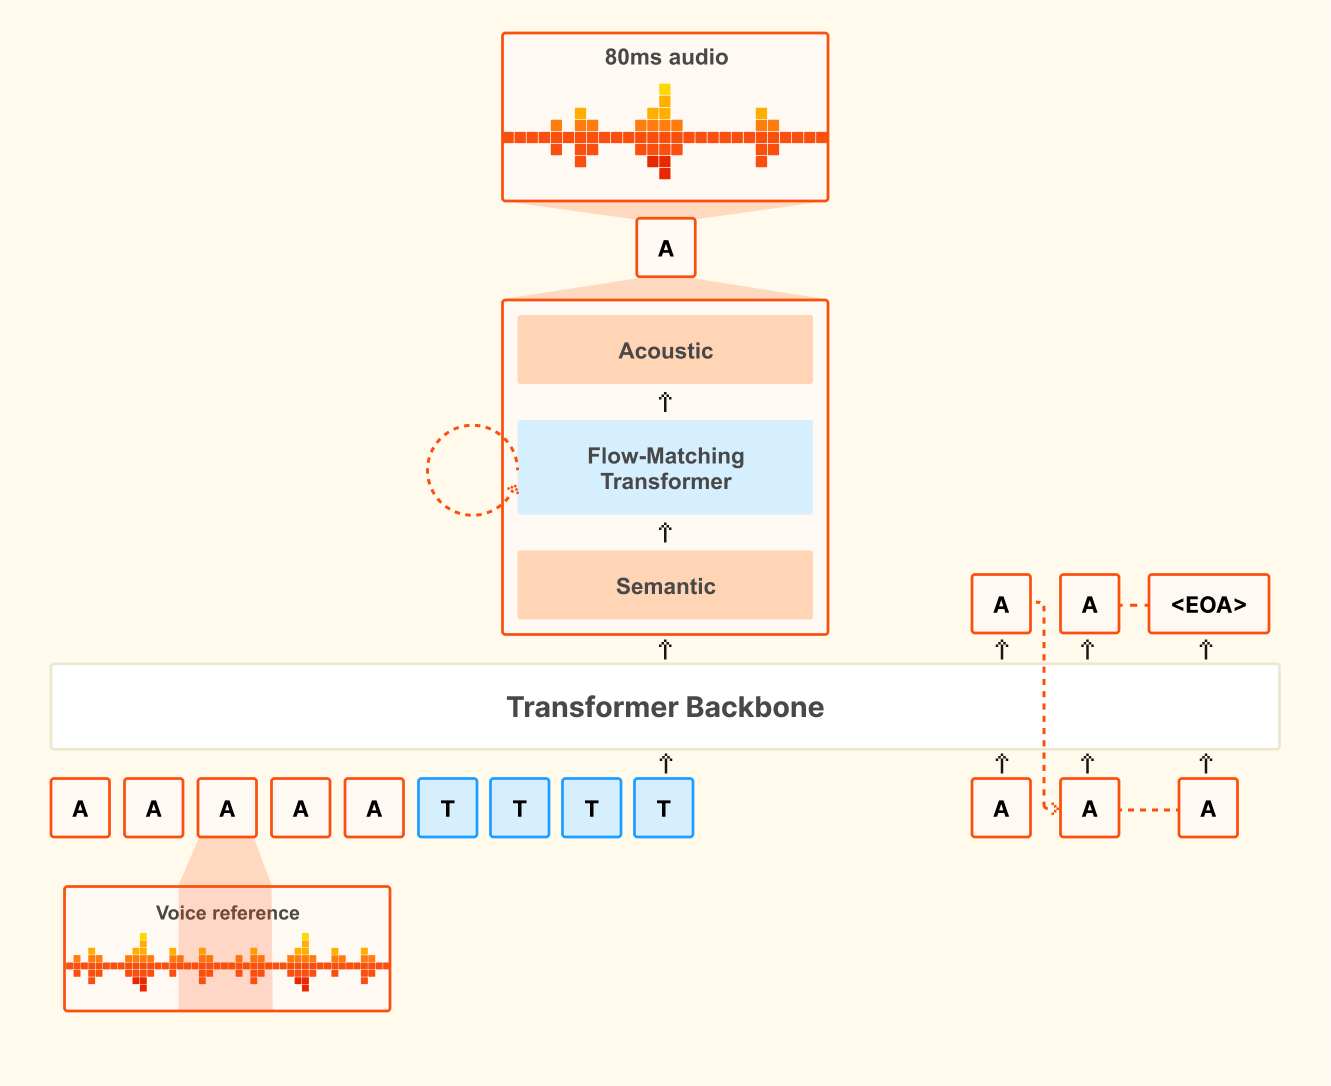
Архитектура состоит из трех компонентов: базового трансформерного декодера на 3,4 миллиарда параметров, акустического трансформера с сопоставлением потоков (flow-matching) на 390 миллионов параметров и нейронного аудиокодека на 300 миллионов параметров, разработанного Mistral собственными силами. Система построена на базе Ministral 3B — той же предобученной основы, которая используется в модели Voxtral Transcribe. Сток охарактеризовал этот выбор как показатель приверженности Mistral культуре эффективности и повторного использования наработок.
На практике время до воспроизведения первого аудиофрагмента (time-to-first-audio) для типичного запроса составляет 90 миллисекунд, а скорость генерации речи примерно в шесть раз превышает реальное время. При квантовании для инференса модели требуется около трех гигабайт оперативной памяти. Сток подтвердил, что она способна работать на любом ноутбуке или смартфоне, функционируя в реальном времени даже на устаревшем оборудовании.
«Это 3B-модель, поэтому она может работать практически на любом ноутбуке или смартфоне», — рассказал Сток изданию VentureBeat. — «Если квантовать ее для инференса, расход составит всего три гигабайта оперативной памяти. И ее можно запускать на суперстарых чипах — она все равно будет работать в реальном времени».
Модель поддерживает девять языков — английский, французский, немецкий, испанский, нидерландский, португальский, итальянский, хинди и арабский — и способна адаптироваться под кастомный голос всего по пяти секундам эталонного аудио. Что еще более примечательно, она демонстрирует межъязыковую адаптацию голоса (zero-shot cross-lingual voice adaptation) без предварительного обучения для этой конкретной задачи.
Сток проиллюстрировал это на личном примере: он может дать модели 10 секунд собственной речи с французским акцентом, ввести текстовый запрос на немецком, и модель сгенерирует немецкую речь его собственным голосом со всеми естественными интонациями и характерным акцентом. Для международных компаний эта функция открывает возможности каскадного перевода речи с сохранением идентичности спикера, что находит очевидное применение в службе поддержки, продажах и внутренних коммуникациях мультинациональных корпораций.
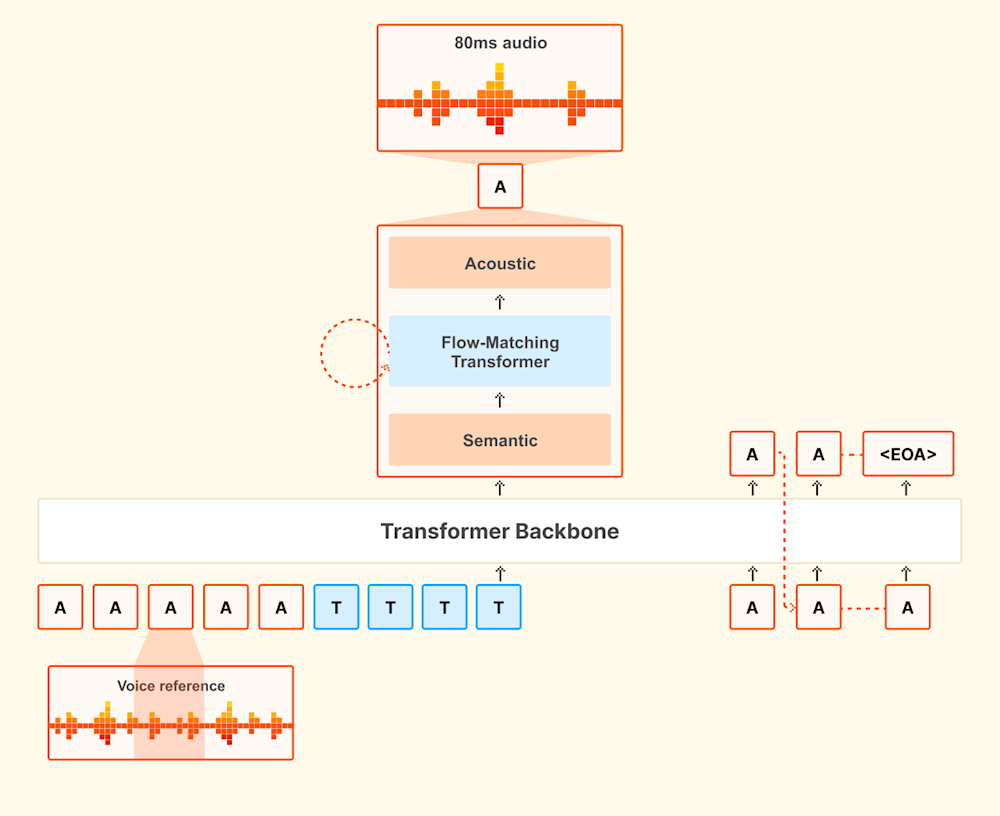
Архитектура Voxtral TTS от Mistral: базовый трансформер принимает текстовые токены и эталонный образец голоса, после чего передает семантические представления через трансформер сопоставления потоков для генерации 80-миллисекундных аудиофреймов. Система работает примерно на трех гигабайтах памяти. (Источник: Mistral AI)
В ходе тестирования с участием людей респонденты отдавали предпочтение Voxtral перед ElevenLabs почти в 70% случаев при кастомизации голоса
Mistral не скрывает, какого именно конкурента она намерена потеснить. В ходе субъективных оценок (human evaluation), проведенных самой компанией, модель Voxtral TTS продемонстрировала 62,8% предпочтений слушателей по сравнению с ElevenLabs Flash v2.5 на флагманских голосах и 69.9% в задачах кастомизации голоса. Mistral также заявляет, что модель не уступает ElevenLabs v3 (премиальному тарифу компании с более высокой задержкой) в эмоциональной выразительности, сохраняя при этом задержку на уровне гораздо более быстрой модели Flash.
Методология оценки включала прямое сравнительное тестирование на всех девяти поддерживаемых языках. Используя по два узнаваемых голоса на их родных диалектах для каждого языка, три эксперта по разметке проводили тесты на естественность, соответствие акценту и акустическое сходство с оригинальным эталоном. По данным Mistral, модель Voxtral TTS увеличила разрыв в качестве с ElevenLabs v2.5 Flash, особенно в сценариях многоязычной кастомизации голоса в режиме zero-shot, что подчеркивает то, что в компании называют «мгновенной кастомизируемостью» модели.
ElevenLabs по-прежнему считается эталоном чистого качества голоса. Ее модель Eleven v3 неоднократно описывалась независимыми рецензентами как золотой стандарт эмоционально нюансированной ИИ-речи. Однако ElevenLabs работает как закрытая платформа с многоуровневыми тарифными планами, которые варьируются от примерно 5 долларов в месяц на базовом уровне до более чем 1300 долларов в месяц для корпоративных тарифов. Веса моделей компания не раскрывает.
Главный тезис Mistral заключается в том, что предприятия не должны выбирать между качеством и контролем, а экономика модели с открытыми весами в масштабе выглядит значительно выгоднее.
«Мы хотим подчеркнуть, что мы также работаем быстрее и дешевле — и мы являемся открытым ПО», — отметил Сток в интервью VentureBeat. — «Когда продукт с открытым исходным кодом стоит недорого, люди охотно внедряют его и строят на его основе свои решения».
Он сформулировал экономический довод терминами, близкими техническим директорам, управляющим бюджетами на ИИ: «ИИ — это преобразующая технология, но у нее есть своя цена. Когда вы хотите масштабировать бизнес и оказывать влияние в рамках крупной компании, эта цена имеет значение. А мы позволяем масштабироваться бесшовно, минимизируя затраты и максимизируя точность».
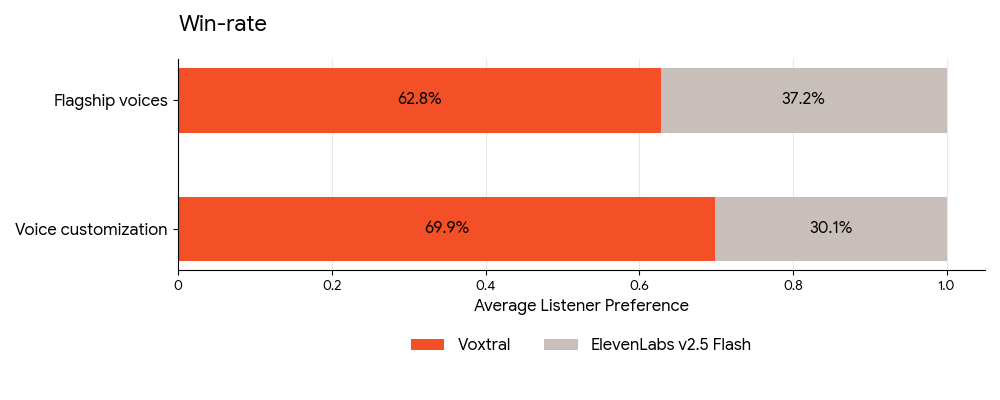
В слепых тест-прослушиваниях, проведенных специалистами Mistral, люди-эксперты отдавали предпочтение Voxtral TTS перед ElevenLabs Flash v2.5 примерно в 63% случаев на флагманских голосах и почти в 70% случаев при решении задач кастомизации голоса. (Источник: Mistral AI)
Почему в Mistral считают, что корпорации захотят владеть своим голосовым ИИ, а не арендовать его
Чтобы понять, почему Mistral выходит на рынок синтеза речи именно сейчас, необходимо оценить более широкую стратегическую архитектуру, которую компания выстраивала на протяжении последнего года. В то время как OpenAI и Anthropic захватили воображение потребителей, компания Mistral тихо и методично сформировала, пожалуй, самую комплексную корпоративную ИИ-платформу в Европе — и все более заметную в глобальном масштабе.
Генеральный директор Артур Менш (Arthur Mensch) заявлял, что в текущем году компания преодолеет отметку в 1 миллиард долларов годового регулярного дохода (ARR), о чем сообщалось в репортаже TechCrunch с запуска платформы Forge. Financial Times писала, что годовой показатель регулярной выручки Mistral подскочил с 20 миллионов до более чем 400 миллионов долларов всего за один год. Этот рост обеспечили более 100 крупных корпоративных клиентов и последовательная концепция: компании должны владеть своей ИИ-инфраструктурой, а не брать ее в аренду.
Voxtral TTS — это последнее выражение данной концепции, перенесенное в самую чувствительную категорию корпоративных данных. Голосовые записи фиксируют не просто слова, но эмоции, личность и намерения. Они несут в себе юридический, регуляторный и репутационный вес, которого текстовые данные зачастую лишены. Для таких отраслей, как финансовые услуги, здравоохранение и госсектор (а это ключевые вертикали для Mistral), отправка голосовых данных в стороннее API сопряжена с рисками, которые многие комплаенс-команды не готовы принимать.
Сток убедительно аргументировал позицию в отношении суверенитета данных. «Поскольку веса моделей открыты, для нас не составляет труда предоставить их предприятиям и помочь им в кастомизации», — сказал он. — «Мы больше не видим эти веса. Мы не видим данные. Мы не видим ничего. И вы полностью контролируете процесс».
Этот посыл находит особую поддержку в Европе, где в течение всего 2026 года усиливалась обеспокоенность технологической зависимостью от американских облачных провайдеров. В настоящее время ЕС получает более 80% цифровых услуг от зарубежных поставщиков, большинство из которых — американские. Mistral позиционирует себя как ответ на эти опасения, выступая единственным европейским разработчиком передового ИИ, обладающим масштабом и техническим потенциалом для создания надежной альтернативы.
Голосовые агенты — это тот корпоративный сценарий использования, который заставляет весь ИИ-стек Mistral работать в полную силу
Voxtral TTS представляет собой финальный элемент конвейера, который Mistral методично собирала воедино. Voxtral Transcribe отвечает за распознавание речи (speech-to-text). Языковые модели Mistral — от Mistral Small до Mistral Large — обеспечивают уровень рассуждений. Forge позволяет предприятиям адаптировать любую из этих моделей на собственных данных. AI Studio предоставляет производственную инфраструктуру для обеспечения прозрачности (observability), управления и развертывания. А Mistral Compute предлагает базовые ресурсы графических процессоров (GPU).
В совокупности эти элементы формируют то, что Сток описал как «полноценный ИИ-стек, полностью контролируемый и настраиваемый» для предприятий. Голосовые агенты — системы искусственного интеллекта, способные выслушать клиента, понять его потребности, обдумать ответ и выдать его в виде естественной речи — это сценарий применения, который объединяет все указанные уровни воедино.
Mistral видит потенциальные применения в самых разных сферах: в поддержке клиентов, где голосовые агенты могут направлять и разрешать запросы голосом, соответствующим стилю бренда; в продажах и маркетинге, где один и тот же голос может работать на разных рынках благодаря кросс-языковой эмуляции; в обеспечении синхронного перевода для трансграничных операций; и даже в интерактивном сторителлинге и разработке игр, где управление эмоциями позволяет контролировать тон и индивидуальность персонажей.
Наибольшее воодушевление у Стока вызывал разговор о том, как Voxtral TTS вписывается в общий тренд агентного ИИ, доминирующий в дискуссиях о корпоративных технологиях в 2026 году. «Мы полностью строим экосистему для мира, в котором аудио становится естественным интерфейсом, в особенности для агентов, которым можно делегировать работу — как продолжениям самих себя», — пояснил он. Он обрисовал сценарий, в котором пользователь начинает планировать отпуск на компьютере, едет на работу и продолжает рабочий процесс на телефоне, просто запросив обновление голосовой командой.
«Чтобы это стало возможным, вам нужна модель, которой можно доверять, суперэффективная и дешевая в запуске модель — иначе вы не будете долго ею пользоваться — и такая модель, которая звучит максимально естественно и которую можно прервать в любой момент», — отметил Сток.
Такое внимание к возможности прерывания (interruptibility) и быстродействию в реальном времени отражает более глубокое понимание специфики голосовых интерфейсов, отличающих их от текстовых. Чат-бот может потратить две-три секунды на ответ без ущерба для пользовательского опыта. Голосовой агент — нет. Время отклика в 90 миллисекунд, достигаемое Voxtral TTS — это не просто контрольный показатель, это порог, разделяющий естественное и роботоподобное голосовое взаимодействие.
Подход Mistral к открытым весам совпадает с общеотраслевым трендом, который поддерживает даже Nvidia
Решение Mistral выпустить Voxtral TTS с открытыми весами согласуется с тенденцией, набирающей обороты во всей индустрии искусственного интеллекта. На конференции Nvidia GTC в начале этого месяца генеральный директор Nvidia Дженсен Хуанг (Jensen Huang) заявил, что «противопоставление проприетарного и открытого подходов не имеет смысла — они существуют в связке „проприетарное и открытое“». Nvidia объявила о создании коалиции Nemotron (Nemotron Coalition) — первой в своем роде коллаборации разработчиков моделей, нацеленной на продвижение открытых базовых моделей передового уровня, причем Mistral вошла в число ее основателей. Первым проектом в рамках этой коалиции станет базовая модель, совместно разработанная Mistral AI и Nvidia.
Для Mistral открытые веса преследуют двойную коммерческую цель. Они стимулируют внедрение — разработчики и компании могут экспериментировать без каких-либо барьеров и обязательств, — в то время как сама компания монетизирует продукты за счет платформенных сервисов, предложений по кастомизации и управляемой инфраструктуры. Модель доступна для тестирования в Mistral Studio и через API компании, но стратегический расчет состоит в том, чтобы закрепиться в корпоративных голосовых конвейерах в качестве собственного актива компании, а не услуги с повременной оплатой.
Это зеркально отражает стратегию, которая принесла успех языковым моделям Mistral. Как заявил Менш в интервью CNBC в феврале, «ИИ позволяет нам разрабатывать ПО с невероятной скоростью», спрогнозировав, что «более половины того, что ИТ-сектор покупает в виде SaaS, со временем перейдет в сферу ИИ». Он описал происходящую в корпоративных технологиях «реплатформензацию», в рамках которой компании стремятся заменить устаревшие программные системы ИИ-нативными альтернативами. Корпоративная голосовая модель с открытыми весами, которую компании могут настраивать и развертывать на собственных условиях, органично вписывается в этот сюжет.
Mistral сигнализирует о том, что ее дальнейшее развитие связано со сквозными аудио-ИИ системами
На вопрос о том, что появится после Voxtral TTS, Сток обозначил два направления. Первое — расширение языковой поддержки и охвата диалектов с особым вниманием к культурным нюансам. «Говорить по-французски в Париже и говорить по-французски в Канаде, в Монреале — это не одно и то же», — отметил он. — «Мы хотим уважать обе культуры и добиваться того, чтобы наши модели работали в обоих контекстах со всеми культурными особенностями».
Второе направление более амбициозно: полноценная сквозная (end-to-end) аудиомодель, способная не просто генерировать речь из текста, но и понимать весь спектр человеческой голосовой коммуникации.
«Произносимыми словами мы передаем определенный смысл», — говорит Сток. — «Однако с помощью интонации, ритма и манеры речи мы передаем гораздо больше. Когда люди говорят об аудиосистемах end-to-end, они имеют в виду именно это: модель способна уловить, что вы, например, спешите, и выдать самый быстрый ответ. Модель поймет, что вы сегодня радостны, и отпустит шутку. Она максимально адаптирована под вас, и именно туда мы хотим двигаться».
Это видение — ИИ, который говорит естественным языком, слушает с учетом нюансов, реагирует с эмоциональным интеллектом и работает на модели, достаточно компактной, чтобы поместиться в кармане, — представляет собой передовой рубеж, к которому стремятся все ведущие ИИ-лаборатории. На данный момент Voxtral TTS дает Mistral основу для дальнейшего роста, а предприятиям — вопрос, на который им еще не приходилось отвечать: если вы можете полностью владеть своим стеком голосового ИИ с меньшими затратами и при конкурентном качестве, зачем продолжать арендовать чужой?




