


Google не платит «налог на Nvidia». Её новые TPU объясняют почему.


Каждая передовая лаборатория искусственного интеллекта сегодня занимается нормированием двух ресурсов: электроэнергии и вычислительной мощности. Большинство из них покупают вычислительные мощности для обучения моделей у одного и того же поставщика, по высоким ценам и с высокой маржой, которые сделали Nvidia одной из самых дорогих компаний в мире. Google этого не делает.
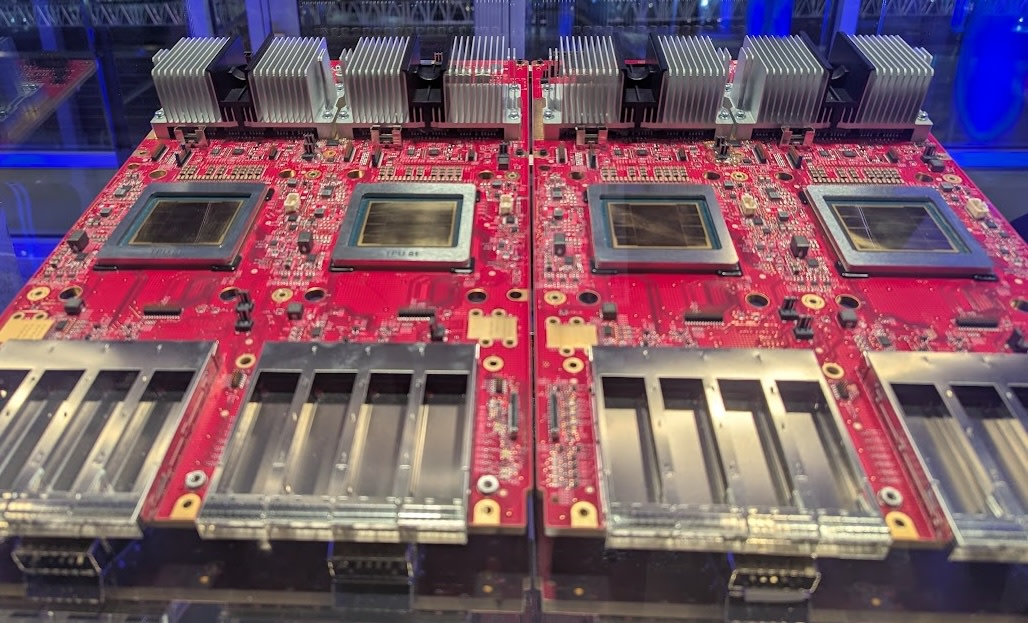
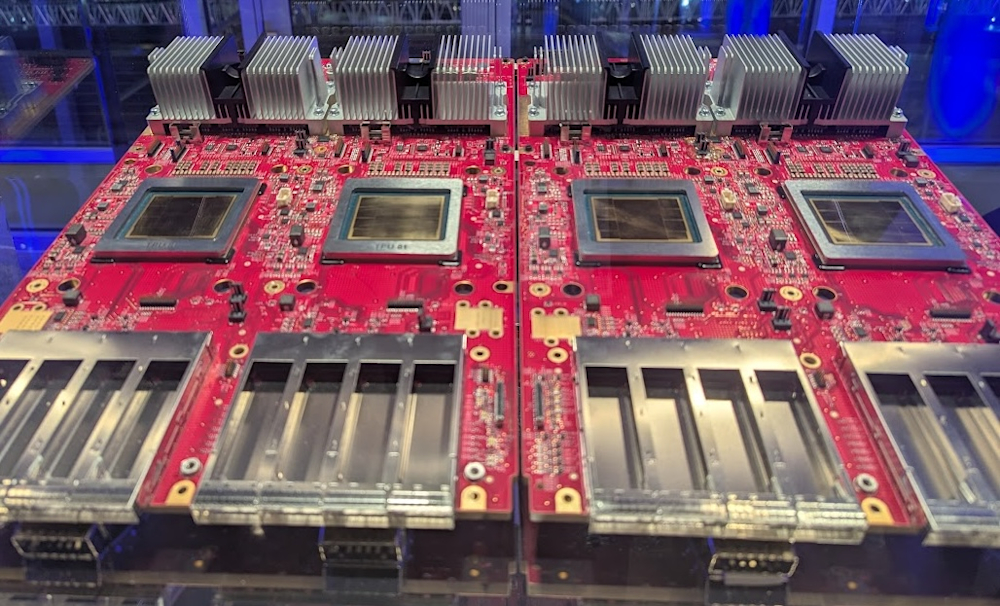
Во вторник вечером на закрытом мероприятии на арене F1 Plaza в Лас-Вегасе компания Google представила тензорные процессоры (TPU) восьмого поколения. Суть предложения: два специализированных чипа, которые поступят в продажу в конце этого года, причем каждый из них разработан под конкретную задачу в рамках современных рабочих нагрузок ИИ. TPU 8t ориентирован на обучение передовых моделей, а TPU 8i предназначен для мира агентского инференса и реалтайм-сэмплинга с низкими задержками, где критически важен объем памяти.
Амин Вахдат (Amin Vahdat), старший вице-президент и главный технолог Google по искусственному интеллекту и инфраструктуре (на фото слева вверху), потратил отведенное ему на сцене время на мысль, которая гораздо важнее для корпоративных покупателей, чем любые отдельные технические характеристики: Google проектирует каждый уровень своего стека ИИ от и до, и эта вертикальная интеграция начинает проявляться в экономике затрат на один токен, с которой, по заявлению Google, конкуренты не могут сравниться.
«Одного чипа в год было недостаточно»: подробности стратегии Google 2024 года по переходу на двухчиповую линейку
Самая интересная история создания v8t и v8i кроется в том, когда именно было принято решение разделить дорожную карту. Это произошло в 2024 году, по словам Вахдата, — за год до того, как индустрия в целом переключилась на модели рассуждений, агенты и обучение с подкреплением в качестве доминирующих передовых рабочих нагрузок.
В то время это было противоречащее общему мнению решение. «Два года назад мы поняли, что одного чипа в год будет недостаточно», — сказал Вахдат во время беседы у камина. «Это наша первая попытка выпустить сразу два сверхмощных специализированных чипа».
Для корпоративных заказчиков это имеет вполне конкретные последствия. Клиенты, выполняющие дообучение (fine-tuning) или масштабное обучение в Google Cloud, а также клиенты, развертывающие рабочие агенты на Vertex AI, арендовали одни и те же ускорители, мирясь с неэффективностью. V8 — это первое поколение, где само «железо» рассматривает эти задачи как совершенно разные проблемы и решает их с помощью двух наборов чипов.
TPU 8t: инфраструктура обучения, масштабируемая до миллиона чипов
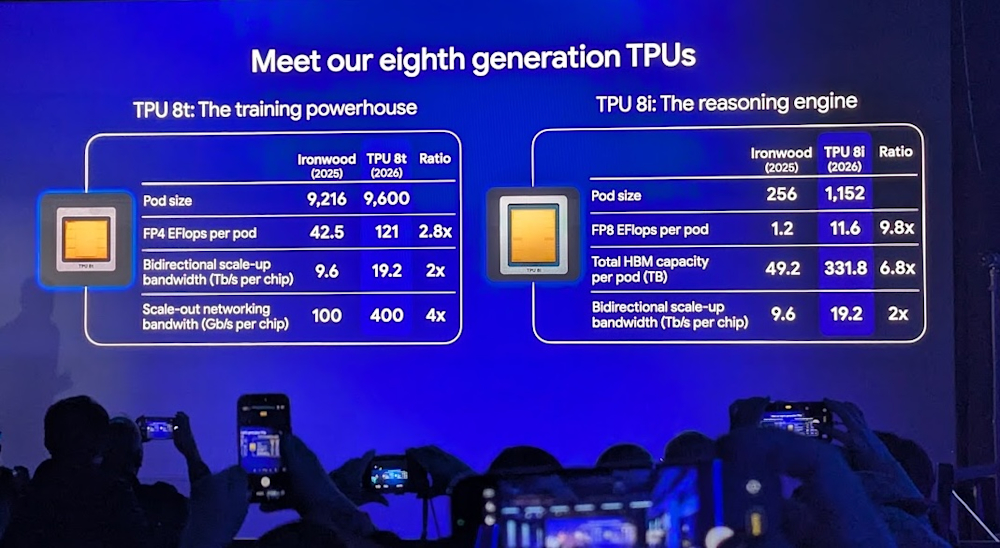
На бумаге TPU 8t — это серьезный шаг вперед. По данным Google, 8t обеспечивает в 2,8 раза большую производительность FP4 EFlops на подсистему (подина) (121 против 42,5) по сравнению с Ironwood — TPU седьмого поколения, выпущенным в 2025 году, — удваивает двунаправленную пропускную способность масштабирования до 19,2 Тбит/с на чип и увеличивает сетевую пропускную способность для горизонтального масштабирования в четыре раза до 400 Гбит/с на чип. Размер пода незначительно увеличивается с 9 216 до 9 600 чипов, объединенных с помощью фирменной трехмерной топологии 8Torus от Google.
Показатель, который имеет наибольшее значение для IT-руководителей, оценивающих площадки для обучения моделей пограничного масштаба: кластеры 8t (Superpods) могут масштабироваться более чем до 1 миллиона чипов TPU в рамках одной задачи обучения благодаря новому межсоединению, которое Google называет сеткой Virgo.
В 8t также представлена технология TPU Direct Storage, которая перемещает данные из управляемого хранилища Google напрямую в память HBM, минуя традиционные промежуточные этапы через процессор. Для длительных циклов обучения, где главным фактором затрат является время «настенных часов», сокращение этого пути данных уменьшает количество под-часов, необходимых для завершения каждой эпохи.
Источник: Сэм Виттевеен (Sam Witteveen)
TPU 8i и Boardfly: переработка сети под нужды агентов
Если 8t — это эволюционный шаг, то TPU 8i представляет собой гораздо более интересный с архитектурной точки зрения чип. Именно здесь перспективы для IT-покупателей становятся наиболее привлекательными.
Показатели роста характеристик из года в год, по выражению Вахдата, «потрясают воображение». По данным Google, чип 8i обеспечивает в 9,8 раза большую производительность FP8 EFlops на подсистему (11,6 против 1,2), емкость HBM в 6,8 раза больше (331,8 ТБ против 49,2 ТБ), а размер подсистемы увеличивается в 4,5 раза — с 256 до 1 152 чипов.
Движущей силой таких показателей стал пересмотр самой сетевой архитектуры. Вахдат объяснил это напрямую: стандартный способ соединения чипов от Google отдавал приоритет пропускной способности, а не задержкам — это хорошо для передачи больших объемов данных, но не подходит для минимизации времени отклика. Такой профиль подходит для обучения. Для агентов — нет. В партнерстве с Google DeepMind команда разработчиков TPU создала топологию, которую Google называет Boardfly, специально для уменьшения диаметра сети — сокращения количества скачков (hops) между любыми двумя чипами в поде. В сочетании с механизмом ускорения коллективных операций (Collective Acceleration Engine) и большими объемами SRAM прямо на кристалле, 8i обеспечивает 5-кратное улучшение задержки для реалтайм-сэмплинга языковых моделей и обучения с подкреплением.
Рывковый барьер вертикальной интеграции: почему Google не платит «налог Nvidia»
Подтекстом всей презентации Вахдата была шестиуровневая диаграмма, которую Google называет своим стеком искусственного интеллекта: энергия в основе, затем земля под дата-центры и корпуса, аппаратное обеспечение инфраструктуры ИИ, программное обеспечение инфраструктуры ИИ, модели (Gemini 3) и сервисы на вершине. Вахдат отметил, что проектирование каждого слоя изолированно заставляет ориентироваться на наименьший общий знаменатель для каждого уровня. Google проектирует их вместе.
Именно здесь кристаллизуется конкурентное преимущество для IT-покупателей и аналитиков. OpenAI, Anthropic, xAI и Meta сильно зависят от кремния Nvidia для обучения своих передовых моделей. Каждый купленный ими GPU H200 и Blackwell несет в себе валовую маржу дата-центров Nvidia — тот самый негласный «налог Nvidia», который отраслевые аналитики уже два года подряд называют структурным ценовым недостатком для любого, кто арендует мощности, а не проектирует их самостоятельно. Google платит за производство, корпусирование и проектирование своих TPU. Эту маржу она не платит.
Источник: Сэм Виттевеен (Sam Witteveen)
Что v8 означает для гонки вычислительных мощностей: новый чек-лист оценки для IT-лидеров
Для групп по закупкам и инфраструктуре TPUv8 переосмысляет процесс оценки облачных решений на 2026–2027 годы в вполне конкретных аспектах.
Командам, обучающим крупные проприетарные модели, следует обратить внимание на окна доступности 8t, доступ к сети Virgo и соглашения об уровне обслуживания (SLA) по полезной пропускной способности (goodput), а не только на заявленные показатели EFlops. Командам, обслуживающим агентов или рабочие нагрузки рассуждений, следует оценить доступность 8i на Vertex AI, независимые тесты задержки по мере их появления и то, насколько размер HBM на подсистему соответствует их контекстным окнам. Команды, потребляющие Gemini через Gemini Enterprise, получат прирост производительности от 8i и могут рассчитывать на то, что верхний предел того, что они могут развернуть в продакшене, существенно вырастет в течение 2026 года.
Однако существуют и реальные оговорки. Широкая доступность ожидается «позже в 2026 году». Версия v8 — это сигнал о планах развития, а не повод принимать решение о закупках прямо сейчас. Бенчмарки Google предоставлены самой компанией; несомненно, независимые данные появятся от первых облачных клиентов и сторонних оценщиков в течение следующих двух кварталов. И переносимость между экосистемами JAX/XLA и CUDA/PyTorch остается издержками трения, о которых стоит подумать при заключении любых долгосрочных обязательств.
Заглядывая в будущее, Вахдат сделал два предсказания, которые стоит отметить. Во-первых, процессоры общего назначения ждет возрождение внутри систем ИИ — не в качестве ускорителей, а в качестве оркестровых вычислительных средств для изолированных сред (песочниц) агентов, виртуальных машин и выполнения инструментов. Во-вторых, формулируя это прямо как прогноз для всей отрасли, а не как анонс дорожной карты Google, специализация будет только набирать обороты. Поскольку производительность процессоров общего назначения растет всего на несколько процентов в год, критически важные рабочие нагрузки потребуют специализированного кремния. «Два чипа могут превратиться в большее число», — сказал Вахдат, не уточняя, будет ли под «большим» подразумеваться будущие варианты TPU или другие классы специализированных ускорителей.
Гонка передовых вычислений раньше сводилась к вопросу о том, кто сможет купить больше всего H100. Теперь это вопрос о том, кто контролирует стек. На сегодняшний день в короткий список компаний, которые действительно это делают, входят всего две: Google и Nvidia.




