


Уровень сбоев моделей ИИ недооценен в 2,25 раза
Источник: VentureBeat · Ben Dickson


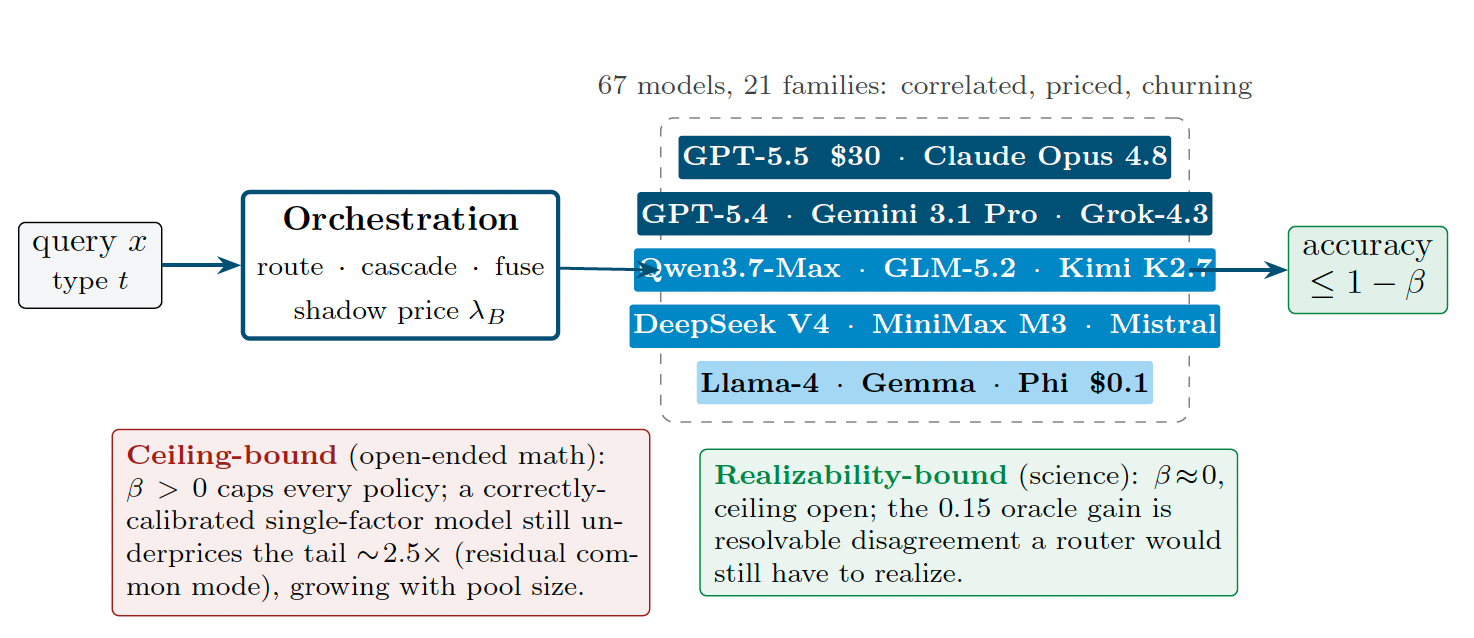
Команда, распределяющая запросы между специализированной моделью по написанию кода, моделью логических рассуждений и универсальной моделью, исходит из того, что каждая из них покроет «слепые зоны» остальных. Новое исследование, оценивающее 67 передовых моделей от 21 провайдера, показывает, что это предположение математически ошибочно, и у этой ошибки есть название: предел совместных сбоев (co-failure ceiling).
Это предположение работает следующим образом: до тех пор, пока две модели обычно не дают сбой на одних и тех же промптах, их объединение должно создать защитную сетку от ошибок.
Реальным ограничением при оркестрации является не то, как часто модели расходятся во мнениях, а процент промптов, на которые каждая модель в пуле дает неверный ответ одновременно. Игнорируя предел совместных сбоев, компании создают сложную и дорогостоящую инфраструктуру маршрутизации в погоне за приростом производительности, которого не существует. К счастью, разработчики могут использовать ту же математику для создания бесплатного теста, который точно определяет, когда оркестрация нескольких моделей действительно окупится.
Скрытые издержки стратегии многомодельного подхода
Для оркестрации нескольких языковых моделей разработчики обычно полагаются на три архитектуры. Маршрутизаторы моделей действуют как регулировщики движения, отправляя сложные запросы дорогим моделям, а простые — более дешевым. Каскады сначала отправляют каждый промпт дешевой модели, передавая его модели премиум-класса только в том случае, если исходная система сигнализирует о низкой степени уверенности. Наконец, такие подходы, как Mixture-of-Agents (MoA), объединяют несколько моделей, задавая им один и тот же вопрос и генерируя синтезированный ответ на основе их совместных результатов.
Эти архитектуры привносят в затраты на инференс «теневую цену». Каждый раз, когда команда разработчиков внедряет маршрутизатор или каскад, она платит премиальную цену в виде дополнительной задержки системы, сложного обслуживания инфраструктуры и возросших рисков управления у нескольких API-провайдеров.
Чтобы оправдать эти эксплуатационные расходы, инженеры полагаются на «попарную корреляцию ошибок» при выборе пула моделей. Представьте себе разработчика, у которого есть Модель А, отлично пишущая на Python, но не справляющаяся с SQL, и Модель Б, отлично пишущая на SQL, но не справляющаяся с Python. Поскольку они дают сбои на разных типах промптов, их попарная корреляция ошибок низкая. Разработчик предполагает, что, поместив перед ними уровень маршрутизации, он создал составную систему, которая редко ошибается в кодинге.
Согласно исследованию, объединение разнообразных моделей на основе низкой корреляции может фактически ухудшить производительность, если модели не обладают одинаковыми возможностями: при голосовании среди разнообразных, но неравных моделей более слабые часто объединяются и побеждают самую умную.
Джозеф Чен (Josef Chen), автор статьи, рассказал VentureBeat, что в ходе их экспериментов «Наивное голосование большинства среди неравных моделей имело отрицательный средний прирост (минус 10 пунктов на нашей сложной смеси): разнообразные, но более слабые участники перевешивают сильного». Практический совет для разработчиков заключается в том, чтобы «объединять только модели в рамках одного диапазона качества». Если вы не можете подобрать равные по качеству модели, возьмите базовый вариант с одной моделью и потратьте свой бюджет на лучшую из доступных моделей.
В статье отмечается один положительный момент для такого подхода в отношении архитектур MoA. При создании ансамблей команды часто используют «Self-MoA», когда они делают запросы к одной и той же модели премиум-класса несколько раз для генерации синтезированного ответа. Исследователи обнаружили, что при равном качестве создание разнообразного ансамбля моделей с низкой попарной корреляцией превосходит настройку Self-MoA с высокой корреляцией.
Однако, когда команды используют ту же метрику попарной корреляции для прогнозирования абсолютной точности всей своей системы, математика перестает работать.
«Таким образом, команды заранее платят за накладные расходы на оркестрацию (задержку, сложность, операции с несколькими провайдерами) в расчете на то, что дивиденды от разнообразия появятся позже, — сказал Чен. — Обычно этого не происходит, потому что лучшие сегодняшние модели согласны друг с другом и, что еще хуже, они дают сбой на одних и тех же запросах… промпт просто несет в себе мало информации о том, какая именно модель окажется права, когда передовые системы расходятся во мнениях».
Почему математика дает сбой: предел совместных сбоев
Суть исследования сосредоточена на метрике под названием «уровень совместных сбоев» (co-failure rate) — официальном названии сценария «все ошиблись», описанного выше. Никакой маршрутизатор, система голосования или каскад никогда не смогут достичь точности выше предела, который она накладывает.
Пул моделей для кодирования, логики и общих задач демонстрирует низкую попарную корреляцию на рутинных промптах — они редко дают сбой одновременно. Но предел совместных сбоев представляет собой неочевидный, крайне сложный пограничный случай, который выходит за рамки возможностей текущих архитектур ИИ. Если промпт настолько сложен, что все три модели галлюцинируют или дают сбой, то не имеет значения, насколько интеллектуально маршрутизатор распределяет задачу. Весь пул «вылетает» одновременно.
Исследователи протестировали свой пул из 67 моделей, в который вошли GPT-5.5, Claude Opus 4.8 и Gemini 3.1 Pro, на открытом математическом бенчмарке MATH-500. На основе стандартной попарной корреляции статистические модели прогнозировали, что весь пул будет одновременно ошибаться лишь на 2,3% вопросов. На практике уровень совместных сбоев составил 5,2%.
Исследование 67 ведущих LLM в многомодельных средах (источник: arXiv)
Стандартные метрики корреляции занизили уровень отказов примерно в 2,25 раза. Виновата не только независимая сложность, но и общая точка отказа.
«Драйвером является то, что мы называем атомом общего режима: срез запросов, на котором весь рынок терпит неудачу одновременно, чего не может увидеть ни одна попарная статистика, — сказал Чен. — Добавление 20-й модели в ваш пул не обеспечивает покрытие “хвоста”. Хвост является общим».
Исследователи также обнаружили, что формат задачи напрямую провоцирует совместный сбой. Когда они взяли вопросы по естественным наукам университетского уровня из бенчмарка GPQA и изменили их с формата с множественным выбором на формат с открытым ответом, область совместных ошибок («хвост») расширилась до 12,7%.
Тем не менее, разработчики могут обойти этот предел инженерными методами. «Инженерный вывод неприятен: многомодельные установки дают наименьшую пользу именно там, где команды хотят ее больше всего — при генерации с открытым концом, — сказал Чен. — Везде, где вы можете преобразовать генерацию в верификацию или ограниченный выбор (структурированные выводы, проверяемые ответы, тесты выполнения), вы снова открываете этот предел».
В конечном счете исследователи обнаружили, что этот предел ограничивает приложения ИИ двумя различными способами в зависимости от предметной области:
-
Среды, ограниченные пределом (например, открытая математика): Уровень совместных сбоев высок. Задача слишком сложна, и все модели терпят неудачу одновременно. Никакая маршрутизация не способна обойти нехватку базовых возможностей.
-
Среды, ограниченные реализуемостью (например, наука университетского уровня): Уровень совместных сбоев близок к нулю, что означает, что по крайней мере одна модель в пуле обычно знает ответ. Тем не менее, модели расходятся во мнениях настолько тонко, что уровень маршрутизации не может надежно выбрать правильный ответ без всеведущего оракула.
Бесплатная проверка перед деплоем ($0)
Прежде чем тратить инженерные часы на создание маршрутизатора, команды могут бесплатно рассчитать свой абсолютный предел производительности с помощью математической формулы, называемой интервалом Клоппера — Пирсона.
Интервал Клоппера — Пирсона работает как калькулятор худшего сценария. Если вы подбросите монету десять раз и получите восемь орлов, вы не сможете гарантировать, что монета будет падать орлом вверх 80% времени вечно. Этот метод берет небольшую выборку тестовых вопросов и выдает математически гарантированный предел.
Применительно к языковым моделям: предположим, команда тестирует пул из пяти агентов на 50 выборочных запросах и обнаруживает, что все они ошибаются одновременно всего на двух вопросах. Разработчик может предположить, что его мультиагентная система достигнет 96% точности в продакшене. Формула Клоппера — Пирсона корректирует этот оптимизм. Она анализирует небольшой размер выборки и дает математическую гарантию того, что истинный уровень совместных сбоев на самом деле может достигать 12%.
Чтобы использовать это на практике, предприятиям необходимо создать отложенный набор данных (held-out dataset). Финтех-компания, например, может взять 200 сложных обращений в службу поддержки клиентов за предыдущий квартал и попросить человеческих агентов написать идеальные решения, которые будут служить эталоном. Хотя это звучит как тяжелый ручной труд, зрелые инженерные команды могут полностью автоматизировать расчет предела.
«Интеграция тривиальна: это задача подсчета по логам оценки, которые команды уже производят, — отмечает Чен, — поэтому она запускается на том же этапе непрерывной интеграции (CI), что и комплект тестов, и перезапускается всякий раз, когда меняется пул моделей или рабочая нагрузка».
Затем инженерная команда запускает свои кандидатные модели для этих 200 тикетов один раз и записывает результаты. Когда им требуется оценить конфигурации с несколькими моделями, они могут использовать показатель совместных сбоев для прогнозирования максимальной точности, которую они могут получить от системы, без запуска дополнительных запросов.
Один из важных выводов исследования заключается в том, что в задачах, где ответы можно однозначно проверить, комбинация моделей редко превосходит использование одной лучшей модели на рынке, если только команда не обладает исключительно сильным сигналом маршрутизации на уровне запросов.
В корпоративной среде задача с однозначной проверкой имеет объективный ответ с нулевой толерантностью к ошибкам. Сюда относится генерация SQL-запроса, который должен выполняться без ошибок, извлечение конкретной суммы счета из 50-страничного PDF-файла или форматирование полезной нагрузки JSON, которая идеально соответствует строгой схеме. Для таких задач предприятиям, как правило, лучше заплатить больше за самую умную передовую модель, чем связывать воедино три более дешевые модели в надежде, что маршрутизатор выберет правильный результат. В исследовании не проверялись субъективные задачи без оценок, такие как составление маркетинговых текстов — авторы отмечают, сохраняются ли эти выводы за пределами их верифицируемых бенчмарков, остается открытым вопросом.
Поскольку эта математическая проверка бесплатна, корпоративные команды могут отслеживать собственные показатели совместных сбоев по мере появления новых моделей.
«Измерение ничего не стоит, поэтому любая команда может отслеживать собственный уровень совместных сбоев для разных поколений моделей и наблюдать, сокращается ли “хвост”, — говорит Чен. В конечном счете, „рычаг, которым владеют покупатели, — это гетерогенность режимов сбоев и ротация рынка, а не количество моделей“.




