


Инференс ИИ смещает узкое место в сторону контекста
Источник: VentureBeat · VB Staff


При поддержке Solidigm
Поскольку рабочие нагрузки инференса эволюционируют от отдельных сеансов типа «вопрос-ответ» до постоянных многошаговых систем агентов, доступность графических процессоров (GPU) перестала быть главным узким местом в сфере ИК (искусственного интеллекта). По словам Джеффа Хартхорна (Jeff Harthorn), ведущего специалиста по прикладным исследованиям в области ИИ в компании Solidigm, это узкое место сместилось с вычислений на контекст.
«Вопрос о том, почему управление контекстом стало главным узким местом — более серьезным, чем доступность GPU или эффективность вычислений, — это главный вопрос 2026 года», — говорит Хартхорн. — GPU стали значительно дешевле в расчете на один флопс. Архитектура моделей и движки обслуживающие инференс стали намного эффективнее. Но то, что выросло быстрее их обоих, — это контекст. Персистентное состояние, которое должно сохраняться между сеансами, растет даже быстрее, чем сам контекст».
Это происходит на фоне резкого увеличения контекстных окон, из-за чего отдельные входные данные становятся намного больше, чем раньше. Агентные системы ИИ связывают воедино десятки или сотни вызовов моделей, каждый из которых генерирует состояние, подлежащее отслеживанию, а предприятия требуют сохранения состояния инференса между сеансами для аудита, управления и повторного использования. Эти тенденции накладываются друг на друга, подталкивая объемы контекста за пределы возможностей любого существующего уровня памяти.
«Все эти три вещи происходят одновременно, и все они ускоряют рост контекстных данных и контекстной памяти до колоссальных масштабов гораздо быстрее, чем мы привыкли видеть», — добавляет Эйс Страйкер (Ace Stryker), директор по маркетингу ИИ и экосистем в Solidigm.
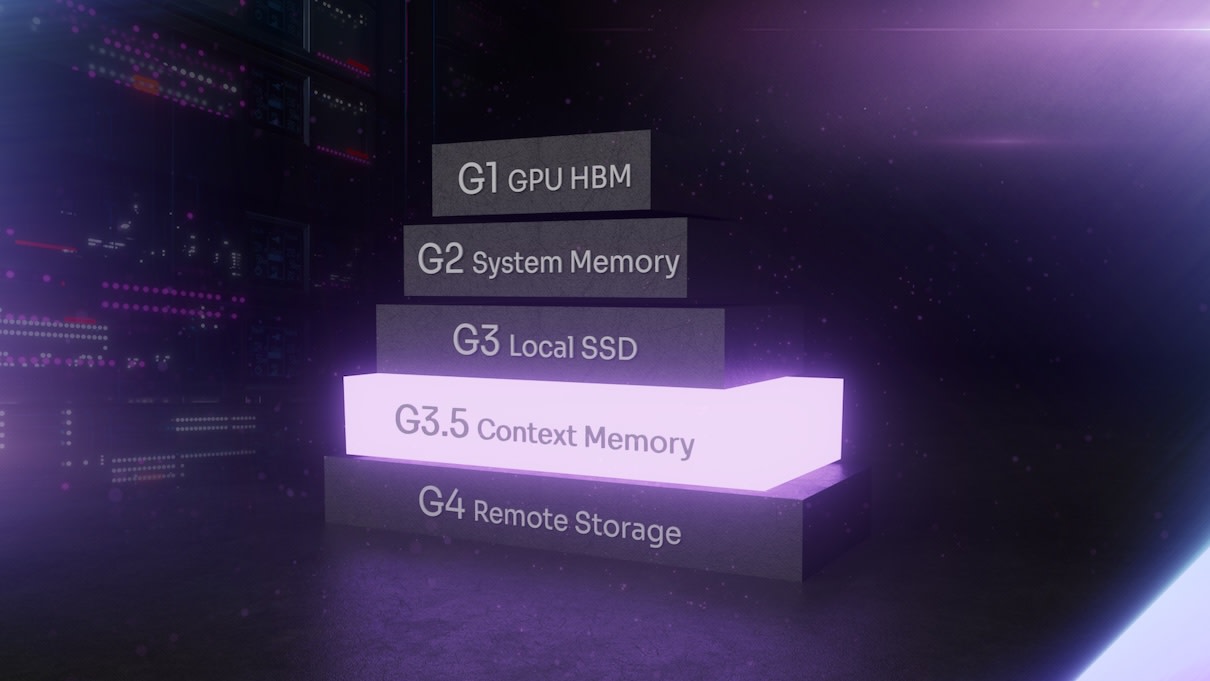
Решением становится специализированный уровень контекста, возникающий между памятью GPU и крупными сетевыми хранилищами: уровень высокопроизводительной и высокоплотной флеш-памяти, созданный специально для хранения и обслуживания кэша ключей-значений (KV-кэш) — данных инференса, позволяющих моделям сохранять и повторно использовать контекст, а также данных извлечения со скоростью инференса. Компания Nvidia официально закрепила эту архитектуру под термином CMX. Производители накопителей, включая Solidigm, создают SSD-продукты, оптимизированные под эту рабочую нагрузку.
«Хранение данных не было первым, о чем люди думали при планировании развертывания своей корпоративной инфраструктуры, — говорит Страйкер. — Во многом это были относительно небольшие расходы по сравнению с вычислениями, и это был биржевой товар. Вы просто искали наименьшую цену за гигабайт и считали дело сделанным. Но теперь, если ваше хранилище не на высоте, страдает окупаемость инвестиций (ROI), и это напрямую бьет по вашей итоговой прибыли».
Почему для инференса ИИ требуется иная архитектура хранения данных, чем для обучения
Архитектура хранения данных, на которую сегодня опираются системы ИИ, во многом досталась им по наследству от рабочих процессов обучения. Процесс обучения носит последовательный и ориентированный на запись характер, при этом данные перемещаются большими блоками в крупносерийное объектное хранилище и обратно. Уровневая структура с высокопропускной памятью на GPU, быстрым NVMe на сервере и массовым хранилищем по сети вполне успешно справляется с этой задачей.
Однако инференс — это совсем другое дело. Его профиль операций ввода-вывода (I/O) мелкозернист, чувствителен к задержкам и все больше зависит от состояний. Данные KV-кэша и извлечения имеют разные шаблоны доступа, но оба типа данных необходимо обслуживать быстро и повторно использовать при взаимодействиях. Они не помещаются ни в высокопропускную память GPU, которая стоит дорого и имеет физические ограничения, ни в традиционные массовые хранилища, которые никогда не проектировались под активные рабочие нагрузки инференса.
«Архитектурный пробел, который кажется мне интересным прямо сейчас, находится не на вершине стека и не внизу, а прямо в середине, — говорит Хартхорн. — От многого из того, что находится ниже GPU HBM, требуют того, для чего оно изначально не предназначалось, и именно здесь сегодня ведется самая интересная системная работа».
Одним из самых заметных симптомов этого пробела является ревычисление (recomputation). На этапе префилла (предварительного заполнения) при инференсе обрабатывается весь контекст, относящийся к данному сеансу, до того, как может начаться генерация токенов. Когда состояние KV-кэша недоступно на быстром и доступном уровне, система пересчитывает его, сжигая циклы GPU, которые не приносят никакой новой ценности.
«Значительная доля циклов GPU в итоге уходит на повторный префилл, — объясняет Хартхорн. — Все эти вычисления контекста — это потенциально вычислительные ресурсы, которые тратятся на воспроизведение состояния, а не на выполнение новой работы. Если взглянуть на проблему с этой точки зрения, то загрузка GPU начинает частично выглядеть как проблема с хранением данных».
Это переосмысление стимулирует возобновление интереса к метрике, заимствованной из сетевых технологий: goodput (эффективная пропускная способность) — то есть полезные токены на доллар, а не «сырые» токены на доллар.
Уровень контекстной памяти ИИ и принцип его работы
Решение индустрии принимает структурную форму. Между памятью GPU и традиционным сетевым хранилищем формируется новый уровень, созданный специально для хранения и обработки контекста инференса. Это слой, отдельный от накопителей внутри серверов GPU (G3) и серверов хранения данных по сети (G4), спроектированный для максимально быстрого возврата контекстных данных ускорителям.
«Если вы строите центр обработки данных, начиная со второй половины этого года или с начала следующего, вы не можете думать о том, что хранилище данных находится только в двух местах, — говорит Страйкер. — Хранилище должно находиться как минимум в трех местах для поддержки уровня контекстной памяти, и это, судя по всему, станет постоянным элементом инфраструктуры будущего».
Это аналогично появлению объектных хранилищ как отдельной категории, которой не существовало до тех пор, пока в ней не возникла потребность у достаточного количества рабочих нагрузок. А когда она появилась, у нее развились свои собственные примитивы, соглашения об уровне обслуживания (SLA), модели затрат и экосистема поставщиков.
«Похоже, уровень контекста находится на схожей траектории развития, — говорит Хартхорн. — Это объемное давление приводит к формированию категории независимо от планов развития какого-то одного вендора».
Для лидеров инфраструктуры это означает активное планирование нового уровня вместо того, чтобы относиться к нему как к чему-то опциональному. Развертывание дополнительной NAND-памяти на этом уровне снижает зависимость от DRAM, которая на порядки дороже в расчете на гигабайт и ограничена как по доступности, так и по тепловому запасу.
«С точки зрения эффективности инвестиций, вы тратите меньше наличных средств, если полагаетесь на уровень SSD так, как Nvidia теперь рекомендует и предписывает для многих вариантов использования», — добавляет Страйкер.
Что должна обеспечить флеш-память для поддержки инференса ИИ
Полноценное участие в стеке инференса предъявляет новые требования к технологии твердотельных накопителей (SSD). «Хвостовая» задержка (tail latency), то есть худший показатель производительности накопителя, должна быть предсказуемой, а не просто быстрой в среднем. Система оркестрации, распределяющая ресурсы GPU на основе ожидаемого времени отклика хранилища, не может терпеть неожиданные задержки в несколько секунд. Постоянная, стабильная производительность здесь важнее, чем пиковая пропускная способность.
Помимо задержек, критически важной проблемой становится плотность, особенно в условиях гипермасштабирования. В дата-центрах, где ограничивающим фактором является не стоимость, а энергопотребление, рабочей метрикой становятся ватты на петабайт. Плавающая затворная NAND (floating gate NAND), подход к производству, лежащий в основе продуктов Solidigm, хорошо подходит для таких расчетов. Учитывая жесткие ограничения по задержкам для активных конвейеров инференса, также необходима сетевая интеграция с помощью NVMe over Fabrics, RDMA и будущей поддержки CXL.
«Накопители должны обладать надежными эксплуатационными характеристиками: помимо пропускной способности и возможности передавать как можно больше данных так быстро, как это необходимо для обучения, — говорит Хартхорн. — Теперь речь идет о том, чтобы делать это очень стабильно, таким образом, чтобы это было легко отслеживать для людей, управляющих и организующих работу этих систем».
Как корпоративным лидерам в области ИИ планировать внедрение уровня контекста
Стандарты, программные примитивы и лучшие практики, формирующиеся сегодня, определят то, как будет функционировать инфраструктура инференса ИИ на долгие годы вперед. Solidigm участвует в этом процессе через органы стандартизации, сотрудничество с партнерскими лабораториями и публикацию исследований, что крайне важно именно потому, что категория все еще находится на стадии становления.
«Интересный вопрос на ближайшие пару лет заключается не в том, нужно ли ИИ-инфраструктуре больше вычислений, — говорит Хартхорн. — А в том, сможет ли она эффективнее использовать то, что у нее уже есть. Во многом ответ на этот вопрос кроется в том самом уровне, который создается сегодня».
Спонсорские статьи — это контент, подготовленный компанией, которая либо платит за публикацию, либо имеет деловые отношения с VentureBeat, и они всегда четко маркируются. Для получения дополнительной информации обращайтесь по адресу sales@venturebeat.com.




