Какая модель искусственного интеллекта лучше всего подходит для графического дизайна, видеорекламы, синхронизации губ и других задач? Новая арена OpenArt предлагает таблицы лидеров для различных медиазадач
Источник: VentureBeat · Carl Franzen


OpenArt, четырехлетний стартап из Сан-Франциско по разработке инструментов на базе ИИ для творчества, сооснователями которого стали бывшие сотрудники Google Коко Мао (Coco Mao) и Джон Цяо (John Qiao), хочет ответить на все более актуальный вопрос для компаний и частных лиц, использующих ИИ-модели для создания мультимедиа: не просто «какая модель лучше?», а «какая модель лучше для конкретной медиазадачи, которую мне нужно решить?»
Именно поэтому сегодня компания запускает новый общедоступный бенчмарк для генерации ИИ-изображений и видео: совершенно новый OpenArt Arena разделяет рейтинги моделей по категориям вариантов использования для таких сфер, как кинопроизводство, электронная коммерция, графический дизайн, моушн-дизайн, видеомонтаж и синхронизация губ (лип-синк), используя слепую парную оценку от практикующих специалистов в области творчества и более широкого круга лиц, которых компания называет «трендсеттерами».
Компания заявляет, что опубликует свою методологию и часть набора промптов на момент запуска, в то время как некоторые активные промпты для оценки оставит закрытыми, чтобы снизить риск подгонки моделей под бенчмарк.
Идея проста, но становится все более необходимой. Модели генерации изображений и видео сейчас выпускаются настолько быстро, что творческая команда может потратить значительное время просто на то, чтобы решить, использовать ли серию GPT Image от OpenAI, семейство Nano Banana від Google, модели Seedream и Seedance от ByteDance, Wan от Alibaba, Grok Imagine от xAI или другой вариант.
«Наша цель — сделать так, чтобы это стало новым стандартом, чтобы все больше и больше людей знали его и признавали», — рассказала Стелла Гуан (Stella Guan), руководитель отдела роста и операций в OpenArt AI, в эксклюзивном интервью VentureBeat, проведенном до завершения финального голосования на Арене. «Когда творческие люди хотят выбрать лучшую модель для создания изображений или видео, они должны думать об OpenArt Arena и знать, что это самый надежный отраслевой стандарт для выбора модели».
Сама платформа OpenArt построена на этом изобилии: она позволяет пользователям работать с основными сторонними моделями изображений и видео, а также продает собственные продукты для создания более высокого уровня, включая Director — свой разговорный рабочий процесс «вайб-дирекинга» (vibe directing) для генерации многосценовых видео.
Текущий каталог моделей OpenArt включает системы для работы с изображениями, видео, аудио и 3D от самых разных провайдеров.
«Какую модель мне выбрать?» — это один из вопросов, которые OpenArt постоянно получает от корпоративных клиентов, говорит Гуан.
По ее словам, для компаний из традиционных отраслей, которые только сейчас начинают внедрять генеративный ИИ, выбор модели может стать «первой проблемой, с которой они сталкиваются при внедрении ИИ».
Но как видеокреаторы и художники, использующие ИИ, выбирают лучшую модель в настоящее время?
Один плодовитый создатель контента под псевдонимом @BLVCKL!GHT рассказал VentureBeat через личные сообщения в X: «Какую модель я использую, полностью зависит от требуемой работы. Зацикленные анимации и более динамичные сцены требуют разных инструментов, поэтому проект может базироваться на Minimax или Seedance 2.5 уже только по этой причине. Клиенты часто запрашивают передовые модели, что облегчает мне выбор, но бюджет в конечном итоге определяет, что является практичным для любого конкретного проекта».
Структурирование по конкретным медиазадачам в сфере креативного ИИ
Вместо того чтобы публиковать одну оценку для изображений и одну для видео, OpenArt создает отдельные доски для разных задач и творческих дисциплин.
Сюда входят отдельные таблицы лидеров, показывающие, как модели ИИ для генерации изображений и видео оцениваются (по мнению отобранных вручную OpenArt пользователей из числа профессиональных креативщиков и внешних экспертов числом более 800 человек) в выполнении задач по анимации, рекламе, графическому дизайну, электронной коммерции, кино, моушн-дизайну, видеомонтажу, лип-синку и в целом.
Каждая доска должна использовать критерии, адаптированные под конкретную работу. Гуан привела в качестве примера кинопроизводство: там движение камеры, освещение, кинематографическое качество и реалистичная кожа могут иметь большее значение, в то время как рекламный рабочий процесс может придавать больше веса читаемому тексту, точным логотипам, точности продукта и его размещению.
Такой подход имеет значение, поскольку модель, сильная в одной конкретной творческой задаче, необязательно является лучшей в другой.
Это различие имеет гораздо более серьезные последствия для бизнеса, чем может показаться на первый взгляд. Отдел маркетинга, создающий снимки упаковки, внутренняя студия, создающая превизуализацию коммерческого ролика, и постпродакшн-команда, изменяющая существующие кадры, могут называть себя «использующими ИИ-видео», при этом предъявляя совершенно разные требования к базовой модели.
Таблица лидеров, которая объединяет эти задачи в один показатель предпочтения, может быть полезна для поиска универсальных систем, но при этом дает корпоративной команде мало указаний на то, какую именно модель следует задействовать для конкретной производственной задачи.
OpenArt заявляет, что генерирует результаты из курируемых наборов промптов для каждой доски и представляет их оценщикам без указания названий моделей.
Судьи делают выбор путем прямого сравнения (side-by-side), а не выставляют изолированные оценки, и OpenArt агрегирует эти предпочтения с помощью статистической модели Брэдли — Терри 1952 года — уравнения, которое вычисляет скрытую вероятность победы элемента на основе его результатов в очных противостояниях с конкурентами.
Пул судьей состоит из двух уровней. В меньший Совет экспертов по творчеству (Creative Expert Council) входят известные практики, такие как режиссер анимации, обладатель премии «Эмми» Уильям Лоу (William Lau), креативный технолог Уиллониус «Кинг Уиллониус» Хэтчер (Willonius “King Willonius” Hatcher), лидер в сфере маркетинга Дэвид Шинг (David Shing), а также руководители и преподаватели из таких организаций, как Edelman и UCLA.
Гуан сообщила, что OpenArt также привлекает примерно от 800 до 1000 «трендсеттеров» из числа пользователей OpenArt, сторонних творческих сообществ и работающих профессионалов в таких областях, как реклама.
эту цифру следует воспринимать как запланированный пул, а не как подтвержденное количество людей, завершивших оценки на момент запуска. OpenArt не предоставила окончательное количество судей, принявших участие в голосовании, общее количество парных оценок или число промптов в каждом бенчмарке запуска в материалах, предоставленных для этой статьи.
Гуан заявила, что компания намерена опубликовать часть каждого набора промптов и может выпускать более старые промпты после будущих обновлений, но не весь активный набор. «Одна из причин, по которой мы не публикуем все на старте, заключается в том, что к этим наборам данных было бы легко подстроиться», — сказала она.
Это законное опасение при разработке бенчмарков: полностью публичный статический тест в конечном итоге может измерять лишь то, насколько эффективно разработчики моделей оптимизируют их под сам тест, а не то, насколько хорошо их системы обобщаются на невиданные ранее творческие задачи.
Но сокрытие тестового материала создает сопутствующую нагрузку в плане прозрачности. Пользователи должны верить, что нераскрытые промпты адекватно представляют профессию, а результаты моделей генерируются, выбираются и сравниваются последовательно.
Что показывают первые рейтинги OpenArt Arena
Результаты в сфере видео обеспечивают главный информационный повод рейтингов запуска OpenArt Arena.
Seedance 2.5 от ByteDance — проприетарная модель, предоставляемая через API, публичные весы которой ByteDance не выпускала — лидирует в общей видео-таблице с результатом 1081 балл, за ней следует Wan 3.0 от Alibaba с 1044 баллами и Seedance 2.0 от ByteDance (также с закрытыми весами) с 1000 баллами.
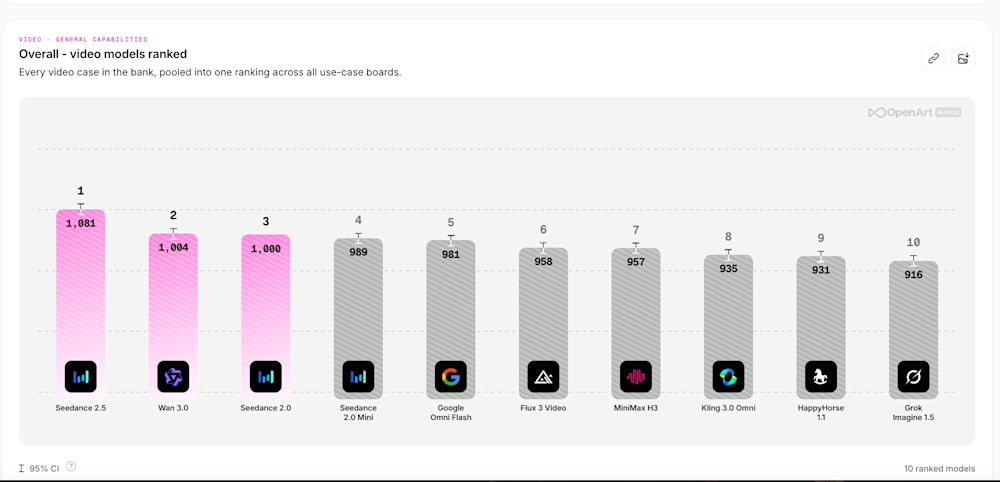
Рейтинги общей таблицы лидеров OpenArt Arena по видео. Источник: OpenArt
Wan 3.0 выделяется своей открытостью: Alibaba описывает ее как проект с открытым исходным кодом и опубликовала репозиторий с лицензией Apache 2.0, однако этот репозиторий в настоящее время содержит документацию и лицензию, а не загружаемые веса моделей, поэтому его пока не следует рассматривать как традиционный релиз с открытыми весами, пригодный для самостоятельного разхоратывания (self-hosting).
Преимущество Seedance 2.5 сохраняется в большинстве более специализированных видеокатегорий, оцененных OpenArt: из пяти таблиц лидеров по видео, представленных к запуску, она занимает первое место в четырех и второе в пятой. В таблице лидеров по кинематографу Seedance 2.5 занимает первое место с 1049 баллами, опережая Seedance 2.0 с 1000 баллами и Wan 3.0 с 958 баллами. Она также лидирует в моушн-дизайне с 1059 баллами, за ней следуют Seedance 2.0 с 1000 баллами и Wan 3.0 с 990 баллами.
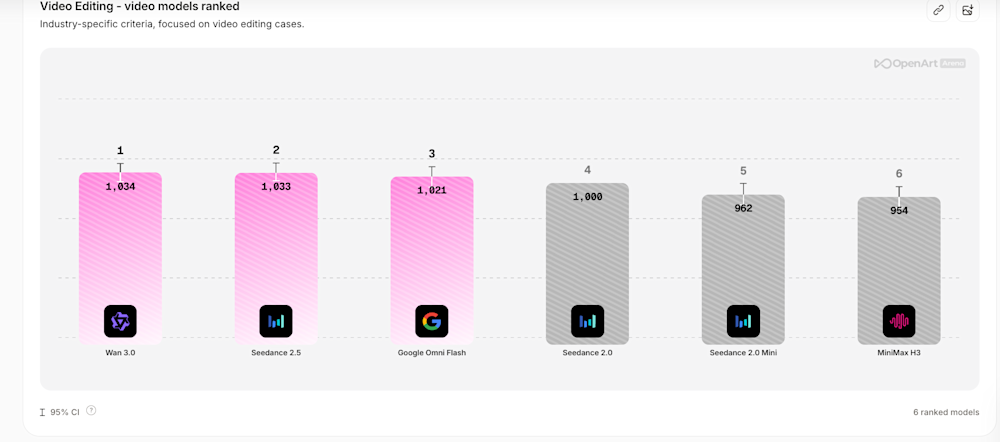
Рейтинги таблицы лидеров OpenArt Arena по видеомонтажу. Источник: OpenArt
Видеомонтаж является исключением (едва заметным) — и одним из наиболее полезных результатов для иллюстрации аргумента OpenArt о том, что выбор модели должен зависеть от задачи.
Wan 3.0 занимает первое место с 1034 баллами, Seedance 2.5 следует за ней с 1033 баллами, а проприетарная модель Google Gemini Omni Flash занимает третье место с 1021 баллом.
Google распространяет Omni Flash как часть своего семейства моделей Gemini, а не в виде загружаемых открытых весов. Seedance 2.5 затем возвращается на вершину в категории лип-синков (синхронизации губ), набрав 1063 балла, опережая Seedance 2.0 с 1000 баллами и Seedance 2.0 Mini (еще один хостинговый вариант от ByteDance, а не релиз с открытыми весами) с 994 баллами.
Другими словами, Seedance 2.5 выглядит сильнейшим универсальным видеогенератором в тестовых испытаниях OpenArt при запуске, однако она номинально побеждает далеко не во всех специализированных задачах.
OpenArt отображает 95-процентные доверительные интервалы в таблицах, что является важной оговоркой, когда оценки близки. Разница в один балл, такая как 1034 у Wan 3.0 против 1033 у Seedance 2.5 в видеомонтаже, сама по себе не должна интерпретироваться как свидетельство значимого разрыва в качестве.
Доминирование Seedance 2.5 отражается на ее использовании в пространстве создателей ИИ-контента. Зак Лондон (Zack London), более известный как высококлассный создатель научно-фантастического/фэнтезийного ИИ-видео Gossip Goblin, чей полнометражный ИИ-фильм Gods Don’t Give Gifts премьера которого состоится в соне кинотеатров позднее в этом году, рассказал VentureBeat через личные сообщения в X:
«Год назад рынок был довольно разнообразным — Hailuo, Kling и Veo имели свои достоинства, наряду с более нишевыми инструментами лип-синка вроде Sync Labs, Hedra и HeyGen. Теперь Seedance настолько глубоко впереди всего остального, что об этом даже не стоит дискутировать. Я могу с уверенностью сказать, что никто из авторитетных креаторов в этой сфере больше не использует ничего, кроме Seedance. H3 от Hailuo используется для массового спама и автоматизации, но для серьезной работы единственный вариант — это Seedance».
Для корпоративных покупателей более полезным сигналом является паттерн на разных досках — какие модели неизменно показывают высокие результаты, где изменение производственной задачи меняет расстановку сил, и может ли модель разворачиваться самостоятельно (self-hosted) или требует зависимости от вендора или API-провайдера.
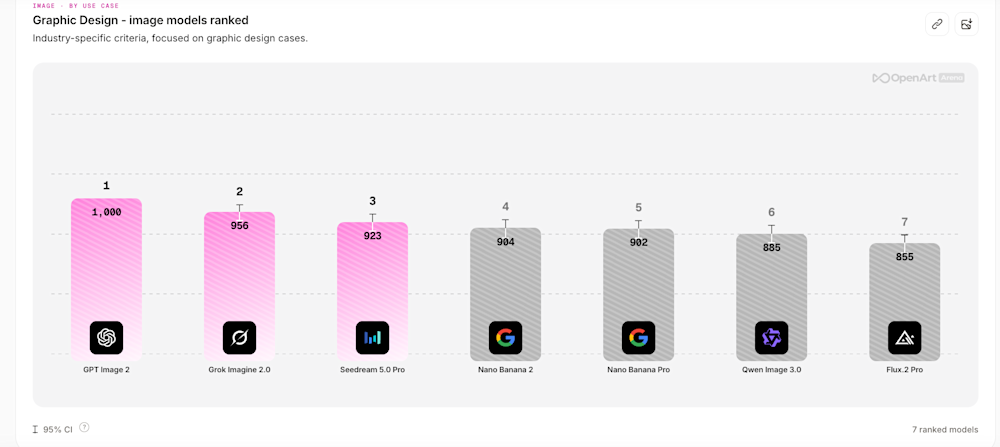
Рейтинги изображений более фрагментированы, и ни одна модель не доминирует единолично на всех трех стартовых досках, предоставленных для этой статьи.
Рейтинги таблицы лидеров OpenArt Arena по видеомонтажу. Источник: OpenArt
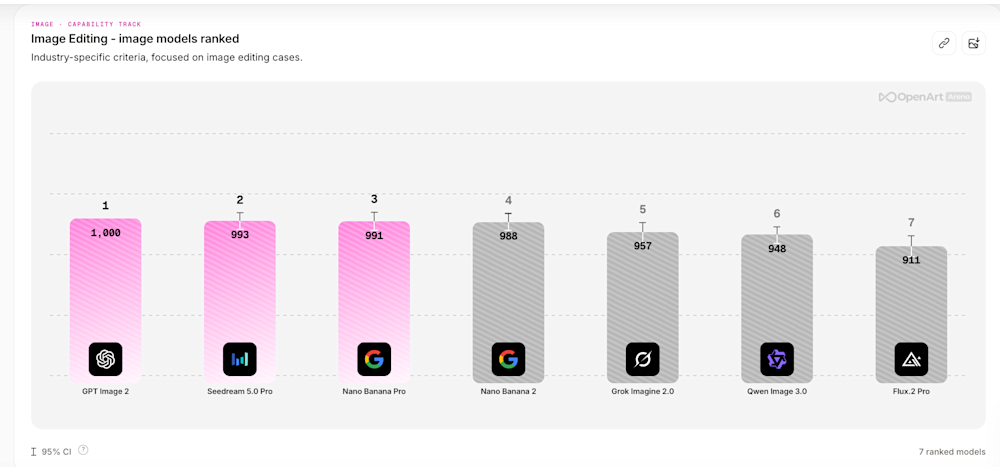
Рейтинги таблицы лидеров OpenArt Arena по редактированию изображений. Источник: OpenArt
Проприетарная модель OpenAI GPT Image 2, доступная через API OpenAI, а не в качестве модели с открытыми весами, занимает первое место в графическом дизайне и редактировании изображений, в обоих случаях получая 1000 баллов.
Тем не менее, когда дело доходит до изображений для кино, Seedream 5.0 Pro лидирует с 1014 баллами, в то время как модель с закрытыми весами Nano Banana Pro от Google (Gemini 3 Pro Image) и GPT Image 2 набирают по 1000 баллов, занимая соответственно второе и третье места. Seedream 5.0 Pro также возглавляет доску изображений для электронной коммерции с 1004 баллами, немного опережая GPT Image 2 с 1000 баллами и аналогично проприетарную Nano Banana 2 от Google (Gemini 3.1 Flash Image) с 993 баллами.
В целом, если говорить о производительности моделей изображений по всем задачам, оценщики OpenArt отдали предпочтение Seedream 5.0 Pro от Alibaba с результатом 1010 баллов, опередив GPT Image 2 на 10 баллов. Обратите внимание, что OpenAI обновила модель до версии GPT-Images-2.5 на прошлой неделе, а это значит, что таблице лидеров OpenArt также потребуется обновление для учета этого изменения.
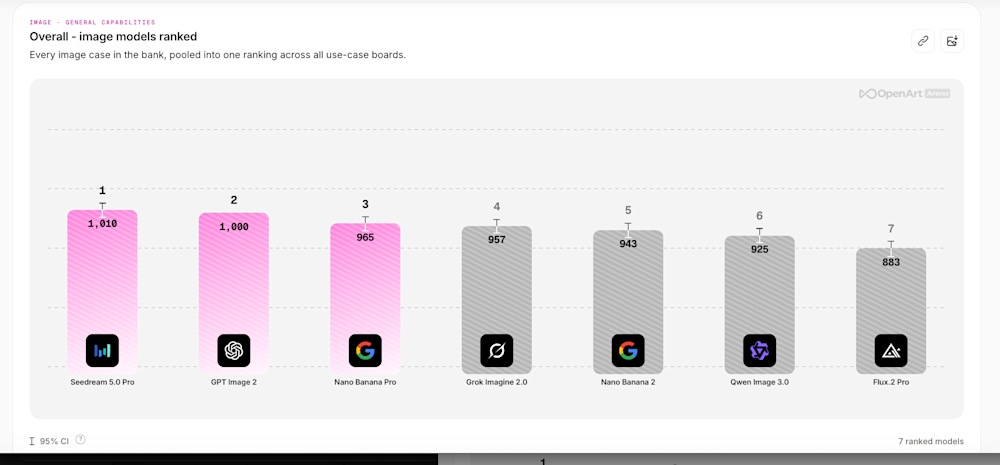
Рейтинги общей таблицы лидеров OpenArt Arena по моделям изображений. Источник: OpenArt
Разница в открытости среди лидеров запуска OpenArt выглядит довольно резкой: Wan 3.0 является единственным заметным участником первой тройки, которого разработчик позиционирует как проект с открытым исходным кодом, хотя ее текущий публичный релиз пока не предоставляет веса, необходимые для независимого самостоятельного развертывания.
Для предприятий это не просто сноска о лицензировании: это влияет на контроль развертывания, локализацию данных, возможности кастомизации, зависимость от поставщика и потенциально общую стоимость владения.
Выступая до того, как стали доступны эти финальные рейтинги, Гуан отметила, что предварительное голосование OpenArt уже выявило случаи, которых они не ожидали. «Есть определенные области, которые нас удивили, — сказала она. — Некоторые модели, которые, по нашему мнению, не должны были занять высокие места в конкретном варианте использования, продемонстрировали свои преимущества благодаря этой таблице лидеров».
По ее утверждению, в этом и заключается часть смысла разделения задач. «Если вы соревнуетесь просто по общим показателям, некоторые модели могут не оказаться лучшими, — пояснила Гуан. — Но они могут быть лучшими в конкретных вариантах использования или по определенным критериям».
Финальные таблицы предлагают по крайней мере некоторые доказательства в пользу этого утверждения, даже если они не переворачивают рынок повсеместно. Seedance 2.5 выглядит скорее сильным универсальным видеогенератором в тестировании OpenArt, чем узким специалистом, но первое место Wan в видеомонтаже и меняющиеся победители в категориях изображений демонстрируют, почему производственным группам все же может быть полезно распределять задачи между несколькими моделями, а не слепо стандартизировать их на какой-то одной.
OpenArt — не первая и не единственная компания, предлагающая рейтинги по категориям
|
Таблица лидеров / бенчмарк |
Кто оценивает |
Как сегментированы рейтинги |
Подход к оценке |
Ключевое отличие |
|
Совет экспертов по творчеству + более широкий пул креативных «трендсеттеров» |
Конкретные творческие задачи: кино, графический дизайн, электронная коммерция, моушн-дизайн, видеомонтаж, лип-синк и др. |
Курируемые наборы задач-промптов; слепые парные сравнения; рейтинги Брэдли — Терри |
Наиболее явно организована вокруг индивидуальных производственных задач как для изображений, так и для видео; интегрирована с коммерческой творческой платформой |
|
|
Практикующие профессионалы креативной сферы, привлеченные из сети Contra |
Креативные домены + этапы рабочего процесса: целевые страницы, рекламные изображения, брендовые изображения, видео продуктов и т. д., каждый тестируется на этапах идеи, макета и доработки |
Слепые парные сравнения + скалярные оценки + качественная обратная связь; Брэдли — Терри / Эло; публикует подробную методологию исследования и наборы данных |
Скорее продолжающаяся исследовательская программа, чем чистая таблица лидеров; анализирует, почему производительность меняется на разных этапах и где экспертные мнения сходятся или расходятся |
|
|
Широкое общественное / комьюнити-голосование |
Изображения: коммерческий дизайн, кинематографические образы, портреты, рендеринг текста, 3D, искусство и т. д. Видео сегментировано больше по режиму генерации |
Слепые парные предпочтения с рейтингами по категориям, отфильтрованными из миллионов реальных промптов; отчеты о неопределенности / разбросе рейтингов |
Наибольший акцент на масштабе толпы и органических промптах пользователей; рейтинги изображений уже существенно пересекаются с концепцией задач от OpenArt |
|
|
Краудсорсинговые голосующие в слепом тестировании |
Варианты использования изображений, такие как маркетинг, электронная коммерция, художественное кино, UI/UX и контент для создателей. Видео более функционально ориентировано (текст-в-видео, изображение-в-видео, монтаж и аудиоварианты) |
Курированная таксономия промптов; слепое парное голосование; Эло по Брэдли — Терри; также отслеживает цену, скорость и статус открытых весов |
Самый широкий обзор бенчмаркинга/закупок, объединяет качество со стоимостью, задержкой и открытостью моделей; категории изображений сильно привязаны к задачам, в то время как сегментация видео больше основана на модальности, чем доски творческих задач OpenArt |
Впрочем, OpenArt — далеко не единственная компания, предлагающая рейтинги производительности ИИ-моделей в творческих задачах.
Например, Contra Labs уже проводит оценки генеративных креативных моделей силами практиков в рамках своего проекта Human Creativity Benchmark (HCB), представленного в апреле 2026 года как способ для специалистов творческих профессий оценивать системы ИИ на предмет профессиональной креативной работы.
Вместо того чтобы полагаться на общие технические метрики, Contra привлекает работающих креативщиков из своей сети, дает моделям реальные брифы, скрывает идентичность моделей во время оценки и использует парные сравнения, агрегированные с помощью модели Брэдли — Терри в рейтинги в стиле Эло (шахматные рейтинги).
Более широкий фреймворк HCB от Contra Labs охватывает такие домены, как целевые страницы (landing pages), десктопные приложения, рекламные и брендовые изображения, а также видеопродукты, и разбивает работу на этапы генерации идей (ideation), макетирования (mockup) и доработки (refinement) — структуру стадий рабочего процесса, которая отличается от более детальных рейтингов OpenArt Arena для конкретных творческих задач, таких как кинопроизводство, моушн-дизайн, видеомонтаж и лип-синк.
Бенчмарк Contra также разработан для того, чтобы фиксировать нечто большее, чем просто предпочтения «победитель против проигравшего». Оценщики оценивают результаты по соответствию промпту, удобству использования и визуальной привлекательности, а также предоставляют качественные объяснения своих суждений. Contra явно проводит различие между «конвергенцией», когда профессионалы склонны сходиться во мнениях по таким вопросам, как читаемость или техническая корректность, и «дивергенцией», где разногласия отражают законные различия во вкусах и творческом направлении. Ее исследования неоднократно показывали, что ни одна модель не доминирует на всех этапах творческой работы — вывод, который тесно параллелит аргумент OpenArt о том, что «лучшая» модель зависит от конкретной задачи.
Помимо основного HCB, Contra Labs ведет постоянную исследовательскую программу битв моделей, профилей и полевых заметок по генерации изображений, видео, веб-дизайну, типографике, созданию логотипов, переносу стилей и другим профессиональным творческим задачам.
Недавние исследования вновь возвращались к тем же доменам по мере появления новых моделей или изменения структуры оценки со стороны Contra, и компания публикует количество оценщиков, структуры промптов, объемы суждений и, в некоторых случаях, открытые наборы данных вместе со своими выводами.
Это делает Contra одним из самых явных существующих соперников OpenArt Arena. Ключевое отличие заключается не столько в методологии, сколько в том, как продукты организованы и представлены.
В настоящее время Contra работает скорее как непрерывно обновляемая программа исследований и бенчмаркинга, часто анализируя, где и почему производительность моделей меняется на разных этапах рабочего процесса.
OpenArt запускает Arena как постоянный общедоступный слой выбора моделей с отдельными таблицами лидеров для конкретных задач по изображениям и видео, таких как кинопроизводство, электронная коммерция, моушн-дизайн, видеомонтаж и лип-синк. Иными словами, судейство практиков, слепые сравнения и оценка с учетом рабочего процесса не уникальны для OpenArt; ее дифференциация заключается скорее в упаковке этих идей в широкий, постоянно доступный набор таблиц лидеров по конкретным задачам, которые она также может интегрировать в свою собственную творческую платформу.
Arena.ai также уже предлагает рейтинги изображений по категориям. Компания внедрила категорийные таблицы лидеров после анализа большой коллекции реальных промптов для генерации изображений, организовав их по таким направлениям, как «Продукты, брендинг и коммерческий дизайн» (Product, Branding & Commercial Design); «Фотореалистичные и кинематографические образы» (Photorealistic & Cinematic Imagery); «Портреты» (Portraits); «Рендеринг текста» (Text Rendering); «3D-изображения и моделирование» (3D Imaging & Modeling); «Искусство» (Art) и другие домены. Arena.ai заявляет, что таблица категорий использует ту же базовую методологию оценки, что и ее общая арена, с фильтрацией по промптам, принадлежащим к данному домену.
Масштаб здесь находится в совершенно другом классе по сравнению с курируемой экспертной панелью. Только доска текстов в изображения «Продукты, брендинг и коммерческий дизайн» от Arena.ai за 7 сентября сообщает о более чем 1,9 миллиона голосов по 78 моделям. Ее арена редактирования изображений аналогичным образом предлагает просмотр по категориям для коммерческого дизайна, кинематографических образов, портретов, рендеринга текста и других задач.
Как отметил другой плодовитый создатель ИИ-видео Кири Маргарос (@Kyrannio), создатель студии автоматизированного видеопроизводства No Spoon Studios, в личном сообщении в X:
«Обычно я смотрю на Арену, чтобы оценить то, что есть на рынке в настоящее время, и оттуда, особенно в отношении текста, изображений или переноса референсов в видео, я уделяю более пристальное внимание тем метрикам и моделям в своих продуктах, когда они показывают лучшие результаты и дебютируют в разных доменах. Однако, если не использовать таблицы лидеров, все сводится к простому внедрению новых моделей по мере их выхода в мой продукт и последующей оценке того, как они справляются в моем текущем стеке, чтобы посмотреть, как это выглядит в сравнении. Я думаю, что стоимость и скорость — это тоже компромиссы, как и чрезмерно агрессивная модерация. Если у вас супермедленная модель, которая работает вечно, стоит дорого и модерирует все, что вы делаете, позиции в таблице лидеров не имеют большого значения, потому что она практически непригодна для использования. Хотя в целом это отличный и быстрый способ быстро узнать, какие из них будут SOTA (state-of-the-art — передовыми), и каковы их сильные стороны, прежде чем полностью погружаться через API, если это понятно!! … Множество метрик арены для новых моделей действительно направляют дорожную карту моего продукта, и я обращаю на арену самое пристальное внимание».
Таким образом, фраза «профессионалы оценивают результаты» не нова, как и концепция «разные категории имеют разные таблицы лидеров».
В чем OpenArt действительно выглядит существенно иначе, так это в комбинации и организации этих идей. Категории изображений Arena.ai в значительной степени представляют собой кластеры доменов промптов, полученные на основе крупномасштабного использования сообществом, что означает, что ее специализированные рейтинги изображений возникают путем фильтрации голосов из промптов, классифицированных по этим доменам.
OpenArt начинает движение с другого направления: она сначала определяет профессиональный вариант использования, разрабатывает специализированный тестовый набор и критерии для этой доски, а затем просит отобранную популляцию оценщиков оценивать результаты на их основе.
Artificial Analysis — еще одно близкое сравнение, и со стороны изображений она еще больше сужает дифференциацию OpenArt. Ее Image Arena не ограничивается одним общим рейтингом текста в изображения: Artificial Analysis заявляет, что ранжирует модели по таксономии реальных вариантов использования, включая маркетинг и рекламу, розничную торговлю и электронную коммерцию, игровое и художественное кино, анимацию и гейминг, архитектуру и недвижимость, UI/UX-дизайн, социальные сети и контент для авторов, а также по срезам возможностей, таким как рендеринг текста, макет и человеческая анатомия.
Компания публикует соответствующие подкатегории — включая «Коммерческие», «Люди/Портреты» и «Текст и типографика» — и использует курируемые промпты, тегированные как по варианту использования, так и по возможностям. Результаты оцениваются путем слепого парного голосования пользователей с оценками, рассчитанными с использованием оценки максимального правдоподобия Брэдли — Терри, а набор промптов обновляется ежемесячно. Это означает, что кино- и коммерческие доски изображений OpenArt сами по себе не являются принципиально новым видом ранжирования изображений под конкретные задачи.
Это различие гораздо более значимо в видео. Artificial Analysis поддерживает отдельные пулы Video Arena Elo для текста в видео, изображения в видео и видеомонтажа, с дополнительными разделениями для моделей, генерирующих синхронизированное аудио, а также публикует фильтры цен и открытых весов рядом с рейтингами.
Но это в первую очередь деления по модальности генерации или техническому рабочему процессу, а не более тонкие доски профессиональных вариантов использования, которые запускает OpenArt для кино, моушн-дизайна, видеомонтажа и лип-синка. Следовательно, Artificial Analysis уже существенно пересекается с OpenArt в бенчмаркинге задач по изображениям и даже напрямую конкурирует в видеомонтаже, в то время как более сильная дифференциация OpenArt заключается в ширине ее рейтингов видео по конкретным творческим задачам и использовании отобранного совета экспертов и пула креативных практиков/трендсеттеров вместо более широких краудсорсинговых голосов предпочтений Artificial Analysis.
Artificial Analysis также явно описывает себя как независимую организацию и заявляет, что не принимает никакой компенсации от поставщиков моделей за включение или благоприятные результаты — структурное отличие от OpenArt, которая управляет коммерческой творческой платформой, где многие из ранжируемых моделей доступны пользователям.
Для корпоративного руководителя по креативу эти методологические различия могут изменить то, как следует использовать таблицу лидеров. Общий показатель потребительских предпочтений может помочь выявить модели с широкой привлекательностью, в то время как узкоспециализированный профессиональный бенчмарк может быть более полезен для маршрутизации рабочих процессов.
Ни то, ни другое не заменяет внутреннее тестирование на собственных брендах, референсах, юридических ограничениях и производственных стандартах компании. Практическая ценность Arena поэтому будет зависеть как от того, насколько точно OpenArt определяет каждую доску, так и от того, какая модель займет первое место.
Иными словами, защищаемая дифференциация OpenArt заключается не в том, что она изобрела экспертную оценку или сегментацию по категориям. Она пытается объединить курируемые тестовые наборы для конкретных профессий, судейство под руководством экспертов, более широкий пул оценщиков и постоянно доступную таблицу лидеров изображений и видео в одном месте.
Она также теснее увязывает этот бенчмарк с выбором моделей внутри коммерческой креативной платформы. Это может сделать Arena необычайно практичной для пользователей, которые могут перейти от рейтинга к генерации с помощью выбранной модели в той же среде, но это также порождает важнейший вопрос управления, окружающий запуск.
Вопрос независимости
Есть еще одно отличие, которое корпоративным покупателям следует держать в поле зрения: OpenArt не является независимой академической бенчмарк-организацией. Это коммерческая платформа для создания контента с помощью ИИ, работающая на том же рынке, который оценивает ее таблица лидеров.
Сама OpenArt заявляет, что агрегирует более 100 моделей, а ее текущий каталог моделей включает такие системы, как Seedance, Veo, Kling, Wan, GPT Image, Nano Banana, Seedream и Grok Imagine.
Это не значит, что результаты запуска предвзяты, а предоставленные рейтинги, судя по всему, не включают базовую модель изображения или видео под брендом OpenArt.
Но OpenArt продает доступ ко многим из сравниваемых моделей и управляет такими продуктами, как Director, поверх них. Ее видеопродукт явно предлагает пользователям широкий спектр базовых моделей в рамках одного рабочего пространства.
Arena также будет интегрирована в интерфейс выбора моделей OpenArt, сказала Гуан, поэтому бенчмарк может влиять на то, какую базовую модель выбирает клиент, оставаясь при этом на платформе OpenArt.
Это делает взаимоотношения более сложными, чем традиционный сторонний бенчмарк. У OpenArt есть законная продуктовая причина помогать пользователям делать правильный выбор — клиент, получающий плохие результаты от неправильной модели, может обвинить платформу, — но у нее также есть коммерческий интерес в том, чтобы стать местом, где клиенты принимают это решение и реализуют его.
Правильный вывод заключается не в том, что результаты Arena следует сбрасывать со счетов, а в том, что ее методология и управление заслуживают такого же тщательного контроля, который предприятия применяют к любому созданному вендором бенчмарку, способному повлиять на решения о закупках или маршрутизации рабочей нагрузки.
Это делает управление и воспроизводимость еще более важными, а не наоборот. К моменту запуска OpenArt раскрыла статистический подход, общую стратегию рекрутинга, назвала членов своего экспертного совета и объявила о планах опубликовать часть промптов. Но компания пока не предоставила количество промптов, количество завершивших оценку судей или общее количество голосов, которые позволили бы посторонним сравнить масштаб и охват ее стартовых оценок с опубликованными исследованиями Contra или массивными датасетами голосования сообщества Arena.ai.
Сравнение делает этот пробел более заметным, поскольку конкуренты показали, что эти цифры могут быть раскрыты без необходимости обнародовать весь бенчмарк целиком. Contra, например, публикует количество своих оценщиков, структуру задач и общее количество парных суждений, продолжая при этом проводить повторные исследования. Arena.ai демонстрирует количество голосов и диапазоны достоверности прямо рядом со своими рейтингами.
Запланированный OpenArt пул трендсеттеров в количестве от 800 до 1000 человек звучит внушительно, но пока OpenArt не сообщит, сколько из них реально участвовали в конкретной доске, сколько суждений они произвели и сколько промптов они увидели, читатели не смогут сказать, какой объем доказательств лежит в основе индивидуального рейтинга запуска.
Для корпоративных команд это должно превратить OpenArt Arena в инструмент ввода данных для выбора модели, а не в оракул. Самый полезный бенчмарк — это тот, который похож на реальную работу организации: снимки продуктов с точной упаковкой, рекламные материалы с типографикой, кинематографические последовательности с движением камеры или правки, которые должны сохранить существующие кадры клиента.
Задачно-ориентированные доски OpenArt движутся в этом направлении, и компания также планирует включать более объективную корпоративную информацию о моделях, такую как ценообразование, модерация контента и характеристики защиты интеллектуальной собственности. Гуан заявила, что OpenArt также хочет показывать компромиссы между ценой и производительностью, а не ранжировать качество без учета бюджета.
Компания заявляет, что Arena будет общедоступной и «относительно независимой» от остальной части OpenArt, и Гуан добавила, что в конечном итоге OpenArt может изучить партнерства, которые позволят другим платформам использовать рейтинги или интегрировать их. Это не является частью первоначального запуска.
Место OpenArt Arena в корпоративном ИИ-рабочем процессе
OpenArt Arena появляется в подходящий момент, потому что закупки креативного ИИ превращаются в проблему маршрутизации. Модель, которая создает лучшее центральное изображение (hero image), может не уметь чисто рендерить типографику; лучший кинематографический генератор может не быть лучшим редактором; а модель с высочайшим эстетическим потолком может оказаться неэкономичной в масштабе.
Первые результаты Arena подтверждают этот аргумент конкретной моделью. Seedance 2.5 является фаворитом видеодосок запуска OpenArt, занимая лидерство в общих рейтингах, кино, моушн-дизайне и лип-синке, уступив первое место в видеомонтаже всего на один балл.
В изображениях лидерство разделяют GPT Image 2 для графического дизайна и Seedream 5.0 Pro для кино и электронной коммерции.
Эти результаты полезнее рассматривать как карту того, где модели выглядят наиболее сильными, а не как провозглашение единого постоянного победителя — особенно на рынке, где, как отметил Гуань, новая модель может появиться уже через неделю.
Результаты запуска лишь подтверждают эту мысль. Более сложный вопрос теперь заключается в том, сможет ли OpenArt сделать сам бенчмарк достаточно прозрачным, чтобы творческие команды доверяли рекомендуемому им пути.