EvoHarness-RL от Meta AI повышает эффективность агентов
Источник: VentureBeat · Ben Dickson


Представьте себе ИИ-агента, перед которым стоит сложная корпоративная задача, например перенос огромных массивов клиентских записей из устаревшей CRM-системы в облачную базу данных. Агент не может полагаться исключительно на свое внутреннее контекстное окно для выполнения работы, длящейся часами, и зависит от среды выполнения, также известной как обвязка (harness).
Эта обвязка предоставляет обратную связь о выполнении, такую как логи сервера, помогая агенту поддерживать актуальное понимание динамических API-соединений. Она также обеспечивает работу трекеров состояния и механизмов управления ходом выполнения для контроля завершенных и незавершенных подзадач, гарантируя, что агент не пропустит пакеты данных и не продублирует их. Возникающие непредвиденные ошибки, например отказ базы данных принять пакет из-за строгих лимитов частоты запросов API, также обрабатываются с помощью инструментов и инструкций, предоставляемых обвязкой для восстановления работы агента.
Основной способ подсказать агенту, как и когда использовать свои инструменты, заключается в том, чтобы разработчик написал набор правил и инструкций, указывающих ему, что делать шаг за шагом. Например, разработчик может поручить агенту всегда выполнять поиск по внутренней вики-петердии компании перед написанием электронного письма. Поскольку агент просто следует жесткому сценарию, ему не хватает истинной автономности. Он не обучен самостоятельно сопоставлять затраты и выгоды своих действий.
Чтобы решить эту проблему, исследователи из Meta AI и Иллинойсского университета в Урбане-Шампейне представили EvoHarness-RL — фреймворк, который добавляет уровень абстракции в обвязку агента и учит базовую модель тому, когда следует читать, обновлять или обобщать информацию, получаемую из окружающей среды.
В долгосрочных задачах то, как ИИ-агенты читают и обрабатывают информацию, получаемую из окружения, имеет решающее значение для их успеха. Агент должен обновлять свое понимание среды, отслеживать выполненные и ожидающие выполнения подзадачи, восстанавливаться после неудачных действий и повторно использовать процедуры из предыдущего опыта. Такое выполнение зависит именно от обвязки.
Серия саморазвивающихся агентных фреймворков, таких как Harness-1, решает часть проблемы путем накопления прошлых траекторий и их дистилляции в структурированную процедурную память — например, в многоразовые навыки, рабочие процессы или библиотеки кода для будущих задач. Тем не менее, они обычно отделяют это долгосрочное накопление навыков от отслеживания состояния в реальном времени в рамках конкретного эпизода. Они не обучают агента активно тому, как управлять актуальной реальностью окружающей среды или отслеживать активные шаги задачи в процессе работы.
Сюйин Нин (Xuying Ning), соавтор научной работы по EvoHarness-RL, рассказал изданию VentureBeat, что ручная логика и жесткие структуры памяти являются главными причинами истощения инженерных ресурсов.
«Оптимальная обвязка часто меняется вместе с моделью, — пояснил Нин. — Разным моделям могут требоваться разные промпты, схемы памяти, разрешения или настройки песочницы. Если вся эта логика закодирована вручную, каждое обновление модели может приводить к очередному долгому циклу настройки и отладки».
Более того, существующие системы памяти, которые просто накапливают опыт, могут активно ухудшать способность агента к рассуждению. «Память только с возможностью добавления (append-only) предполагает, что больше контекста всегда полезно, но это не обязательно так, — отметил Нин. — В ходе выполнения длительной задачи память может содержать устаревшие выводы, неудачные попытки или информацию, которая больше не актуальна». В результате агентам, решающим долгосрочные задачи, необходима динамическая память, способная обновлять, сжимать и заменять информацию, чтобы избегать повторения прошлых ошибок.
EvoHarness-RL: Единое рабочее пространство убеждений, прогресса и опыта
Чтобы преодолеть ограничения жестких промптов, создаваемых вручную, исследователи представляют EvoHarness-RL — метод обучения, который учит агента оптимально использовать свою обвязку. Вместо слепого следования жестко заданным инструкциям агент учится формировать структурированное рабочее пространство из хаотичных данных выполнения и решать, когда и как обращаться к этому внешнему состоянию в ходе сложных рабочих процессов.
Чтобы упростить управление различными компонентами обвязки, EvoHarness-RL объединяет системы поддержки агента в единый интерфейс. Этот интерфейс, получивший название BPE (Belief, Progress, and Experience — Убеждения, Прогресс и Опыт), подразделяет внешние потребности агента на три функциональные области:
-
Убеждения (Belief): Поддержание точного понимания текущего окружения.
-
Прогресс (Progress): Управление завершенными и ожидающими выполнения подзадачами.
-
Опыт (Experience): Повторное использование исторических знаний при решении задач.
Вместо использования сложных предметно-ориентированных API, ИИ взаимодействует с этой понятной панелью управления с помощью четырех компактных мета-действий: отслеживать (track), фиксировать (commit), вызывать в памяти (recall) и делать заметки (note). Он отдает команды для отслеживания текущего окружения, фиксации обновлений рабочего процесса, извлечения прошлых стратегий перед началом действий и записи заметок для сохранения вновь обнаруженных идей для будущих запусков.
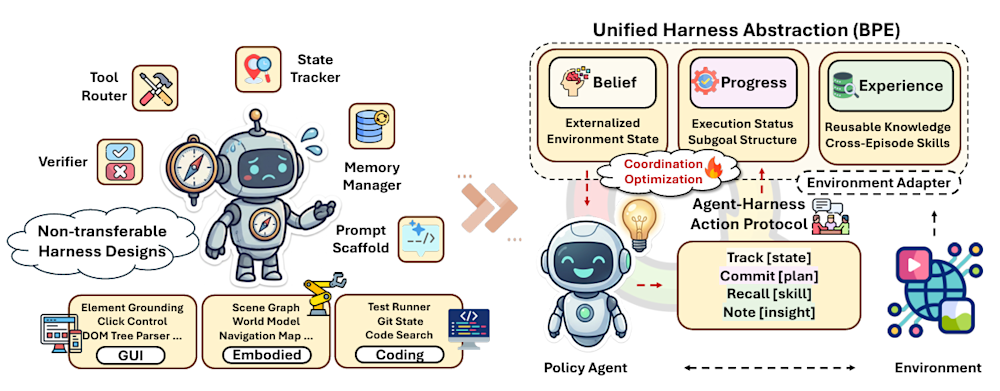
Фреймворк BPE (источник: arXiv)
Эти состояния напрямую сопоставляются с высокоценными корпоративными вертикалями. «В разработке программного обеспечения убеждения могут представлять текущее понимание репозитория агентом», — говорит Нин, подробно описывая, как агент отслеживает взаимодействия компонентов и изменения в рабочем пространстве. «Прогресс отслеживает то, что уже было сделано, что еще предстоит сделать и какие шаги зависят от других». Между тем опыт фиксирует уроки — например, отзывы пользователей об ошибке — для направления будущих действий.
Тот же принцип применим и к сфере финансов, отмечает Нин. Во время аудита соответствия требованиям убеждения могут описывать применимые правила и доступные доказательства. Прогресс отслеживает, какие проверки уже завершены и какие исключения остаются открытыми. Опыт помогает агенту распознавать повторяющиеся расхождения или понимать, когда проблему следует эскалировать.
«В совокупности эти состояния помогают предотвратить ситуацию, когда агент теряет нить работы или повторяет один и тот же ошибочный подход», — подчеркнул Нин.
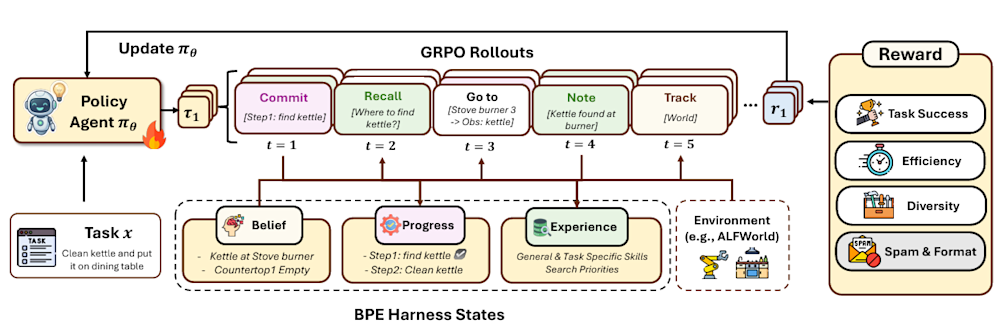
Конвейер обучения EvoHarness-RL (источник: arXiv)
Чтобы научить агента как механике, так и стратегии управления внешним рабочим пространством, исследователи разработали двухэтапный метод обучения. На первом этапе — контролируемой тонкой настройке обвязки — базовой модель обучается извлекать и структурировать полезные факты из беспорядочных логов взаимодействия в рамках фреймворка BPE.
Тем не менее, запросы к памяти или обновление трекеров требуют времени и вычислительных токенов, а это значит, что агент не может позволить себе слепо проверять свои инструменты на каждом шаге. Для решения этой проблемы на втором этапе используется «учитывающее затраты» обучение с подкреплением (cost-aware reinforcement learning), которое приучает агента к эффективности. Эта фаза обучает агента рассчитывать, оправдан ли доступ к внешнему состоянию затратами выделенного бюджета. Этот двухшаговый процесс превращает использование инструментов из жесткого, зашитого в код промпта в приобретенное поведение во время выполнения.
EvoHarness-RL в действии
Для проверки EvoHarness-RL исследователи протестировали систему с использованием бенчмарка ALFWorld — текстовой среды, включающей многошаговые задачи для проверки последовательной логики и отслеживания состояния.
В качестве базовой модели для обучения использовалась Qwen3-8B. Команда противопоставила обученную 8B-модель трем крупным передовым моделям (Claude Opus 4.5, GPT-4.1 и GPT-5), замороженным агентным фреймворкам со статическими инструментами (таким как ReAct, ExpeL и ReasoningBank), а также передовым обучаемым методам (например, стандартным GRPO, SkillOS и SkillRL).
Результаты демонстрируют значительный скачок производительности для небольших, экономически эффективных моделей. С помощью EvoHarness-RL модель Qwen3-8B достигла среднего показателя успешности в 96,9%, что на 46,9 процентных пункта выше по сравнению с базовой моделью ReAct.
Более того, обученная модель превзошла передовые обучаемые фреймворки, такие как SkillRL (89,9%) и SkillOS (80,2%). Что особенно впечатляет корпоративных разработчиков, стремящихся оптимизировать затраты на вычисления, 8B-модель фактически сравнялась с верхним пределом производительности дорогих закрытых моделей, таких как Claude Opus 4.5, набравшая 96,4% «из коробки».
Помимо расширения возможностей небольших моделей, эксперименты показывают, что фреймворк BPE приносит универсальные преимущества для моделей любого масштаба, даже без масштабной фазы обучения с подкреплением. Когда исследователи снабдили замороженные передовые модели промпт-обвязкой BPE «из коробки», показатели их выполнения значительно улучшились. Процент успешных решений GPT-4.1 вырос на 22,1 пункта, а GPT-5 — на 25,7 пункта.
Помимо результатов, исследователи зафиксировали во время экспериментов эффекты, демонстрирующие динамическое поведение, которое языковые модели приобретают в процессе обучения EvoHarness-RL. На этапе обучения с подкреплением они наблюдали поведенческий сдвиг по мере того, как агент со временем усваивал знания — этот процесс они назвали «отжигом обвязки» (harness annealing).
В начале обучения ИИ сильно полагался на запросы к модулям опыта и прогресса практически на каждом шаге. Однако по мере освоения рутинных действий он активно снижал зависимость от внешних инструментов, внедряя успешные паттерны непосредственно в свои параметры. В реальных корпоративных условиях это напрямую приводит к снижению задержек и уменьшению вычислительных затрат. Благодаря отжигу использования инструментов ИИ перестает тратить впустую токены и время на запросы к базам данных для стандартных рабочих процессов, которые он уже освоил.
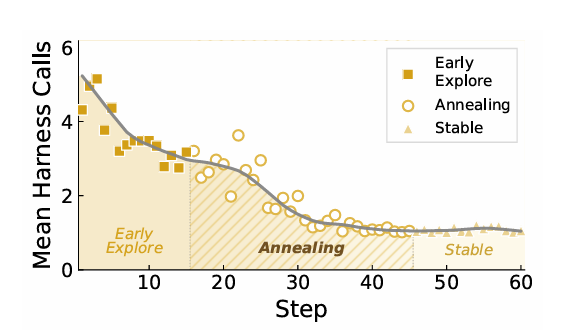
Отжиг обвязки (источник: arXiv)
Одновременно с этим агент продемонстрировал «эволюцию обвязки» (harness evolution), динамически адаптируя свою стратегию в зависимости от сложности текущей ситуации. Пропуская инструменты для простых и знакомых задач, он активно масштабировал использование модулей убеждений и опыта в тот момент, когда сталкивался с незнакомым окружением или неожиданными препятствиями. Например, если ИИ-агент переносит стандартные записи базы данных, он действует быстро. Когда же он сталкивается со странным устаревшим эндпоинтом API или сложной ошибкой валидации, он замедляет работу, поднимает логи живого сервера и запрашивает историю тикетов, чтобы безопасно разрешить граничный случай, вместо того чтобы гадать наугад.
Внедрение EvoHarness-RL в существующие системы
Несмотря на столь значительные успехи, внедрение нового фреймворка часто создает трудности для корпоративных инженерных команд. Тем не менее, EvoHarness-RL использует адаптер окружения, который позволяет внутренним реализациям оставаться предметно-ориентированными под существующие инструменты организации, одновременно разделяя обучаемый слой.
«Я считаю, что существует огромный потенциал для интеграции BPE в существующие оркестрационные системы, — сказал Нин. — Это необязательно требует от команд замены текущих инструментов или агентских фреймворков. BPE может работать как дополнительный слой управления состоянием, который непрерывно упорядочивает то, во что агент верит в данный момент, насколько далеко он продвинулся и чему он научился».
Для корпоративных разработчиков, обеспокоенных затратами на инференс, фреймворк решает скрытые инженерные издержки на консолидацию. Поскольку консолидация требует развитых способностей к рассуждению, команды могут использовать гибридную асинхронную архитектуру для оптимизации бюджетов.
«Одним из возможных компромиссов является использование передовой модели для генерации высококачественных данных консолидации, с последующей тонкой настройкой способной модели с открытыми весами для обработки рутинного управления состояниями, — пояснил Нин. — Более того, поскольку консолидация может происходить асинхронно, она не всегда должна замедлять основной цикл выполнения агента».
Командам также следует тщательно оценивать, когда обучаемая обвязка BPE действительно необходима, а когда она является избыточной.
«Для короткой и стабильной задачи подходов ReAct или стандартного RAG может быть вполне достаточно, — говорит Нин. — BPE становится гораздо более ценным, когда агент работает в течение многих часов, дней или даже недель». В таких сложных сценариях агенту требуется сжатое понимание своих решений, чтобы не заблудиться, опираясь на опыт для итеративного исправления прошлых ошибок и учета отзывов людей.
В конечном счете этот подход сигнализирует о сдвиге для инженеров по оркестрации ИИ. «Это не полная замена процедурного программирования рабочих процессов, — заключил Нин, — а переход от прямого написания сценариев поведения агента к созданию систем, в которых можно обучить более эффективному поведению».