GPT-5 и Gemini-3 восстанавливают утерянные факты с помощью рассуждений
Источник: VentureBeat · Ben Dickson


Когда большие языковые модели (LLM) галлюцинируют, разработчики обычно предполагают, что у модели отсутствуют необходимые факты. Инженерные команды диагностируют эту ошибку как нехватку знаний. Стандартная реакция заключается в увеличении размера модели, расширении обучающих данных или создании сложных архитектур поиска.
Новое исследование, проведенное учеными из Google Research и Техниона, демонстрирует, что знания часто вовсе не отсутствуют. У модели есть информация, закодированная параметрически, но она не может извлечь ее в процессе генерации.
Их эксперименты показывают, что передовые модели, такие как GPT-5 и Gemini-3, кодируют 95–98% протестированных фактов. Это указывает на то, что во многих случаях именно извлечение информации, а не ее кодирование, является главным узким местом для обеспечения фактической точности.
Понимая, как раскрыть существующие знания с помощью вычислений на этапе инференса, инженерные команды могут создавать более надежные приложения, не полагаясь обязательно на более крупные модели или внешние базы данных.
Профилирование знаний: измерение того, что модели знают на самом деле
Чтобы составить карту этого разрыва между хранением и извлечением, исследователи предлагают сместить фокус оценки с точности на уровне вопросов на профилирование на уровне фактов. Вместо того чтобы просто оценивать, правильно или неправильно LLM отвечает на изолированный запрос, профилирование на уровне фактов проверяет единый базовый фрагмент информации в различных условиях, оценивая, сохранен ли факт в параметрах модели вообще, можно ли сделать запрос к нему с разных направлений и формулировок, а также какие вычислительные усилия требуются для его извлечения.
Этот фреймворк проводит различие между тем, закодирован ли факт параметрически и известен ли он. Модель кодирует факт, если она может точно воспроизвести его при предварительной подготовке с использованием оригинального контекста обучения. Модель знает факт, если она может надежно отвечать на вопросы о нем, используя разнообразные формулировки и направления.
«Ошибки кодирования и извлечения неотличимы друг от друга с точки зрения метрик точности, но они подразумевают разные ограничения и решения, — пишут исследователи. — Ошибки кодирования требуют вмешательства на этапе предварительного обучения, такого как масштабирование размера модели или охвата данных. Ошибки извлечения предполагают вмешательство на этапе после обучения (посттренинга), которое часто улучшает то, как модели используют уже имеющиеся у них закодированные данные».
В статье это иллюстрируется на примере факта: группа Oasis сыграла свой первый концерт в клубе Boardwalk. Основываясь на том, как модели обрабатывают эту информацию, исследование классифицирует знания на пять различных профилей:
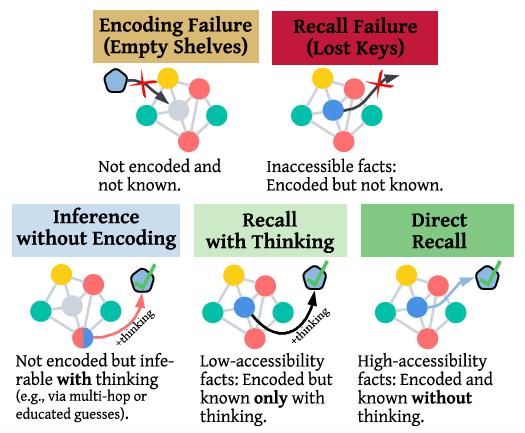
Профилирование знаний (источник: Google)
-
Прямое извлечение: Модель кодирует факт и легко получает к нему доступ для ответа на прямые вопросы без дополнительных затрат вычислений на этапе инференса.
-
Ошибка кодирования (пустые полки): Модель не кодирует и не знает этот факт. Она не может закончить предложение в стиле Википедии о ранних днях Oasis и не может ответить на вопросы об этом событии. Это сигнализирует о необходимости больших данных для предварительного обучения или большей емкости модели.
-
Ошибка извлечения (потерянные ключи): У модели закодирован факт, но она не может получить к нему доступ. Она может легко завершить исходный обучающий текст об Oasis, но не может ответить на вопрос «Где Oasis сыграла свой первый концерт?», даже если ей дать время на раздумья.
-
Извлечение с размышлением: Факт закодирован, но недоступен для прямой генерации. Он успешно извлекается только тогда, когда модель использует вычисления на этапе инференса (например, цепочку рассуждений / Chain-of-Thought), чтобы преодолеть разрыв. Исследователи называют этот механизм облегчением извлечения (recall facilitation). Сначала модель может не справиться с ответом на прямой запрос. Генерируя промежуточные мысли о ранней истории группы в Манчестере, она структурно настраивает себя на обнаружение и извлечение заблокированного ответа.
-
Инференс без кодирования: Модель никогда явно не кодировала факт об Oasis. Вместо этого она успешно отвечает на вопрос, делая обоснованное предположение или сопоставляя другие известные ей закодированные факты. Она может дедуктивно вывести ответ, связав воедино отдельные точки данных, такие как «Oasis образовались в Манчестере», «Boardwalk был там известным музыкальным клубом 90-х» и «Boardwalk принимал ранние концерты начинающих групп».
Иллюзии масштабирования, «длинный хвост» и вспоминание «на кончике языка»
Исследователи оценили 13 LLM на основе более чем 4 миллионов ответов. Они использовали WikiProfile — бенчмарк, содержащий 2150 фактов, извлеченных из Википедии, и протестировали каждый факт в форматах от точного завершения контекста до проверки с множественным выбором.
Для передовых моделей, таких как GPT-5 и Gemini-3, кодирование приближается к насыщению. Эти модели успешно кодируют 95–98% протестированных фактов. Тем не менее, они все еще не могут напрямую извлечь 26–34% этих закодированных фактов без размышлений.
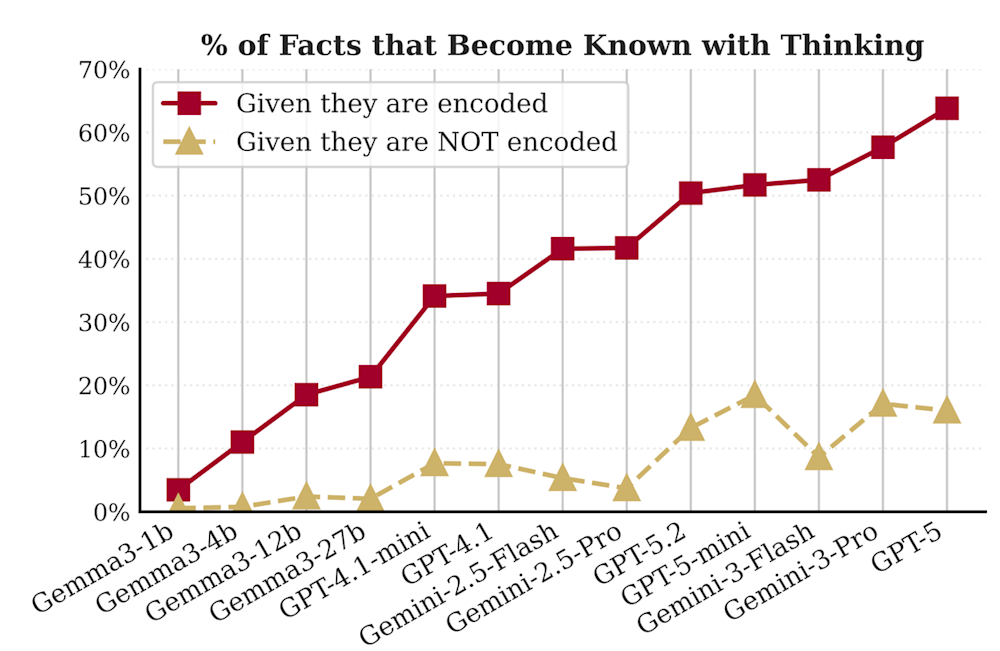
Извлечение с размышлением (источник: Google)
Размышления на этапе инференса выступают в качестве важнейшего механизма восстановления. Предоставление моделям дополнительных вычислительных ресурсов позволяет успешно извлечь 40–65% закодированных фактов, которые модели изначально не могут извлечь напрямую. Исследователи сравнивают это с состоянием человека «на кончике языка», когда целенаправленные усилия, такие как мысленное воссоздание контекста, в конце концов помогают вспомнить информацию.
Масштабирование размера модели автоматически не устраняет этот разрыв. На самом деле компании часто ошибочно пытаются решить проблемы с извлечением путем дообучения (fine-tuning) более крупных внутренних моделей, что является дорогостоящей архитектурной ошибкой.
«Когда факты выдаются неверно, стандартным решением является масштабирование, то есть обучение более крупной модели или добавление большего количества данных, — рассказал VentureBeat Нитай Кальдерон (Nitay Calderon), научный сотрудник Google. — И то, и другое стоит дорого, и если факты уже закодированы, ничто из этого не помогает».
Например, исследователи обнаружили, что масштабирование модели Gemma3 с 1 миллиарда до 27 миллиардов параметров в значительной степени заполнило «пустые полки», снизив количество ошибок кодирования с 85% до 23%. Но в то же время доля ошибок извлечения возросла, достигнув пика в 40% без использования размышлений.
Это говорит о том, что масштабирование в основном решает проблему хранения, а не проблему доступа. Поскольку модель запоминает значительно больше фактов, больший массив знаний оказывается запертым в «закодированном, но недоступном» состоянии. Основная масса ошибок модели смещается от недостающих данных к сбоям извлечения.
«Наши результаты показывают, что извлечение тесно связано с условиями, в которых изучались факты, и ухудшается, когда запросы отклоняются от паттернов времени обучения», — пишут исследователи. То, как пользователь задает вопрос, напрямую определяет, сможет ли модель разблокировать сохраненный ответ.
Например, эксперименты показали, что редкие факты кодируются с той же частотой, что и популярные. Тем не менее, исследователи обнаружили большой разрыв в извлечении между малопопулярными («длинный хвост») и крайне популярными фактами, который для передовых моделей превышает 25%.
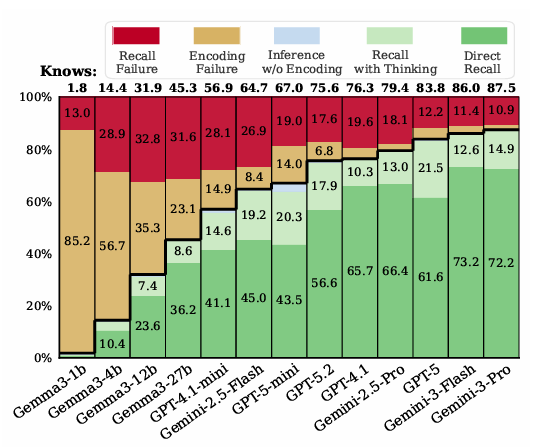
Распределение профилей знаний по различным LLM (источник: Google)
Аналогичным образом, модели испытывают трудности с генерацией ответов на обратные вопросы (т. е. когда запрашивается субъект вместо объекта). Например, модель может легко ответить, что Oasis сыграли свой первый концерт в клубе Boardwalk, но не сможет ответить, кто именно сыграл свой первый концерт в этом же клубе. В то же время те же модели показывают, что знают правильный ответ, если им задать тот же вопрос в формате с множественным выбором.
«Хотя эти сбои часто интерпретируются как ограничения запоминания или двунаправленного кодирования, наши результаты рисуют иную картину: редкие факты часто закодированы, но недоступны, а обратные факты могут быть распознаны даже тогда, когда они не могут быть сгенерированы, — пишут исследователи. — Это переосмысливает оба явления как сбои извлечения, а не как „отсутствие знаний“».
Рентабельность (ROI) мышления и советы для разработчиков
Высокие показатели кодирования у передовых моделей требуют изменения того, как разработчики подходят к вопросу фактической точности и архитектуре конвейаров (пайплайнов).
Не воспринимайте каждый сбой фактологической точности как проблему поиска: Реакция бизнеса на галлюцинации по умолчанию часто заключается в развертывании генерации с дополненной выборкой (RAG), масштабировании векторных баз данных или загрузке большего количества корпоративных документов. Хотя RAG — это правильное решение для свежих или внутренних данных, использование его в качестве универсального исправления галлюцинаций добавляет задержки и затраты для фактов, которые модель уже заблокировала в своей параметрической памяти.
«Многие проблемы, которые команды решают с помощью RAG, связаны с фактами, на которые модель уже может ответить из памяти, так что вы платите лишнюю задержку и стоимость за каждый вызов ни за что, — сказал Кальдерон. — Если факт действительно отсутствует, RAG может быть правильным решением. Но если факт закодирован, а модель просто не может его извлечь, RAG и масштабирование модели лишь увеличивают затраты поверх реальной проблемы».
Используйте рассуждения на этапе инференса выборочно: Мышление восстанавливало 40–65% закодированных фактов, которые модели не могли извлечь напрямую. Однако, поскольку только 10–20% фактов действительно требуют размышлений, включение этой функции повсеместно растрачивает ваш вычислительный бюджет. Задача состоит в динамической маршрутизации запросов, поскольку у моделей нет достаточного самосознания, чтобы надежно диагностировать, когда они собираются дать сбой.
«Чтобы эффективно использовать вычисления, модель должна заранее чувствовать, что простой ответ собирается провалиться, чтобы она могла эскалировать проблему до ответа, — сказал Кальдерон. — Такое самосознание является отдельным навыком, и современные модели пока не надежно справляются с ним». Именно это метакогнитивное узкое место заставляет исследователей Google разрабатывать такие фреймворки, как «достоверная неопределенность» (faithful uncertainty), позволяющие моделям точно оценивать собственную уверенность и запускать более глубокие рассуждения вместо галлюцинаций.
Развертывайте конвейеры «генерация-с-проверкой» (generate-then-verify): Поскольку модели лучше распознают факты (верификация), чем генерируют их с нуля, разработчики могут создавать архитектурные циклы, в которых модель генерирует ответ, а затем получает запрос на явное осмысление и проверку собственных утверждений. «Поскольку распознать правильный ответ проще, чем сгенерировать его, этап проверки выходных данных самой модели может выявить ошибки, которые пропускает простая генерация, и обеспечить дополнительное повышение точности», — отметил Кальдерон.
Тестируйте семантический доступ, а не только точность бенчмарков: Стандартные метрики точности маскируют скрытые возможности модели. Наборы для оценки должны проверять один и тот же базовый факт с помощью различных формулировок, контекстов и направлений, чтобы по-настоящему понять, что модель знает в сравнении с тем, к чему она может надежно получить доступ.
Используйте переформулирование запросов и повторные попытки: Поскольку процесс извлечения сильно зависит от контекста, структура запроса определяет успех. Изменение структуры промпта, генерация релевантного промежуточного контекста или побуждение модели сформировать цепочку рассуждений перед ответом — это законные механизмы обеспечения надежности, которые выводят на поверхность информацию, пропускаемую прямыми запросами.
Ограничения и практические выводы
Бенчмарк WikiProfile опирается на энциклопедические факты из Википедии. Эти выводы могут не идеально экстраполироваться на проприетарные или высокоспециализированные корпоративные домены. Способность модели хранить и извлекать нишевую внутреннюю метрику компании может отличаться от ее работы с публичными энциклопедическими данными.
Полное профилирование передовой модели с использованием набора WikiProfile стоит примерно 500 долларов. Разработчики могут значительно снизить эту стоимость, исключив варианты с множественным выбором или используя меньше примеров ответов на один вопрос.
Команды могут получить доступ к бенчмарку WikiProfile на Hugging Face для оценки собственных систем. Поскольку бенчмарк включает в себя точные промпты, использованные для его создания, команды корпоративной инженерии данных могут воссоздать этот конвейер на собственных внутренних корпусах, чтобы диагностировать, страдают ли их специализированные агенты от нехватки данных или от утерянных ключей. Тем не менее, команды должны соразмерять свои ожидания при уходе от энциклопедических данных.
«Конвейер создан для применения на новом корпусе, и мы предоставляем все использованные промпты, — сказал Кальдерон. — Единственное, к чему стоит быть готовым: в Википедии это была в основном проблема извлечения. Доменно-специфичные факты действительно могут быть не закодированы в модели».
В конечном счете, этот сдвиг в сторону использования знаний уравнивает шансы для стеков корпоративного ИИ. «Для компаний, которые не создают модели с нуля, это хорошая новость, — резюмировал Кальдерон. — Предварительное обучение чрезвычайно дорого и недоступно для большинства, но рычаги, которые имеют значение сейчас, вполне доступны: посттренинг может помочь при небольшом количестве данных и шагов, а такие инструменты этапа инференса, как мышление, этапы проверки и поиск, уже используются большинством команд».
Эта статья была обновлена и дополнена комментариями от Google.