


Контекстный разрыв у ИИ-агентов: 57% ошибаются
Источник: VentureBeat · Sean Michael Kerner


Корпоративный ИИ-агент отвечает с абсолютной уверенностью, но цифра оказывается неверной. Никто этого не замечает, пока кто-нибудь не проследит всю цепочку до устаревшего определения метрики или документа, который поисковая система никогда не извлекала. Модель не дала сбой. Сбой дал предоставленный ей контекст.
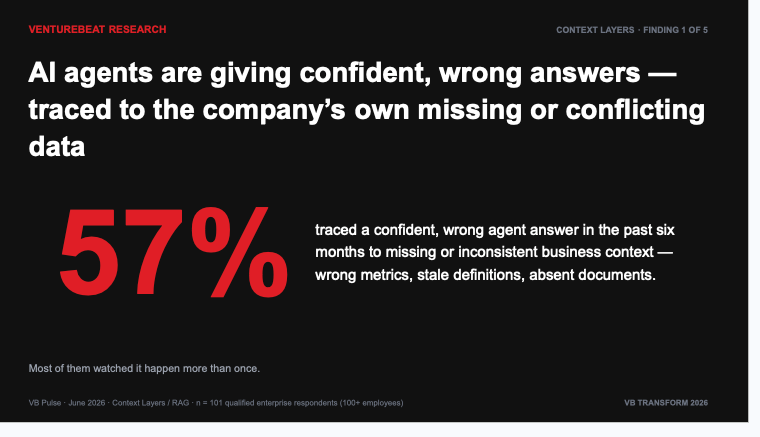
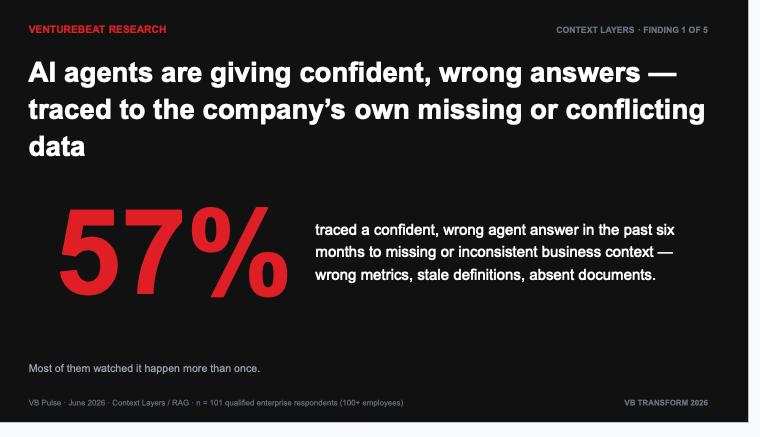
Согласно июньскому опросу VB Pulse 2026 года, охватившему 101 квалифицированное предприятие со штатом более 100 сотрудников, за последние шесть месяцев 57% компаний столкнулись с ситуацией, когда уверенный, но неверный ответ ИИ-агента был обусловлен отсутствием или несогласованностью бизнес-контекста, причем 31% респондентов отметили, что это происходило более одного раза.
Источник: опрос VB Pulse, июнь 2026 г.
Причину найти несложно. Поиск по документам является основным способом получения бизнес-контекста для агентов у 38% предприятий — это почти вдвое превышает показатель следующего по популярности подхода. Проблема усугубляется тем, как большинство компаний выбирают поисковую систему. Простота загрузки данных и операционная легкость лидируют среди критериев отбора, в то время как точность поиска отстает от обоих параметров. Проблема с точностью проявляется только после того, как система уже запущена в работу.
Существует известное решение этой проблемы: управляемый уровень контекста, из которого каждый агент черпает информацию, вместо того чтобы гадать. Вендоры наперебой стремятся внедрить контекстные платформы, в то время как большинство предприятий все еще пытаются понять, что это такое.
У 75% компаний до сих пор нет агентичного уровня контекста
Уровень контекста призван служить единой моделью того, что на самом деле означают бизнес-данные. Он создается один раз и используется постоянно, исключая необходимость повторного вычисления каждым обращающимся к нему агентом.
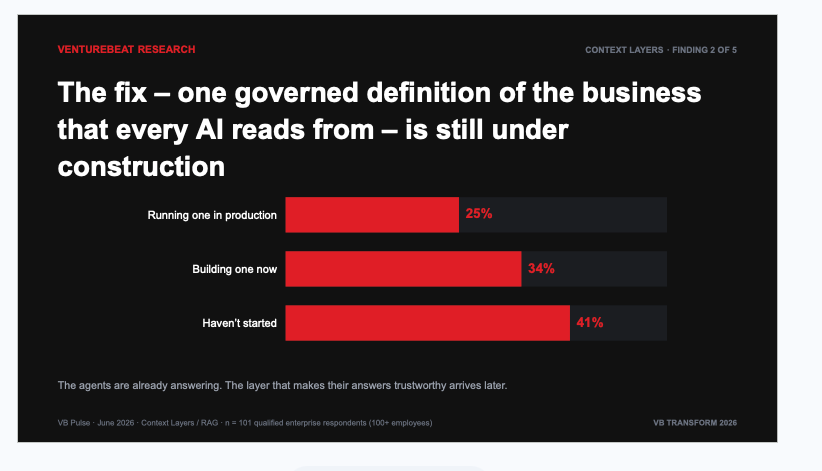
Исследование VentureBeat показывает, что реакция бизнеса на эту идею широка, но еще не до конца оформлена. Двадцать пять процентов респондентов уже используют такое решение в рабочей среде. Тридцать четыре процента занимаются его разработкой прямо сейчас. Оставшиеся 41% еще даже не приступали к этому.
Среди компаний, которые уже создают или используют управляемый уровень контекста, 78% сообщают об ошибках типа «уверен и неправ» — когда ИИ-агент отвечает с полной уверенностью, но все равно ошибается. Среди компаний, не планирующих создавать такой уровень, о подобном сообщают лишь 20%. Компании, которые уже обожглись, гораздо чаще занимаются созданием исправления. Те же компании, которые еще не сталкивались с проблемами, не видят никакой срочности.
Источник: опрос VB Pulse, июнь 2026 г.
Как выглядит управляемый контекст, когда его действительно создают
Каждый крупный поставщик данных и ИИ-платформ в настоящее время разрабатывает ту или иную версию этого слоя, и они не приходят к единой архитектуре.
-
DataHub рассматривает метаданные каталога и многолетнюю историю запросов аналитиков как источник знаний, поддерживая их в актуальном состоянии как живую систему, а не как статическую вики.
-
Платформа Fabric IQ от Microsoft строит бизнес-онтологию, к которой через протокол MCP может обращаться любой агент, а не только собственный ИИ Microsoft.
-
Couchbase переносит память агентов и извлечение контекста на периферию (edge), утверждая, что операционная база данных является более естественной средой для этого, чем поисковый или аналитический уровень, добавленный постфактум.
-
Система Nexus от Pinecone компилирует структурную логику в слой метаданных еще до запуска во время выполнения (runtime), делая ставку на то, что агентам больше нужна предварительно построенная структура, чем ускоренный поиск.
-
Snowflake использует двухуровневую систему: Horizon Context для определений, управляемых клиентом, и Cortex Sense для контекста, который платформа выводит самостоятельно.
-
Unified Memory Core от Oracle использует противоположный подход, объединяя векторные, графовые и реляционные данные в единый транзакционный движок, благодаря чему не остается устаревающего слоя синхронизации.
-
Knowledge Catalog от Google анализирует журналы запросов и шаблоны использования для автоматического формирования семантического контекста.
-
Сервис Context от AWS делает аналогичную ставку: это граф знаний, который становится умнее благодаря реальному использованию агентами, а не за счет ручной кураторской правки.
Аналитики сходятся в едином диагнозе
Подходы вендоров различаются. Однако то, что аналитики и практики рассказали VentureBeat об основополагающей проблеме в ходе череды интервью в этом году, остается неизменным.
Когда этой весной был представлен контекстный слой от DataHub, вице-президент и главный аналитик Constellation Research Майкл Ни охарактеризовал текущие ставки предельно прямо. «Кто контролирует контекст выполнения, тот контролирует уровень принятия ИИ-решений для корпоративных данных», — заявил Ни. Он был столь же категоричен в отношении того, насколько далеко отдельный продукт может продвинуть покупателя. «Векторная память — это не бизнес-смысл, бизнес-смысл — это не управление (governance), а управление — это не исполнение», — отметил Ни.
В том же интервью аналитик BARC Кевин Петри указал на более узкий, но конкретный пробел. По его словам, большинство контекстных платформ сосредоточено на структурированных таблицах, которые предоставляют агентам проверенные факты, но упускают более сложный, хаотичный контекст, скрытый в документах и неструктурированном контенте — то есть именно в том материале, на котором бизнес фактически функционирует изо дня в день.
Стефани Вальтер, руководитель практики AI Stack в HyperFRAME Research, высказала схожую мысль ранее в этом году, когда VentureBeat спросил ее о фрагментации корпоративного контекста.
«Рынок приходит к общему выводу, — сказала Вальтер. — Агентам нужно не просто больше токенов или лучшие модели. Им нужен управляемый, актуальный контекст с низким временем отклика». Она высказала аналогичную точку зрения в недавнем обзоре запуска Nexus от Pinecone, стараясь не преувеличивать новизну происходящего. По ее словам, Nexus «переводит работу со знаниями от хаоса во время выполнения к предварительно скомпилированной структуре. Но это эволюция архитектуры RAG, а не ее полное переосмысление».
Арун Чандрасекаран из Gartner, оценивая тот же запуск, дал более дальнозоркий комментарий. Агентичный ИИ, по его словам, движется от чистого извлечения информации к архитектуре рассуждений, в которой длинный контекст работает как кратковременная память, а векторная база данных функционирует как глубинное хранилище под ней.
Проблема фрагментации острее всего проявляется на уровне практиков, где отдельные инструменты для поиска, работы с памятью и контроля доступа изначально не были созданы для того, чтобы взаимодействовать друг с другом. Стивен Диккенс, генеральный директор и главный аналитик HyperFRAME Research, выразился предельно прямо после весеннего <анонса базы данных ИИ от Oracle> (Oracle’s AI database push). «Команды работы с данными измотаны усталостью от фрагментации, — заявил Диккенс. — Управление отдельным векторным хранилищем, графовой базой данных и реляционной системой только ради запуска одного агента — это настоящий кошмар для DevOps».
Мэтт Кимбалл из Moor Insights and Strategy в той же статье описал реальность продакшена гораздо проще. По его словам, заставить агента работать — вовсе не самая сложная задача. Трудность заключается в его запуске в промышленной эксплуатации, где целью становится сокращение дистанции между данными и их выполнением, а не добавление еще одного слоя поверх уже существующих.
Что это означает для предприятий
Вот к каким выводам это подводит предприятия, строящие свои системы на базе этого слоя.
Само по себе извлечение данных (retrieval) не устранит пробел в контексте. На сегодняшний день RAG является стандартным источником контекста для большинства предприятий, и именно с ним наиболее тесно связаны ошибки типа «уверен и неправ». Добавление новых документов или большего индекса не исправит определение, которое непоследовательно применяется в разных системах.
Источник: опрос VB Pulse, июнь 2026 г.
Бюджеты реально смещаются в сторону слоя семантического контекста, даже если он еще не развернут. 58% предприятий уже вовлечены в процесс — либо разрабатывают решение, либо используют его в продакшене, — но лишь 25% фактически запустили уровень в работу. Этот разрыв показывает, куда предприятия решили направить инвестиции, а не то, куда они уже успели прийти.
Ни один отдельный вендор пока не монополизировал архитектуру, и эта ситуация, скорее всего, сохранится еще некоторое время. Предприятиям, оценивающим этот уровень, следует рассчитывать на интеграцию, а не на выбор единственного победителя — по крайней мере, в течение нескольких следующих кварталов.
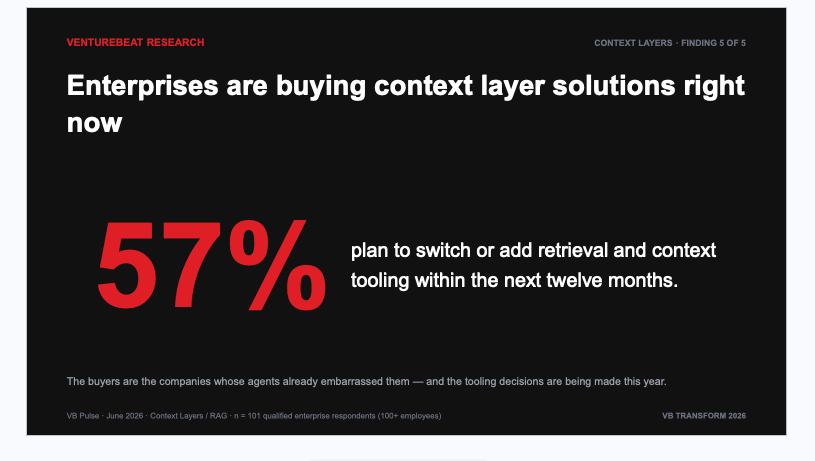
Решение о покупке принимается в текущем году, и оно сосредоточено среди компаний, которые уже обожглись на этой проблеме. 57% предприятий планируют сменить или внедрить поисковую или контекстную платформу в течение следующих двенадцати месяцев. Это намерение распределено неравномерно. Среди компаний, сообщивших о повторяющихся ошибках типа «уверен и неправ», сменить или добавить провайдера планируют около 81%, в то время как среди компаний, никогда не сталкивавшихся с этой проблемой, этот показатель составляет 32%. Компании, которые прямо сейчас ищут новые инструменты для работы с контекстом — это в основном те, чьи агенты уже допустили ошибки.
Агенты уже запущены в работу. Контекст под большинством из них все еще строится, а вендор, продающий решение для его исправления, выбирается именно в этом году.
Эти данные станут частью более широкой дискуссии на конференции VB Transform 2026, которая пройдет 14 и 15 июля в Менло-Парке: речь пойдет о контекстном разрыве, который предприятия спешат устранить, и о том, какие из возникающих подходов — управляемые семантические слои, гибридный поиск, нативные пакеты провайдеров — действительно жизнеспособны в производственной среде.




