


Google представляет Agentic Data Cloud на конференции Cloud Next
Источник: VentureBeat · Sean Michael Kerner


Корпоративные стеки данных создавались для людей, запускающих запросы по расписанию. Поскольку ИИ-агенты все чаще действуют автономно от имени бизнеса круглосуточно, эта архитектура устаревает, и вендоры спешат ее пересоздать. Ответом от Google, о котором было объявлено в среду на конференции Cloud Next, стал Agentic Data Cloud.
Архитектура опирается на три кита:
-
Каталог знаний (Knowledge Catalog). Автоматизирует кураторство семантических метаданных, выводя бизнес-логику из журналов запросов без ручного вмешательства специалистов по управлению данными.
-
Мерохранилище (lakehouse) с поддержкой мультиоблачности. Позволяет BigQuery запрашивать таблицы Iceberg в AWS S3 по частной сети без платы за исходящий трафик.
-
Набор инструментов для агентов данных (Data Agent Kit). Добавляет инструменты MCP в VS Code, Claude Code и Gemini CLI, позволяя инженерам по данным описывать результаты вместо написания конвейеров.
«Архитектура данных должна измениться прямо сейчас, — рассказал VentureBeat Анди Гутманс (Andi Gutmans), вице-президент и генеральный директор подразделения Data Cloud в Google Cloud. — Мы переходим от человеческого масштаба к масштабу агентов».
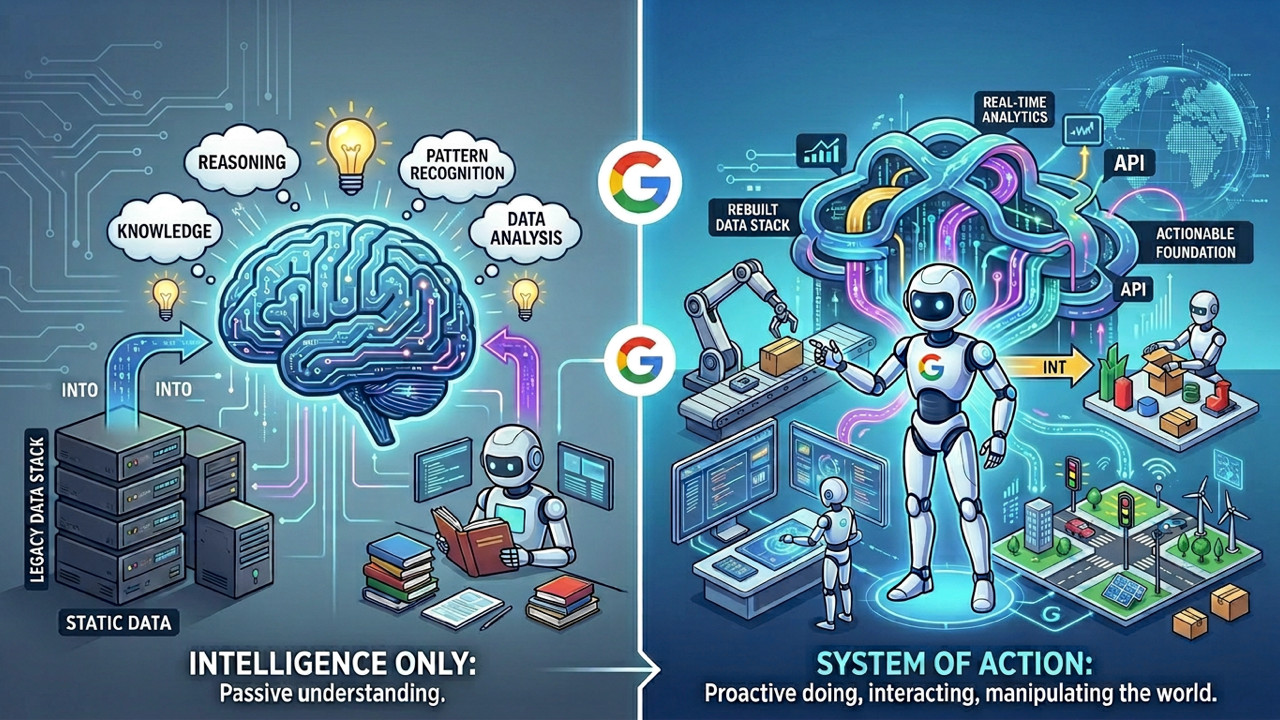
От системы интеллекта к системе действия
Главная предпосылка создания Agentic Data Cloud заключается в том, что предприятия переходят от операций в человеческом масштабе к операциям в масштабе агентов.
Исторически платформы данных оптимизировались под отчетность, создание дашбордов и некоторое прогнозирование — то, что Google характеризует как «реактивный интеллект». В этой модели люди интерпретируют данные и решают, что делать.
Теперь, когда от ИИ-агентов все чаще ожидают принятия мер напрямую от имени бизнеса, Гутманс заявил, что платформы данных должны эволюционировать в системы действия.
«Нам нужно убедиться, что все корпоративные данные могут быть задействованы с помощью ИИ, включая как структурированные, так и неструктурированные данные, — отметил Гутманс. — Нам необходимо обеспечить должный уровень доверия, а это означает не просто получение доступа к данным, но и их реальное понимание».
Каталог знаний — это ответ Google на данную проблему. Он представляет собой эволюцию Dataplex (существующего продукта Google по управлению данными) с принципиально иной внутренней архитектурой. Если традиционные каталоги данных требовали от специалистов вручную размечать таблицы, определять бизнес-термины и создавать глоссарии, то Каталог знаний автоматизирует этот процесс с помощью агентов.
Практическое значение для инжиниринговых команд заключается в том, что Каталог знаний масштабируется на весь массив данных, а не только на ту отобранную подмножество-часть, которую небольшая команда дата-стюардов может поддерживать вручную. Каталог изначально охватывает BigQuery, Spanner, AlloyDB и Cloud SQL, а также объединяется со сторонними каталогами, включая Collibra, Atlan и Datahub. Федерация без копирования данных (zero-copy federation) расширяет семантический контекст из SaaS-приложений, включая SAP, Salesforce Data360, ServiceNow и Workday, без необходимости перемещения данных.
Озерехранилище Google выходит в мультиоблачное пространство
У Google есть озерное хранилище данных под названием BigLake, появившееся еще в 2022 году. Сначала оно ограничивалось только данными Google, но в последние годы получило некоторые ограниченные возможности федерации, позволяющие предприятиям запрашивать данные, находящиеся в других местах.
Гутманс пояснил, что предыдущая федерация работала через API запросов, что ограничивало функции и возможности оптимизации, которые BigQuery мог применять к внешним данным. Новый подход основан на совместном использовании на уровне хранилищ с помощью открытого формата Apache Iceberg. Это означает, что независимо от того, находятся ли данные в Amazon S3 или в Google Cloud, разницы нет, утверждает он.
«Это действительно означает, что мы можем перенести все преимущества и все возможности искусственного интеллекта на те сторонние наборы данных», — сказал он.
Практический результат заключается в том, что BigQuery может запрашивать таблицы Iceberg, размещенные на Amazon S3, через Google Cross-Cloud Interconnect (выделенный частный сетевой уровень) без платы за исходящий трафик и с соотношением цены и производительности, которое, по заявлению Google, сопоставимо с нативными хранилищами AWS. Все функции ИИ в BigQuery работают с этими кросс-облачными данными без изменений. Двусторонняя федерация, находящаяся в режиме предварительного просмотра, распространяется на Databricks Unity Catalog на S3, Snowflake Polaris и AWS Glue Data Catalog с использованием стандартного открытого каталога Iceberg REST Catalog.
От написания конвейеров к описанию результатов
Каталог знаний и мультиоблачное озерное хранилище решают проблемы доступа к данным и контекста. Второй компонент касается того, что происходит, когда дата-инженер садится за создание чего-либо с использованием всего этого.
Data Agent Kit поставляется как переносной набор навыков, инструментов MCP и расширений для IDE, которые интегрируются в VS Code, Claude Code, Gemini CLI и Codex. Он не вводит новый интерфейс.
Архитектурный сдвиг, который он обеспечивает, — это переход от того, что Гутманс назвал «предписывающим опытом работы с вторым пилотом (copilot experience)», к проектированию на основе намерений. Вместо написания конвейера Spark для перемещения данных из источника А в пункт назначения Б инженер по данным описывает результат — очищенный набор данных, готовый для обучения модели, или преобразование, реализующее правило управления, — а агент выбирает, использовать ли BigQuery, Lightning Engine для Apache Spark или Spanner для выполнения задачи, после чего генерирует готовый к работе код.
«Клиентам уже порядком надоело самим строить свои конвейеры, — заявил Гутманс. — Они действительно находятся скорее в режиме проверки, чем в режиме написания кода».
В чем расходятся пути Google и ее конкурентов
Мнение о том, что агентам требуется семантический контекст, а не просто доступ к данным, разделяется всем рынком.
У Databricks есть Unity Catalog, обеспечивающий управление и семантический уровень на базе их озерного хранилища. У Snowflake есть Cortex — предложение на базе искусственного интеллекта и семантического слоя. Microsoft Fabric включает слой семантических моделей, созданный для бизнес-аналитики и, все чаще, для привязки агентов.
Спор идет не о том, важна ли семантика — все согласны с тем, что это так. Спор идет о том, кто ее создает и поддерживает.
«Наша цель — получить всю семантику, какую только можно», — пояснил он, отметив, что Google будет объединяться со сторонними семантическими моделями, а не заставлять клиентов начинать всё заново.
Google также позиционирует открытость как фактор дифференциации, предлагая двустороннюю федерацию с Databricks Unity Catalog и Snowflake Polaris через стандарт открытого каталога Iceberg REST Catalog.
Что это значит для бизнеса
Аргумент Google — и он находит отклик на рынке инфраструктуры данных — заключается в том, что предприятия отстают по трем направлениям:
Семантический контекст становится инфраструктурой. Если ваш каталог данных по-прежнему наполняется вручную, он не сможет масштабироваться под рабочие нагрузки агентов, и, по мнению Гутманса, этот разрыв будет только увеличиваться по мере роста объемов запросов агентов.
Расходы на исходящий кросс-облачный трафик — это скрытый налог на агентный ИИ. Федерация на основе хранилищ с использованием открытых стандартов Iceberg становится архитектурным ответом для Google, Databricks и Snowflake. Предприятия, привязанные к проприетарным подходам к федерации, должны протестировать эти затраты на объемах запросов в масштабе агентов.
Гутманс утверждает, что эпоха написания конвейеров подходит к концу. Инженеры по данным, которые уже сейчас переходят на оркестрацию на основе результатов, получат значительное преимущество.




