


Контекстная архитектура приходит на смену RAG в сфере ИИ
Источник: VentureBeat · Sean Michael Kerner


Redis заслужила репутацию инструмента кэширования, который спасал веб-приложения от падения под нагрузкой. Проблему, которую компания решает сейчас, отличает та же структура, но справиться с ней сложнее: производственные ИИ-агенты дают сбой не потому, что модели ошибаются, а потому, что лежащие в их основе данные разрознены, устарели и структурированы скорее для людей, чем для машин. Конвейеры поиска (retrieval pipelines), созданные под одиночные запросы, не справляются с объемами, которые генерируют агенты.
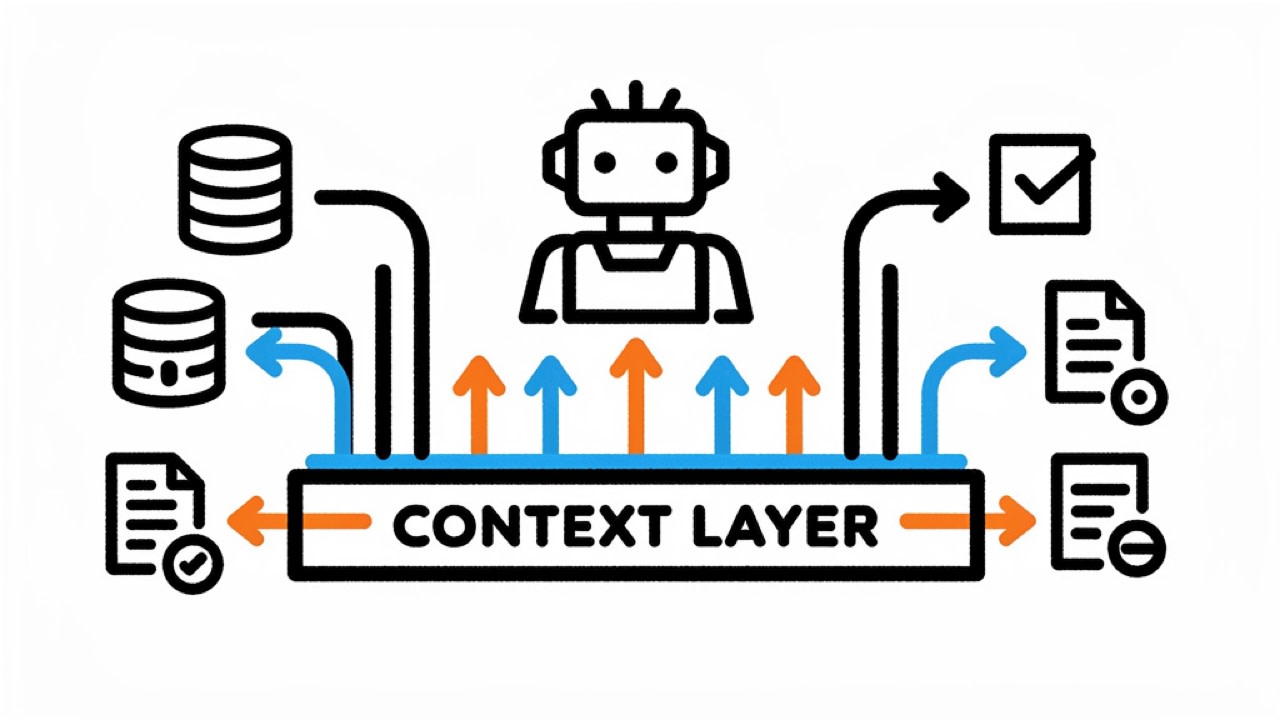
Пробел, на который нацелена Redis, носит структурный характер: агенты делают на порядки больше запросов к данным, чем человеческие пользователи, однако большинство поисковых слоев создавались для задач человеческого масштаба. Представленная в понедельник платформа Redis Iris — это ответ компании: платформа контекста и памяти, располагающаяся между агентом и данными, необходимыми ему для работы. Платформа объединяет в себе прием данных в реальном времени, семантический интерфейс, который автоматически генерирует MCP-инструменты из моделей бизнес-данных, а также сервер памяти агентов на базе Redis Flex — переписанного хранилища, которое выполняет 99% операций с данными на flash-накопителях при стоимости, составляющей десятую часть от затрат на исключительно оперативную память.
Анонс появился в момент активной трансформации корпоративной инфраструктуры RAG (генерации, дополненной поиском). Исследование рынка инфраструктуры RAG VB Pulse за I квартал 2026 года, проведенное VentureBeat, показало, что интерес покупателей к внедрению гибридного поиска утроился с 10,3% до 33,3% в период с января по март. Оптимизация поиска впервые обошла оценку (evaluation) в качестве главного приоритета корпоративных инвестиций. Доля заказных внутренних стеков поиска выросла с 24,1% до 35,6% по мере того, как предприятия переросли готовые коробочные решения. Redis — не единственный инфраструктурный вендор, уловивший эти сигналы: за последние недели сразу несколько поставщиков платформ данных переориентировались на создание слоев контекста для агентов.
Несоответствие масштабов служит главным структурным аргументом в пользу запуска.
«У компаний будут на порядки больше агентов, чем людей, — заявил в интервью VentureBeat Роуэн Троллоп (Rowan Trollope), генеральный директор Redis. — На порядки больше агентов, чем людей, означает на порядки большую нагрузку на бэкенд-системы».г
От кэша к контексту
Троллоп проводит параллель с эпохой мобильных устройств: когда устаревшие бэкенды, созданные для операционистов в отделениях банков, внезапно потребовали обслуживания миллионов владельцев смартфонов, именно Redis стала уровнем кэширования, который принял на себя эту нагрузку без необходимости полной перестройки системы.
Разница на этот раз заключается в том, что агенты не могут сами писать свое промежуточное ПО (middleware). В эпоху мобильных устройств разработчик садился с администратором базы данных, определял необходимые приложению запросы и жестко прописывал логику кэширования в слое middleware. Агенты не способны на это. Им нужно находить нужные данные во время выполнения (runtime) с помощью заранее созданных для них интерфейсов, иначе они зависнут.
«Здесь напрашивается аналогия с продуктовым магазином в вашем холодильнике, — отметил он. — Если каждый раз, когда вам нужно сделать бутерброд, вам приходится бежать за едой в супермаркет, это не очень эффективно. Вы ставите холодильник в каждом доме, храните там немного еды. И в некотором роде мы все еще существуем именно на этом уровне инфраструктурного стека».
Что входит в состав Redis Iris
Iris поставляется с пятью компонентами, которые в совокупности охватывают прием данных, семантический доступ, память и кэширование.
Redis Data Integration. Теперь доступен широкой общественности (general availability). RDI использует конвейеры изменения данных (change data capture) для непрерывной синхронизации данных из реляционных баз данных, хранилищ и хранилищ документов в Redis, предлагая коннекторы для Oracle, Snowflake, Databricks и Postgres.
Context Retriever. Находится в стадии предварительного просмотра (preview). Разработчики определяют семантическую модель бизнес-данных с помощью моделей pydantic, а Redis автоматически генерирует MCP-инструменты, которые агенты используют для прямых запросов к ней, причем элементы управления доступом на уровне строк принудительно применяются на стороне сервера. Троллоп описывает этот переход от классического RAG как инверсию направления. «Это просто разворот, позволяющий агенту самому забирать данные, вместо того чтобы предполагать и заранее заталкивать их в конвейер», — пояснил он.
Agent Memory (Память агентов). Находится в стадии предварительного просмотра. Хранит краткосрочное и долгосрочное состояние между сеансами, благодаря чему агенты сохраняют контекст без необходимости вычислять его заново на каждом шаге.
Redis Flex. Переписанный механизм хранения, который обрабатывает 99% данных на SSD и 1% в оперативной памяти (RAM), обеспечивая поиск в масштабе петабайт с задержками менее чем в миллисекунду.
Redis Search и LangCache. Поисковая и семантическая кэширующая основа платформы. LangCache сокращает количество избыточных вызовов моделей за счет кэширования ответов на промпты.
Что говорят аналитики
В настоящее время индустрия данных в целом движется в том же направлении. Каждый крупный производитель баз данных выступает с концепцией слоя контекста.
Традиционные разработчики баз данных, включая Oracle, интегрируют слои контекста и памяти, чтобы перенести реляционные базы данных в эпоху агентского ИИ. Специализированные производители векторных баз данных, в том числе Pinecone, делают то же самое, создавая новый уровень знаний для контекста агентского ИИ. Автономные слои контекста, такие как Hindsight, также являются частью формирующегося ландшафта.
Троллоп описывает позицию Redis как структурно отличную от конкурентов.
«Чтобы мы выиграли, никому другому проигрывать не нужно», — заявил он. Многие развертывания Redis уже используют MongoDB или Oracle в качестве бэкенд-систем учета. Iris зеркалирует и кэширует данные из этих систем, а не вытесняет их. Redis запускает Iris на маркетплейсе Snowflake с нативными коннекторами.
Стефани Вальтер (Stephanie Walter), руководитель практики по стеку ИИ в HyperFRAME Research, четко описывает рыночный контекст. «Рынок приходит к единому выводу: агентам нужны не просто дополнительные токены или лучшие модели. Им нужен регулируемый, актуальный и низколатентный контекст», — отметила Вальтер.
Ее оценка конкурентных преимуществ Redis сосредоточена на том, какое место Redis уже занимает в стеке — близко к среде выполнения, к оперативным состояниям, чувствительным к задержкам, и данным в реальном времени.
«Суть предложения не столько в „лучшем RAG“, сколько в том, что „агентам нужны живой контекст, память и быстрый поиск прямо во время их работы“, — сказала она.
Независимо от того, идет ли речь о Redis или другом вендоре, для успеха любой технологии контекстного слоя придется столкнуться с проблемой управления (governance).
«Агентский ИИ не получит масштабного распространения на предприятиях, если каждый агент станет новым центром затрат, новым риском доступа к данным и новым исключением из правил управления, — подчеркнула она. — Победителями среди слоев контекста станут те, которые сделают агентов быстрее, дешевле и безопаснее в работе».
Для клинического ИИ в реальном времени ошибка в контексте недопустима
Mangoes.ai — одна из компаний, которой уже пришлось ответить на эти вопросы в реальной работе, в условиях, когда цена ошибки в контексте измеряется исходом лечения пациента.
Амит Ламба (Amit Lamba), основатель и генеральный директор Mangoes.ai, управляет голосовой ИИ-платформой реального времени, развернутой в крупных медицинских учреждениях, где пациенты и врачи задают вопросы о лечении, расписании и истории болезни в режиме Live. С самого начала компания Mangoes.ai строила свой стек на базе Redis.
«Поиск, память и состояние сеанса — все это работает через Redis, поэтому нам не нужно сшивать вместе разрозненные инструменты и надеяться, что они смогут взаимодействовать друг с другом», — поясняет Ламба.
Проблема, которую решает возможность динамической памяти Iris, заключается в том, что происходит в течение сложного сеанса.
«Представьте себе часовой сеанс групповой терапии, — говорит Ламба. — Вам нужно знать, кто и что сказал, в какой момент, и уметь вовремя предоставить нужную информацию терапевту. Это сложная задача поиска».
Платформа запускает несколько специализированных агентов параллельно: один для идентификации сущностей, один для рассуждений о связях и один для интеграции истории болезни.
«Возможность динамической памяти практически идеально ложится на решаемую нами проблему», — резюмировал Ламба.
Что это значит для бизнеса
Для предприятий, построивших свой стек ИИ вокруг RAG, поисковый уровень, который позволил им выйти на этап промышленной эксплуатации, уже недостаточен для удержания позиций.
Эпоха RAG уступает место архитектуре контекста. Классическая модель RAG «заталкивала» данные в агента до вызова модели. В производственных развертываниях этот подход меняется на противоположный: агенты запрашивают то, что им нужно, во время выполнения с помощью вызовов инструментов, рассматривая уровень данных как живой ресурс, а не как предварительно загруженный пакет. Команды, которые до сих пор оптимизируют конвейеры RAG, решают проблему прошлого года.
Семантический уровень теперь является частью производственной инфраструктуры. Модель, определяющая бизнес-сущности, их связи и правила доступа между ними, должна создаваться, версионироваться и поддерживаться с той же дисциплиной, что и конвейер данных. Большинство организаций еще не укомплектованы кадрами и не структурированы для такой работы. Те компании, которые определят свою контекстную архитектуру сейчас, не столкнутся с необходимостью перестраивать ее при масштабировании рабочих нагрузок агентов.
Бюджеты уже перераспределяются. Данные VB Pulse за I квартал 2026 года показывают рост инвестиций в оптимизацию поиска с 19% до 28,9% в течение квартала, что впервые опередило расходы на оценку (evaluation). Организации, которые в предыдущем году измеряли качество поиска, теперь тратят средства на его исправление. Уровень контекста стал предметом активных закупок, а не пунктом в дорожной карте.
«Первый вопрос покупателя должен звучать не так: „Нужна ли мне векторная база данных, длинный контекст, память или контекстный движок?“, а так: „Что этот агент должен знать, насколько свежими должны быть эти знания, кому разрешен доступ к ним и во сколько обходится каждый поиск?“» — заключила Вальтер.




