


Переработка корпоративных систем RAG: в первом квартале 2026 года внедрение гибридного поиска утроилось
Источник: VentureBeat · Sean Michael Kerner


В корпоративных системах RAG в первом квартале 2026 года произошел перелом. Данные VB Pulse за период с января по март рассказывают единую историю: рынок перестал наращивать уровни извлечения данных (retrieval layers) и начал исправлять те, что уже имеются. Назовем это масштабной перестройкой извлечения.
Опрос охватывал три последовательные месячные волны среди организаций со штатом от 100 сотрудников, при этом ежемесячно насчитывалось от 45 до 58 квалифицированных респондентов по таким направлениям, как внедрение платформ, намерения покупателей, перспективы архитектуры и критерии оценки. Полученные данные следует рассматривать как индикативные.
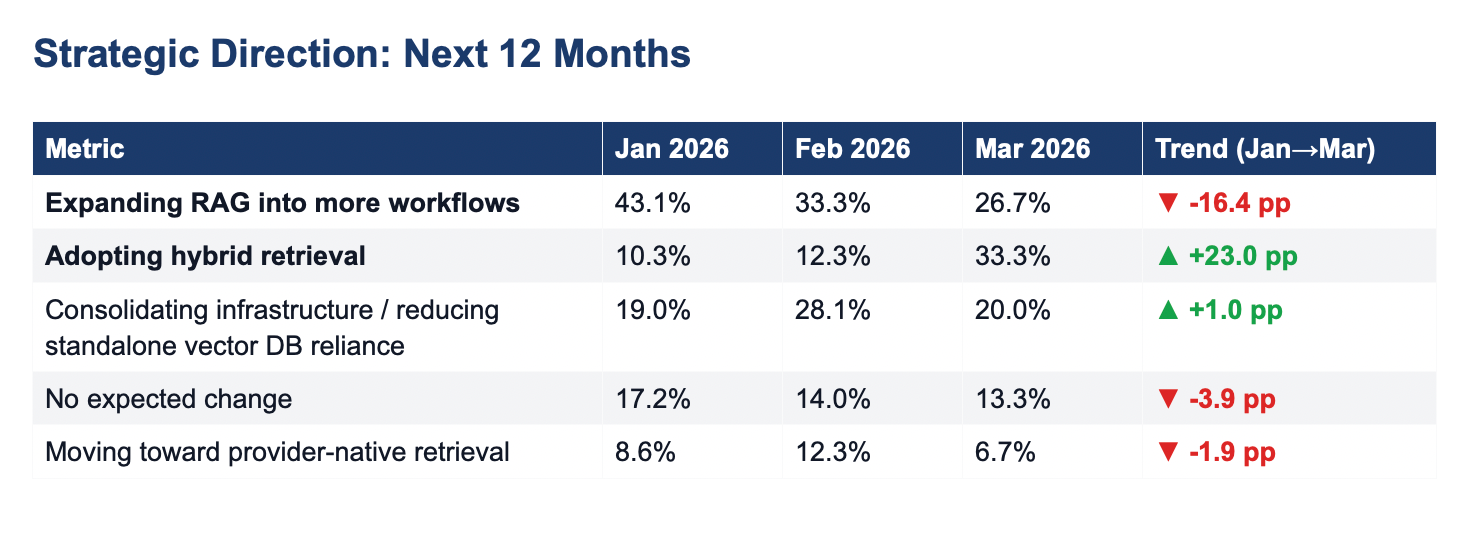
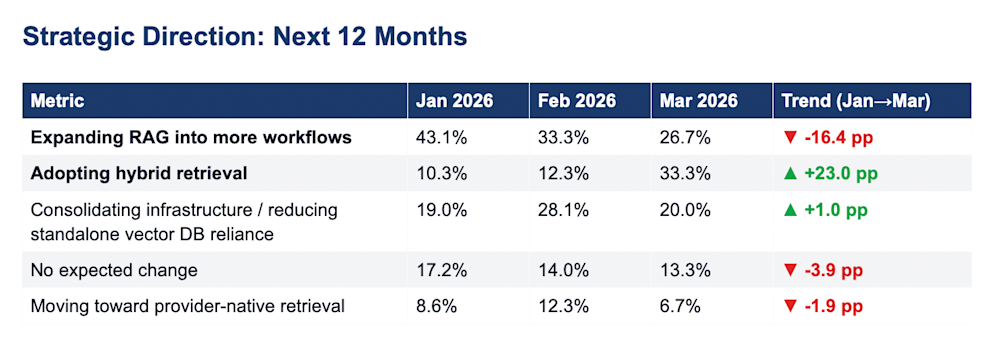
Намерение предприятий внедрить гибридное извлечение данных утроилось — с 10,3% до 33,3% всего за один квартал, несмотря на то, что 22% квалифицированных корпоративных респондентов сообщили об отсутствии у них каких-либо производственных систем RAG вообще. Для инженеров данных и корпоративных архитекторов, создающих инфраструктуру для агентного ИИ, эти данные демонстрируют рынок в состоянии активного перехода: та архитектура RAG, которую большинство предприятий построило для масштабирования, вовсе не та, которую они планируют использовать к концу года.
Источник: опрос VentureBeat Pulse
Гибридное извлечение стало общепризнанной корпоративной стратегией. В отличие от однометодичных конвейеров RAG, которые опираются исключительно на векторное сходство, гибридное извлечение объединяет плотные эмбеддинги (dense embeddings) со строчным поиском по ключевым словам и уровнями ранжирования (reranking), жертвуя простотой ради точности извлечения и контроля доступа, которые необходимы для рабочих нагрузок агентного ИИ в продакшене.
Категория автономных векторных баз данных находится под давлением. Согласно данным VB Pulse, такие решения, как Weaviate, Milvus, Pinecone и Qdrant, потеряли долю внедрения за этот квартал. Их долю поглощают кастомные стеки и встроенные средства извлечения от провайдеров.
Растущее меньшинство предприятий вообще отказывается от RAG — это знак того, что в нарративе о зрелости рынка есть существенные исключения.
Организации, которые масштабировали RAG в 2025 году, сталкиваются с одной и той же проблемой: архитектура, созданная для поиска документов, не выдерживает нагрузок при масштабировании агентных систем.
Предприятия, которые быстро масштабировали RAG, теперь платят за его перестройку
Два крупнейших изменения в намерениях в первом квартале тесно связаны между собой: предприятия столкнулись с проблемами качества извлечения данных в больших масштабах, а гибридное извлечение стало общепринятым ответом на эти вызовы.
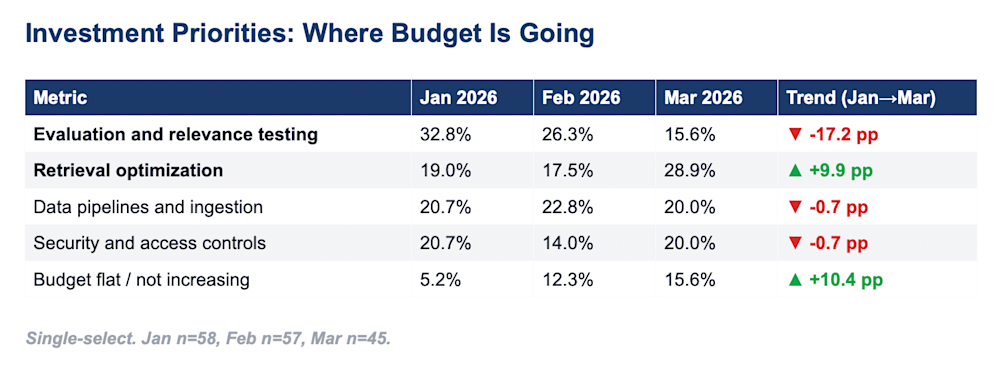
Инвестиционные приоритеты сместились параллельно. В январе лидировали оценка и тестирование релевантности (32,8% бюджета), но к марту этот показатель упал до 15,6%. Оптимизация извлечения данных двинулась в противоположном направлении — с 19,0% до 28,9%, впервые обогнав оценку в качестве ключевой инвестиционной зоны роста.
Источник: опрос VentureBeat Pulse
Стивен Диккенс (Steven Dickens), вице-президент и руководитель направления в HyperFRAME Research, в мартовском интервью VentureBeat, посвященном стеку данных Oracle для агентного ИИ, описал операционную нагрузку, с которой сталкиваются корпоративные команды по работе с данными. «Команды измотаны усталостью от фрагментации, — заявил Диккенс. — Управление отдельным векторным хранилищем, графовой базой данных и реляционной системой только ради обеспечения работы одного агента — это настоящий кошмар для DevOps».
Эта усталость наглядно отражена в данных по платформам. Рост доли кастомных стеков до 35,6% — это не отказ от управляемого извлечения данных (многие организации используют оба подхода одновременно), а ответ на необходимость консолидации со стороны инженерных команд, которые исчерпали лимиты при сборке избыточного количества компонентов.
Правда, далеко не каждое предприятие зашло так далеко. Данные VB Pulse содержат показатель, который усложняет общую картину роста рынка: 22,2% квалифицированных респондентов сообщили об отсутствии внедренных в продакшн систем RAG по состоянию на март (в январе этот показатель составлял 8,6%). Отчет относит эту группу к организациям, которые «еще не вложились в инфраструктуру извлечения или приостановили свои программы». Они сосредоточены в таких секторах, как здравоохранение, образование и государственное управление — именно в этих сферах фиксируются самые высокие показатели неизменных бюджетов.
Автономные векторные базы данных проигрывают в популярности, но выигрывают в надежности
Недавние публикации VentureBeat показывают, почему специализированный уровень извлечения по-прежнему важен в продакшене.
Два предприятия, строящие свои системы на базе Qdrant, демонстрируют, почему специализированная векторная инфраструктура сохраняет лидерство в рабочей среде.
&AI создает инфраструктуру для судебных разбирательств по патентам и осуществляет семантический поиск по сотням миллионов документов. Обоснование каждого результата реальным исходным документом здесь не просто опция — патентные поверенные не станут действовать на основе текста, сгенерированного ИИ. Это требование предопределяет выбор архитектуры.
«Агент — это интерфейс, — рассказал в марте VentureBeat Херби Тернер (Herbie Turner), основатель и технический директор &AI. — А векторная база данных — это первоисточник правды (ground truth)».
Другие опросы VB Pulse
GlassDollar, стартап, помогающий компаниям Siemens и Mahle оценивать стартапы, использует патент агентного извлечения данных для массива, насчитывающего около 10 миллионов индексированных документов. Один запрос пользователя распараллеливается на несколько потоков, каждый из которых извлекает кандидатов под разным углом, после чего результаты объединяются и переранжируются. Именно такой объем запросов и требования к точности обусловили выбор специализированной векторной инфраструктуры.
«Мы измеряем успех полнотой извлечения (recall), — сообщил в марте VentureBeat Камен Канев (Kamen Kanev), руководитель по продукту в GlassDollar. — Если лучших компаний нет в результатах, все остальное не имеет значения. Пользователь теряет доверие».
Данные VB Pulse показывают, что такой подход — восприятие извлечения как первоисточника истины, а не просто функции — набирает популярность на более широком корпоративном рынке, несмотря на снижение популярности автономных векторных баз данных.
Причины, по которым предприятия заявляют о необходимости выделенного векторного слоя, значительно изменились за первый квартал. В январе главными факторами были сложность контроля доступа (20,7%) и точность извлечения (19,0%). К марту операционная надежность в больших масштабах вышла на первое место с показателем 31,1%, более чем удвоившись и обогнав все остальные критерии. Предприятия больше не сохраняют векторную инфраструктуру исключительно ради точности. Они держат ее потому, что это та часть стека, на которую можно положиться при масштабировании объемов запросов.
Как компании переосмысляют качественное извлечение данных
Критерии, по которым предприятия оценивают свои системы извлечения данных, заметно изменились в течение первого квартала, и вектор этих изменений указывает на то, что рынок становится более зрелым в понимании того, что на самом деле означает качественный поиск.
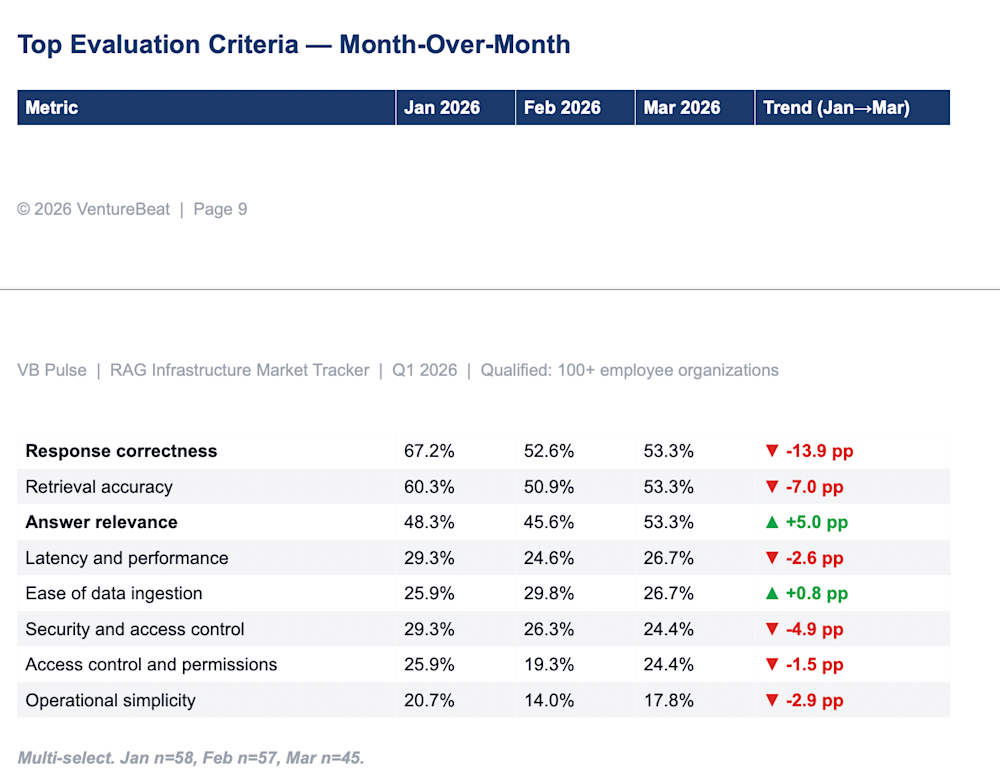
В январе в критериях оценки доминировала правильность ответов (67,2%), значительно опережая все остальное. К марту показатели правильности ответов (53,3%), точности извлечения (53,3%) и релевантности ответов (53,3%) сравнялись. Получить правильный ответ уже недостаточно, если он был извлечен не из того документа или вне контекста вопроса.
Релевантность ответа оказалась единственным критерием, продемонстрировавшим рост за квартал, прибавив пять процентных пунктов. Это также сложнейший для измерения параметр: чтобы понять, является ли извлеченный контекст действительно подходящим для конкретного вопроса, требуется специальная инфраструктура оценки, а не просто проверки по принципу «прошел/не прошел». Рост этого показателя сигнализирует о том, что значительная доля корпоративных покупателей уже полностью переросла базовое тестирование RAG.
Источник: опрос VentureBeat Pulse
Вердикт рынка: RAG не умер. Умерла его первоначальная архитектура
Теория о том, что «RAG мертв», имела серьезный импульс в преддверии 2026 года. Она опиралась на два утверждения. Первое: окна большой длины контекста (модели, способные обрабатывать сотни тысяч токенов за один запрос) сделают специализированный поиск ненужным. Второе: системы агентной памяти, которые сохраняют то, что агент узнает между сеансами, вместо повторного поиска с нуля, полностью решат проблему доступа к знаниям.
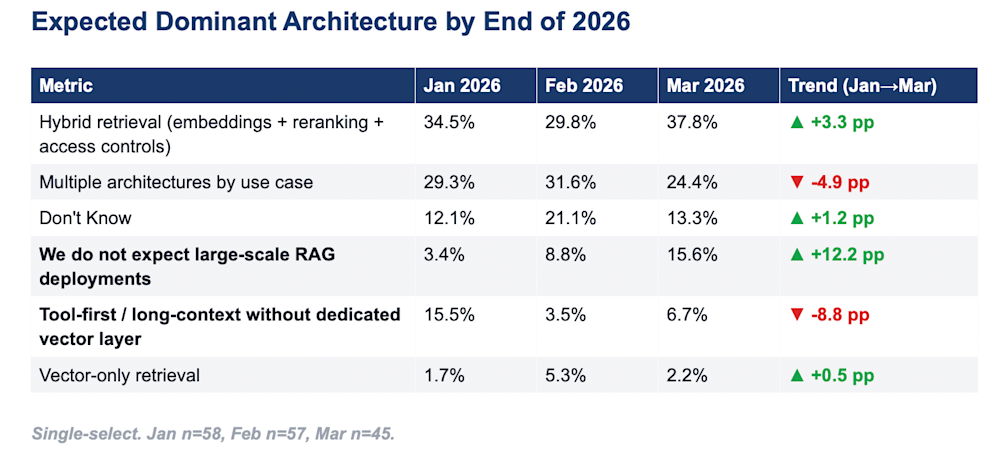
Данные VB Pulse — это ответ корпоративного рынка на первое утверждение. Концепция длинного контекста как доминирующей архитектуры обвалилась с 15,5% в январе до 3,5% в феврале с последующим частичным восстановлением до 6,7% в марте. Январская выборка была сильно смещена в сторону респондентов из сферы технологий и программного обеспечения — сегмента, наиболее подверженного анонсам моделей с длинным контекстом в конце 2025 года. По мере диверсификации выборки эта позиция испарилась.
Что касается проблемы памяти, Джонатан Франкл (Jonathan Frankle), главный научный сотрудник по искусственному интеллекту в Databricks, четко обрисовал архитектуру в мартовском интервью VentureBeat: в основе стека агентной памяти лежит векторная база данных с миллионами записей — она слишком велика, чтобы поместиться в контекст. Наверху располагается окно контекста языковой модели (LLM). Между ними возникают новые уровни кэширования и сжатия, но ни один из них не заменяет уровень извлечения в основании. Новые системы агентной памяти, такие как Hindsight (разработанная Vectorize), и подходы к наблюдательной памяти, подобные реализованным в фреймворке Mastra, решают задачи непрерывности сеансов и сохранения контекста агента с течением времени, что отличается от высокоточного поиска по миллионам изменяющихся корпоративных документов.
Самый показательный сигнал: доля респондентов, которые не рассчитывают на крупномасштабное развертывание RAG к концу года, выросла с 3,4% до 15,6% — почти в 5 раз. Это не приговор поиску как таковому. Это приговор той архитектуре извлечения данных, которую большинство предприятий построило в первую очередь.
Источник: опрос VentureBeat Pulse
Перестройка извлечения данных — это не опция
Масштабная перестройка поиска — это плата за масштабирование RAG без предварительного определения архитектуры, способной его поддержать.
Если ваша организация входит в те 43,1%, которые вступили в первый квартал с планами по расширению RAG на новые рабочие процессы, данные VB Pulse показывают, что у многих ваших коллег эти планы уже изменились, и, возможно, их придется пересмотреть вам. Гибридный поиск — это общепризнанный пункт назначения. Рост популярности кастомных стеков до 35,6% отражает тот факт, что команды создают инфраструктуру извлечения под требования, которые готовые продукты не покрывают полностью.
RAG не мертв. Мертва та архитектура, которую большинство предприятий использовали для его внедрения. Данные показывают, что перестройка — это не решение на будущее. Для 33% предприятий перестройка уже стала заявленным приоритетом.




