


Oracle объединяет стек данных ИИ, чтобы предоставить корпоративным агентам единый источник достоверной информации
Источник: VentureBeat · Sean Michael Kerner


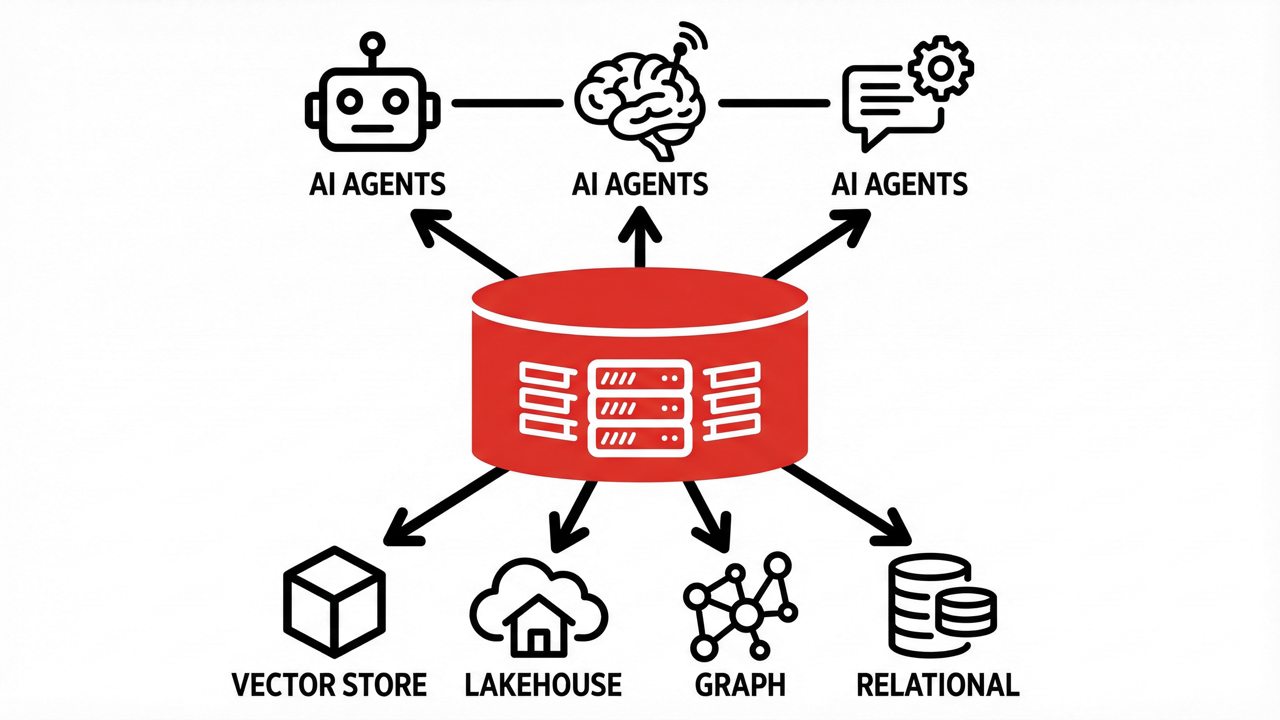
Корпоративные команды по работе с данными, внедряющие агентный ИИ в продакшн, сталкиваются с постоянной точкой сбоя на уровне данных. Агентам, созданным на стыке векторного хранилища, реляционной базы данных, графовой базы и озера данных (lakehouse), требуются конвейеры синхронизации для поддержания актуальности контекста. При рабочей нагрузке этот контекст устаревает.
Компания Oracle, чья база данных обслуживает транзакционные системы 97% компаний из списка Fortune Global 100 по собственным подсчетам компании, теперь выступает с прямым архитектурным аргументом в пользу того, что именно база данных является подходящим местом для решения этой проблемы.
На этой неделе Oracle анонсировала набор функций агентного ИИ для Oracle AI Database, созданный в рамках прямого архитектурного противовеса этой схеме.
Ядром этого релиза является Unified Memory Core (единое ядро памяти) — единый ACID (атомарность, согласованность, изолированность, долговечность)-транзакционный движок, который обрабатывает векторные, JSON-, графовые, реляционные, пространственные и колончатые данные без слоя синхронизации. Кроме того, Oracle анонсировала Vectors on Ice для нативной векторной индексации в таблицах Apache Iceberg, автономный сервис Autonomous AI Vector Database и сервер Autonomous AI Database MCP для прямого доступа агентов без написания пользовательского интеграционного кода.
Новость заключается не только в том, что Oracle добавляет новые функции, а в том, что крупнейший в мире разработчик баз данных осознал: в мире ИИ произошли изменения, выходящие за рамки возможностей его флагманской СУБД.
«Как бы сильно мне ни хотелось сказать вам, что сегодня все хранят все свои данные в базе данных Oracle — мы с вами живем в реальном мире, — рассказала VentureBeat Мария Колган (Maria Colgan), вице-президент по управлению продуктами для критически важных данных и ИИ-движков в Oracle. — Мы понимаем, что это не так».
Четыре функции, одна архитектурная ставка против фрагментированного стека агентов
Релиз Oracle охватывает четыре взаимосвязанные возможности. Вместе они формируют архитектурный тезис о том, что конвергентный движок базы данных — это лучшая основа для продакшн-агентного ИИ, чем стек специализированных инструментов.
Unified Memory Core. Агентам, выполняющим рассуждения одновременно по нескольким форматам данных (векторным, JSON, графовым, реляционным, пространственным), требуются конвейеры синхронизации, когда эти форматы находятся в разных системах. Unified Memory Core объединяет их все в едином ACID-транзакционном движке. Под капотом это уровень API поверх движка базы данных Oracle, а это значит, что согласованность ACID применяется к каждому типу данных без использования отдельного механизма согласованности.
«Благодаря тому, что память находится там же, где и данные, мы можем контролировать то, к чему она имеет доступ, точно так же, как мы контролируем данные внутри базы данных», — пояснила Колган.
Vectors on Ice. Для команд, использующих архитектуры lakehouse на базе открытого табличного формата Apache Iceberg, Oracle теперь создает векторный индекс внутри базы данных, который напрямую ссылается на таблицу Iceberg. Индекс обновляется автоматически по мере изменения базовых данных и работает с таблицами Iceberg, управляемыми Databricks и Snowflake. Команды могут объединять векторный поиск Iceberg с реляционными, JSON-, пространственными или графовыми данными, хранящимися в Oracle, в рамках одного запроса.
Autonomous AI Vector Database. Полностью управляемый бесплатный векторный сервис баз данных, созданный на базе движка Oracle 26ai. Сервис разработан как точка входа для разработчиков с возможностью перехода в один клик к полноценной Autonomous AI Database при росте требований к нагрузке.
Autonomous AI Database MCP Server. Позволяет внешним агентам и MCP-клиентам подключаться к Autonomous AI Database без написания пользовательского интеграционного кода. Средства контроля доступа на уровне строк и столбцов от Oracle применяются автоматически при подключении агента, независимо от его запросов.
«Несмотря на то, что вы делаете тот же стандартный вызов API, который делали бы с другими платформами, права этого пользователя продолжают действовать, когда LLM задает эти вопросы», — отметила Колган.
Автономные векторные базы данных — это отправная точка, а не конечный пункт
Autonomous AI Vector Database от Oracle выходит на рынок, который занимают специализированные векторные сервисы, включая Pinecone, Qdrant и Weaviate. Разница, на которую указывает Oracle, заключается в том, что происходит, когда векторов становится недостаточно.
«Когда с векторами покончено, у вас практически нет выбора, — рассказал VentureBeat Стив Зиванич (Steve Zivanic), глобальный вице-президент по продуктовому маркетингу баз данных и автономных сервисов в Oracle. — С этим решением вы получаете граф, пространственные данные, временные ряды — все, что вам может понадобиться. Это не тупик».
Хольгер Мюллер (Holger Mueller), главный аналитик Constellation Research, считает, что этот архитектурный аргумент заслуживает доверия именно потому, что другие вендоры не могут привести его, не выполнив предварительного перемещения данных. Другим поставщикам баз данных требуется перенос транзакционных данных в озеро данных, прежде чем агенты смогут выполнять по ним рассуждения. По его мнению, конвергентное наследие Oracle дает ей структурное преимущество, которое трудно воспроизвести без переписывания с нуля.
Не все считают данный набор функций уникальным. Стивен Диккенс (Steven Dickens), генеральный директор и главный аналитик HyperFRAME Research, заявил VentureBeat, что векторный поиск, интеграция RAG и поддержка Apache Iceberg стали стандартными требованиями для корпоративных баз данных — Postgres, Snowflake и Databricks предлагают сопоставимые возможности.
«Шаг Oracle по присвоению самой базе данных статуса ИИ-базы данных — это главным образом ребрендинг ее стратегии конвергентных баз данных в соответствии с текущим хайп-циклом», — считает Диккенс. По его мнению, реальное отличие, на которое претендует Oracle, кроется не на уровне функций, а на архитектурном уровне, и именно Unified Memory Core — это то место, где этот аргумент либо подтверждается, либо рушится.
Где на самом деле происходят сбои в развертывании корпоративных агентов
Четыре функции, выпущенные Oracle на этой неделе, являются ответом на конкретный и хорошо задокументированный тип сбоев в продакшне. Развертывания корпоративных агентов дают сбой не на уровне моделей. Они ломаются на уровне данных, где агенты, созданные на базе фрагментированных систем, по мере масштабирования нагрузок сталкиваются с задержками синхронизации, устаревшим контекстом и несогласованным контролем доступа.
Мэтт Кимбалл (Matt Kimball), вице-президент и главный аналитик Moor Insights and Strategy, сообщил VentureBeat, что именно уровень данных является той областью, где в первую очередь проявляются ограничения продакшна.
«Сложность заключается в их запуске в продакшне, — сказал Кимбалл. — Разрыв становится заметен практически сразу на уровне данных: доступ, управление, задержки и согласованность. Все это превращается в ограничения».
Диккенс определяет основное несоответствие как проблему без сохранения состояния (stateless) против сохранения состояния (stateful). Большинство платформ корпоративных агентов хранят память как плоский список прошлых взаимодействий, что означает, что агенты фактически не имеют состояния, в то время как запрашиваемые ими базы данных состояние сохраняют. Именно из-за разрыва между ними и принимаются неверные решения.
«Команды по работе с данными истощены усталостью от фрагментации, — отметил Диккенс. — Управление отдельным векторным хранилищем, графовой базой данных и реляционной системой только ради работы одного агента — это кошмар для DevOps».
Именно эту фрагментацию призван устранить Unified Memory Core от Oracle. Вопрос плоскости управления следует за этим напрямую.
«В традиционной модели приложения управление находится на уровне приложений, — пояснил Кимбалл. — В агентных системах контроль доступа разрушается довольно быстро, поскольку агенты генерируют действия динамически и требуют последовательного соблюдения политик. Перенося весь этот контроль в базу данных, можно применять его более единообразно».
Что это значит для корпоративных команд по работе с данными
Вопрос о том, где находится контроль в стеке корпоративного агентного ИИ, пока не решен.
Большинство организаций по-прежнему строят решения на базе фрагментированных систем, и принимаемые сейчас архитектурные решения — какой движок закрепляет память агента, где обеспечивается контроль доступа, как данные из озера данных попадают в контекст агента — будет сложно отменить в масштабе.
Проблема распределенных данных по-прежнему остается главным испытанием.
«Данные все больше распределяются по SaaS-платформам, озерам данных и событийно-ориентированным системам, каждая из которых имеет собственную плоскость управления и модель говернанса, — сказал Кимбалл. — Возможность сейчас заключается в распространении этой модели на более широкие и распределенные массивы данных, которые определяют большинство современных корпоративных сред».




